把知识库建成一座图书馆:DDD 的思想、AI 的建法,和 RAG 到 GraphRAG 的省钱之路
Posted on 三 21 10月 2026 in Tech
| Abstract | 把知识库建成一座图书馆:DDD 的思想、AI 的建法,和 RAG 到 GraphRAG 的省钱之路 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-10-22 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 痛点:很多知识库是"书堆"不是"图书馆"——存量很大,可检索性为零
- DDD 是分类法:领域、上下文、实体、值对象、服务、模块,决定书怎么编目、怎么被找到
- AI 的两个角色:整理书架的馆员 vs 来借书的读者,两件事得分开治理
- 朴素 RAG:像只会按书名模糊搜的检索台,答得了"哪页讲了什么",答不了"整本在说什么"
- GraphRAG:建一张主题地图 + 社区摘要,补上全局问答,但离线建图太贵
- 省钱之路:动态社区选择、LazyGraphRAG 把建图挪到查询时,索引成本砍到千分之一
- 收口:结构先行,图是省出来的——先有好分类法,图才建得便宜
我见过不少团队的知识库,打开一看都挺壮观:几千篇文档、几百万字、Confluence 翻十页翻不到底。但你真去问一句“我们当年为什么决定用最终一致性而不是强一致”,没人答得上来——文档大概率是有的,只是没人知道它在哪一篇、哪一段。
这不是知识库,这是书堆。书堆和图书馆的区别只有一个字:编目。同样一百万册书,堆在仓库里是废纸,进了图书馆、上了架、编了号、做了索引,才叫馆藏。知识库的价值从来不在存了多少,在能不能被找到——而能不能被找到,取决于你有没有一套编目的章法。
这篇文章就讲这件事,用图书馆当贯穿的比方:
- DDD 给的是分类法——领域、上下文、实体、服务,决定一本书该摆哪个区、挂什么标签;
- AI 扮两个角色——整理书架的馆员,和来借书的读者,这两件事必须分开治理;
- 检索这头从 RAG 到 GraphRAG——朴素 RAG 是个只会按书名模糊搜的检索台,GraphRAG 给图书馆加了张主题地图,而怎么让这张地图别贵得离谱,是最近一年真正的进展。
一句话立在前面:知识库的可检索性来自结构,而结构这件事,AI 帮不了你拍板,只能帮你干活。
一、DDD 是图书馆的分类法,不是花架子
一座图书馆最值钱的东西不是书,是那套分类法——杜威十进制也好、中图法也好。它规定了“计算机类”下面怎么分、一本讲数据库的书该挂几个标签、读者顺着哪条路能摸到它。没有分类法,书再多也是书堆。
知识库缺的就是这套分类法。而 DDD(Domain-Driven Design,领域驱动设计)——Eric Evans 2003 年那本书里那套东西——本质上就是一套为"领域知识"设计的分类法。它分两层,正好对应图书馆的两级编目。
战略设计:先划分区,再定区与区怎么挨着
图书馆先分大区:文学区、科技区、少儿区。DDD 的战略设计干的是同一件事——把一个大领域切成几块人能理解的区域:
| DDD 概念 | 图书馆里的对应 | 它定了什么 |
|---|---|---|
| Bounded Context(限界上下文) | 一个独立的书区 | 领域切成哪几块,每块的边界在哪 |
| Ubiquitous Language(统一语言) | 全馆统一的著录用词 | 同一个词,各区指的是不是同一样东西 |
| Context Map(上下文映射) | 区与区之间的指引牌 | 两个区怎么对接(翻译、上下游、共享) |
| Subdomain(子域) | 核心馆藏 vs 普通馆藏 | 哪块是你的立身之本,哪块是通用货架 |
这里 bounded context 的关键是“边界内术语自洽”——科技区的“Python”指编程语言,少儿区的“Python”可能指那条蟒蛇,同一个词跨区就得重新理解。这正是大组织里最常见的沟通事故:两个团队用同一个词,指的根本不是一回事。统一语言就是强迫大家先把词对齐。
战术设计:一本书内部怎么著录
分完区还不够。读者要的往往不是“给我文学区所有书”,而是“我要找那个讲时间旅行、主角是物理学家的故事”。这就需要对每一本书内部做更细的著录——DDD 的战术设计干的就是这个,它描述一个上下文内部的模型由什么构成:
| 战术概念 | 著录的是什么(领域含义) | 不著录什么(留给实现) |
|---|---|---|
| Entity(实体) | 有身份、有生命周期的东西:身份怎么认、不变式是什么 | 字段、类名、存储 schema |
| Value Object(值对象) | 没身份、靠值相等的东西:含义和校验规则 | 具体类型、序列化 |
| Aggregate(聚合) | 一组对象的一致性边界,谁是入口 | 事务怎么实现 |
| Domain Service(领域服务) | 不属于任何实体的核心操作:承载哪条规则、协调哪些实体 | XxxService 类怎么写 |
| Module(模块) | 上下文内部按内聚度的切分 | 包结构、目录 |
| Domain Event(领域事件) | 领域里“发生了某件事”的事实 | 消息格式、topic |
这张表藏着一条判据,也是整套分类法的命门:只著录领域含义,不著录实现。 实体著录“身份和不变式”,不著录它在代码里长什么样;领域服务著录“这个操作在业务上意味着什么”,不著录那个 Service 类的方法签名。著录是给人和 AI 找书用的卡片,不是书本身——真要看实现,卡片上留一个指针,指向代码仓库那本“书”。
我要特别点两个最容易被漏掉的著录项,因为漏了它们,分类法就残了:
- Domain Service(领域服务):很多人建知识库只建“名词世界”——实体、值对象列了一堆,却没有“动词”。可领域的核心逻辑常常恰恰在动词里。“呼叫转移”这个操作横跨 caller、callee、session,不属于任何单个实体,它的业务规则(转移时所有权怎么变、失败怎么回退)是最该写进知识库的东西。只有名词没有动词的知识库,等于一座只编了书名、没写内容简介的图书馆。
- Module(模块):它和 bounded context 容易混,但不是一回事——context 是区的边界,module 是区内部把书架再分的货架。缺了它,一个大上下文内部就是一张平铺的几百行对象表,读者一眼望不到头,抓不住结构。
还有一个我格外看重的编目维度,介于战略和战术之间:Critical User Journey(关键用户旅程)。它顺着一个用户目标从头走到尾——谁发起、要达成什么、走哪几步、成功长什么样、失败怎么回退。它的价值是给“影响”一把尺子:一个改动或一次故障重不重要,看它打断了哪几条关键旅程。 这相当于图书馆的“主题书单”——不按分区,而按“读者想干成的一件事”把跨区的书串起来。
DDD 不是设计模式的集合,是一套编目的章法。 它逼你在存书之前先想清楚:这本书属于哪个区、用什么词著录、和哪些书是一个主题。
二、AI 的两个角色:整理书架的馆员,和来借书的读者
想清楚了分类法,下一个问题是:AI 在这座图书馆里是什么身份? 这个问题不分清,治理就会乱套。
AI 其实扮两个完全不同的角色,对应图书馆里两种人:
角色一:整理书架的馆员(建库、维护)。 新书来了要著录、要上架;发现某本书分类错了要挪;两本书内容打架了要标记。这是写知识库。
角色二:来借书的读者(检索、使用)。 带着一个问题进馆,要快速找到该看哪几本、哪几页,而不是把整个书库搬回家。这是读知识库,也是后面 RAG/GraphRAG 要解决的事。
这两个角色的治理标准天差地别,混在一起是很多 AI 知识库翻车的根源。
当馆员:AI 可以干 90%,但不能盖“已审核”的章
让 AI 当馆员,好处是它快、不嫌烦、能把几百篇文档的术语对齐、能发现“这页说三次重试、那页说五次”的漂移。但图书馆有条铁律:馆员可以整理、可以上架、可以建议下架,但不能自己决定一本书是不是“权威版本”。 那是馆长(领域专家)的职责。
落到知识库上,就是一条可执行的分工:
| 这件事 | AI(馆员)干什么 | 人(馆长)定什么 |
|---|---|---|
| 新文档/新设计进来 | 著录、上架、起草一条带出处的条目 | 确认它是不是改变了领域含义 |
| 代码或配置变了 | 判断领域规则有没有真的变,只改受影响的条目 | 确认产品含义或所有权有没有变 |
| 两处说法打架 | 把冲突和各自的出处、日期摆出来 | 裁定哪条是当前权威 |
| 要动“权威版本” | 只能起草一份提案 | 明确点头才生效 |
关键的硬约束就两条,缺一不可:
- AI 写或改过的条目,一律标成“待审”(pending),绝不自己盖“已审核”的章。 这不是客气,是防止知识库里混进没人验证过的 AI 生成内容——那是比没有知识库更危险的东西。
- “权威层”(foundation,人类拍板的决策和业务规则)AI 不许原地改。 要改只能提案,人审了才落地。
我见过太多“文档即代码、全自动生成”的实践,走到最后变成“AI 疯狂产出、没人敢信、越攒越乱”。根子就在于没把这两个角色分开——让馆员行使了馆长的权力。AI 能把脏活累活干到九成,但最后那一成“这是不是事实”的判断,必须是人,而且得留下谁审的痕迹。 知识库的可信不靠生成速度,靠审批留痕。
当读者:别把整个书库搬回家
AI 当读者时最容易犯的错,是把图书馆当成自己家书房——进门就想把所有书抱走再慢慢翻。对 LLM 来说,这叫“把整棵文档树塞进上下文”,token 烧光不说,还淹没重点。
好读者的习惯是:先查目录卡片,锁定三五本,再翻到具体那几页。 这恰恰是检索(Retrieval)要解决的问题,也是下半篇的主角。而检索做得好不好,又回头依赖馆员有没有按分类法把书编好目——结构先行,检索才有的查。
三、朴素 RAG:一个只会按书名模糊搜的检索台
读者进馆要借书,靠的是检索台。知识库给 AI 用的检索台,这几年的主流方案叫 RAG(Retrieval-Augmented Generation,检索增强生成)。
朴素 RAG 的做法,翻译成图书馆的话是这样的:
- 切卡片(chunking):把每本书撕成一页一页,每页做成一张卡片。
- 编码(embedding):给每张卡片算一个“语义坐标”——意思相近的卡片,坐标也相近。这相当于不按书名、而按“内容大意”给卡片排座位。
- 查询:读者问一个问题,也算出它的语义坐标,然后在卡片堆里找坐标最近的几张(向量检索),把这几张卡片连同问题一起交给 LLM 生成答案。
这套东西解决了一个真问题:它能按"意思"找,而不只按"字面"找。 你问“系统崩了怎么恢复”,它能找到那张写着“故障切换流程”的卡片,哪怕两者没有一个共同的字。相比传统的关键词搜索,这是实打实的进步。
但朴素 RAG 有个结构性的短板,用图书馆比方一下就清楚:它只会一张一张地找卡片,脑子里没有"整本书讲什么"、更没有"整个馆藏在说什么"的概念。
| 问题类型 | 图书馆里的问法 | 朴素 RAG 行不行 |
|---|---|---|
| 具体事实 | “第 42 页讲的重试上限是多少?” | ✅ 行,这就是它的强项——找到那张卡片 |
| 局部综合 | “这本书的第三章大致讲了什么?” | ⚠️ 勉强,取决于章节内容能不能塞进几张卡片 |
| 全局主题 | “整个科技区今年的主旋律是什么?” | ❌ 不行,没有哪张单独的卡片写着“主旋律” |
最后那一类——全局性、需要综合整个语料才能回答的问题——是朴素 RAG 的死穴。微软 GraphRAG 论文里给的典型例子是“这个数据集的主要主题是什么”:答案不在任何一张卡片上,它散落在成千上万张卡片的关系里。你让一个只会按坐标找最近邻的检索台去回答“主旋律”,它只能抓几张碰巧坐得近的卡片,拼出一个以偏概全的答案。
说白了,朴素 RAG 给了你一个很聪明的检索台,但没给你一张馆藏地图。 读者能借到单本书,却看不懂这座图书馆整体在讲什么。
四、GraphRAG:给图书馆加一张主题地图
微软 2024 年 4 月那篇 GraphRAG 论文(From Local to Global: A Graph RAG Approach to Query-Focused Summarization,Edge 等,arXiv:2404.16130),解决的正是“看不懂馆藏整体”这个问题。它的思路,用图书馆比方非常顺:光有卡片不够,得再画一张主题地图。
它分两个阶段,第一个阶段是离线建图:
- 抽实体和关系:用 LLM 把每张卡片读一遍,把里面的人、物、概念(实体)和它们之间的关系抽出来。比如从“呼叫转移会改变会话所有权”里,抽出“呼叫转移”“会话”“所有权”三个实体和它们的关系。
- 拼成知识图谱:把所有卡片抽出的实体关系拼成一张大图——节点是实体,边是关系。这张图就是馆藏的“骨架”。
- 社区检测(community detection):用 Leiden 算法把这张图切成一簇一簇紧密相连的“社区”,而且是分层的——底层是细小的主题簇,往上逐层合并成大主题。这相当于图书馆的“主题分区地图”,从“WebRTC 信令”这种细主题,一直聚到“实时通信”这种大主题。
- 逐层写社区摘要:让 LLM 给每一层的每一个社区写一段自然语言摘要,自底向上——小社区的摘要喂给大社区。最后你得到一套分层的“这个主题簇在讲什么”的现成概述。
第二个阶段是查询时的 map-reduce:读者问一个全局问题,GraphRAG 不去翻原始卡片,而是:
- Map(分发):拿出相关那一层的所有社区摘要,让 LLM 对每个摘要生成一个“局部答案”并打个相关分;
- Reduce(归并):把局部答案按分数排序、拼起来,让 LLM 综合出最终答案。
效果是实打实的:在百万 token 量级的语料上,对“主旋律是什么”这类全局问题,GraphRAG 在答案的全面性和多样性上,相对朴素向量 RAG 有 70%~80% 左右的胜率(论文给的是全面性 72%~83%、多样性 62%~82%)。因为它查的是现成的主题地图,而不是现抓几张卡片硬拼。
但这张地图有个让人肉疼的代价:建图太贵。
你回头看第一阶段——它要用 LLM 把每一张卡片都读一遍抽实体关系,再给每一层的每一个社区都写摘要。语料有一百万 token,这一遍遍的 LLM 调用就是天文数字的 token 账单。更糟的是,这笔钱是离线预付的:读者还没问任何问题,你就得先把整张地图、所有层级的摘要全建出来。很多团队一算这笔账就劝退了——地图是好地图,可画不起。
这就是 GraphRAG 的核心矛盾:查图很省,建图很贵。 省在查询时查现成摘要,贵在离线时无差别地把整个馆藏啃一遍。接下来的演进,全是围着这一个矛盾打转。
五、省钱之路:建图别那么早、别那么全
降 GraphRAG 的成本,思路其实就一句图书馆的大白话:没人借的书区,先别急着画详图。 顺着这句话,业界走出了两条互补的路。
路线一:查询时只点亮用得着的那片地图(动态社区选择)
全量 GraphRAG 的 map 阶段有个浪费:读者问一个问题,它把那一层所有社区的摘要都拿去让 LLM 过一遍生成局部答案——哪怕九成社区跟这个问题八竿子打不着。这就像读者问“量子计算”,馆员却把整个科技区每个货架的简介都念一遍。
微软 2025 年 1 月给 GraphRAG 加的动态社区选择(Dynamic Community Selection)就是来堵这个浪费:先把每个社区摘要也做成语义坐标,读者的问题进来,先用坐标比一比,只挑最相关的 top-k 个社区进入 map 阶段。相当于馆员先看一眼读者要哪个主题,只走到那几个货架前,别的货架不碰。这一步不动建图成本,但把查询成本砍下来一大截。
路线二:把建图整个推迟到查询时(LazyGraphRAG)
真正釜底抽薪的是微软后来的 LazyGraphRAG。它的名字里那个 Lazy(惰性、拖延)就是精髓——能拖到查询时再做的,绝不在建图时做。
回想全量 GraphRAG 贵在哪:离线时用 LLM 把每张卡片读一遍、给每个社区写摘要。LazyGraphRAG 的狠招是——建图这一步,一个 LLM 都不调用:
- 建图时只做两件便宜事:给卡片算语义坐标(和朴素 RAG 一样),再用纯传统 NLP(抽名词短语、统计共现)拼出一张“概念图”,社区检测照跑。整个过程没有一次 LLM 生成。
- LLM 的活全部挪到查询时,而且只在读者这个具体问题真正碰到的那片区域上干活——没人问到的馆藏,永远不花钱去写摘要。
这么一挪,账单变了个天:LazyGraphRAG 的索引(建图)成本和朴素向量 RAG 一样,只有全量 GraphRAG 的千分之一(0.1%),而在相当的查询成本下,全局问答质量能追上甚至超过全量 GraphRAG 的 global search。
用图书馆收个口,这条省钱之路就是三句话:
| 做法 | 图书馆比方 | 成本变化 |
|---|---|---|
| 全量 GraphRAG | 开馆前把每本书读完、画好全馆详图 | 建图极贵,查图很省 |
| 动态社区选择 | 读者来了只走他要的那几个货架 | 建图不变,查图变省 |
| LazyGraphRAG | 开馆前只排座位,读者问到哪片才现场精读那片 | 建图砍到千分之一,省到查询时按需花 |
一句话:GraphRAG 这一年的进步,不是把地图画得更漂亮,是想明白了"大部分地图根本没人看"——于是别全画、别早画,等有人问再画他要的那一块。
六、把两条线接上:结构先行,图是省出来的
讲到这里,上半篇的 DDD 和下半篇的 GraphRAG 其实是同一件事的两面,这里得点破。
GraphRAG 为什么建图那么贵?因为它面对的是一堆没有编目的卡片——它得用 LLM 从零把实体、关系、主题全抠出来,相当于让馆员对着一仓库没分类的书硬生生现编一套分类法。它贵,贵在替你补了你本该先做的编目工作。
而如果你的知识库从一开始就按 DDD 的分类法建好了呢?实体是什么、上下文边界在哪、哪些操作是领域服务、主题怎么分区——这些本来就是知识图谱的节点和边。 换句话说,一座编好目的图书馆,等于馆员已经手工画好了半张主题地图。 GraphRAG 不用从零抠图,它接手的是一个结构已经立住的语料,建图这步自然便宜得多、也准得多。
这就是整篇文章真正想说的那条暗线:
可检索性来自结构,而结构这件事只能人先拍板。 AI 是又快又勤快的馆员和读者,但图书馆的分类法——哪些是核心馆藏、同一个词在各区什么意思、哪本书属于哪个主题——得先由人用 DDD 的章法定下来。结构立住了,AI 建图才便宜,检索才查得准。
反过来,想靠 GraphRAG 这类工具“自动把一仓库烂文档变成好用的知识库”,基本是幻想。工具能帮你画地图,但画不出一座本来就没有分区逻辑的图书馆该有的样子。垃圾进,图谱出来也是垃圾,只是更贵的垃圾。
总结:知识库的价值不在存量,在可检索性
把这篇收成几句能带走的话:
- 知识库是图书馆,不是书堆。 值钱的不是存了多少,是能不能被找到;能不能被找到,取决于有没有编目。
- DDD 就是那套编目章法。 战略层划分区(上下文、子域、统一语言),战术层著录每本书(实体、值对象、领域服务、模块),一律只记领域含义、不记实现。
- AI 分两个角色治理。 当馆员(建库)干到九成、产出一律待审、权威层只提案;当读者(检索)别把整馆搬回家,先查目录再翻具体几页。
- 检索从 RAG 到 GraphRAG。 朴素 RAG 是个聪明检索台,答得了“哪页讲什么”,答不了“整体在讲什么”;GraphRAG 用图谱加社区摘要补上全局问答。
- GraphRAG 的省钱靠"别早画、别全画"。 动态社区选择省查询、LazyGraphRAG 把建图挪到查询时、索引成本砍到千分之一。
- 结构先行,图是省出来的。 先有 DDD 编好的分类法,图谱才建得便宜、查得准。
如果你正打算建或者重建一个知识库,别一上来就选向量库、调 GraphRAG 参数。先坐下来回答三个图书馆问题:
- 我这堆知识该分几个区(bounded context)?同一个词在各区是不是一个意思?
- 每个区里,有哪些该著录成领域服务的"动词"被我漏掉了?
- 哪些是我的核心馆藏,值得精编目、甚至人工画图谱?哪些是通用货架,粗放处理就行?
把这三个问题答好,你就已经手工画出了半张主题地图。剩下的交给 AI 和 GraphRAG——它们是很好的馆员和检索台,但当不了那个定分类法的馆长。
先建图书馆,再谈检索;先定分类法,再谈自动化。 顺序反了,存再多的书,也还是一座没人进得去的书堆。
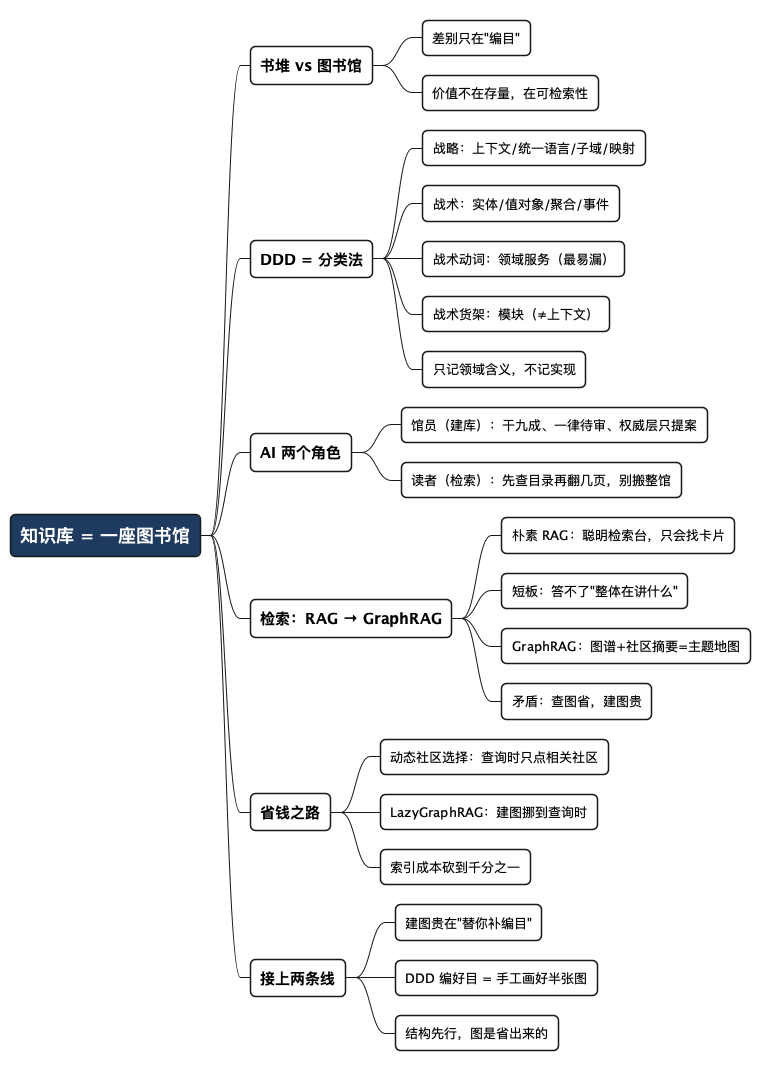
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* 知识库 = 一座图书馆
** 书堆 vs 图书馆
*** 差别只在"编目"
*** 价值不在存量,在可检索性
** DDD = 分类法
*** 战略:上下文/统一语言/子域/映射
*** 战术:实体/值对象/聚合/事件
*** 战术动词:领域服务(最易漏)
*** 战术货架:模块(≠上下文)
*** 只记领域含义,不记实现
** AI 两个角色
*** 馆员(建库):干九成、一律待审、权威层只提案
*** 读者(检索):先查目录再翻几页,别搬整馆
** 检索:RAG → GraphRAG
*** 朴素 RAG:聪明检索台,只会找卡片
*** 短板:答不了"整体在讲什么"
*** GraphRAG:图谱+社区摘要=主题地图
*** 矛盾:查图省,建图贵
** 省钱之路
*** 动态社区选择:查询时只点相关社区
*** LazyGraphRAG:建图挪到查询时
*** 索引成本砍到千分之一
** 接上两条线
*** 建图贵在"替你补编目"
*** DDD 编好目 = 手工画好半张图
*** 结构先行,图是省出来的
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。