让 Codex 和 Cursor 读写你的知识库:用 FastMCP 搓一个本地 MCP Server
Posted on 二 13 10月 2026 in Tech
| Abstract | 让 Codex 和 Cursor 读写你的知识库:用 FastMCP 搓一个本地 MCP Server |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-10-13 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 痛点:agent 要么看不见知识库,要么拿着全量权限乱 grep 乱写,全量和零权限一样糟
- 为什么选 MCP 不选 CLI:三个客户端、写护栏要收进 server,不在 prompt 里
- 柜台背后:一个普通的 Sphinx + MyST + Mermaid 知识库,Markdown 是唯一事实源
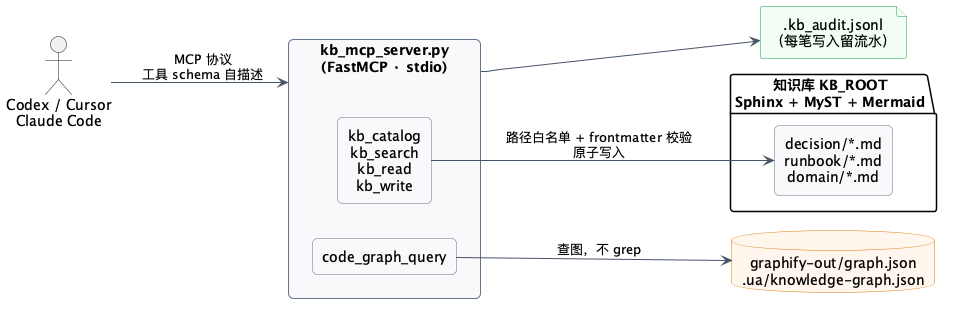
- 柜台设计:五个工具,少而正交,返回必须带路径
- 代码:kb_mcp_server.py 全文,FastMCP 4.1.0 上逐工具验证
- 接线:Codex、Cursor、Claude Code 三家的配置片段
- 写护栏:白名单、校验、原子写、审计、不提供删除;防呆不防贼
- 代码图上柜台:graphify 常挂当免费地图,Understand-Anything 按需当贵导游
- 边界与升级:stdio 之外、grep 之外、单仓库之外
你在 Codex 里问一句:“我们当年的重试策略,为什么上限定在 3 次?”它沉默两秒,开始 grep 当前仓库。因为它根本不知道你的知识库在哪儿——那是一套用 Sphinx + MyST 建的 Markdown,在另一个目录里躺了好几年,make html 一跑就是一个能看的站点,但 agent 连门都没摸到。
把知识库挪进工作目录?更糟。agent 一头扎进去 grep,三十个文件读五个,token 烧掉几十万;写起来更是吓人——它拿着全量文件权限直接改你的 .md,顺手把 Mermaid 图改出一朵语法错误的云,你不 build 一遍都不知道。
我的观点是一句话:别把仓库钥匙整个交给 agent,给它开个柜台。 搜索、读、写,都到柜台上办——路径有白名单,写入有校验,每笔操作留流水。MCP(Model Context Protocol)就是干这个的协议,而用 Python 的 FastMCP,这个柜台一百多行代码就能开张:本地 stdio 直连,不部署任何服务,Codex、Cursor、Claude Code 一家配一份配置就都能用。
这篇给的就是这套最简方案。知识库那一侧是最普通的 Sphinx + MyST + Mermaid/PlantUML;柜台这一侧是五个工具;最后再把 graphify、Understand-Anything 这类代码分析工具产出的知识图谱也挂上柜台,让 agent 查图,别 grep。文末的代码可以整段抄走。
一、全量权限和零权限,一样糟
agent 访问知识库,常见的两种境遇都不对:
| 境遇 | 表面 | 实际 |
|---|---|---|
| 看不见(知识库不在工作目录) | 安全 | 知识等于不存在,agent 只能靠参数里的旧知识瞎编 |
| 全看见(知识库在工作目录,文件工具全开) | 方便 | grep 海底捞针烧 token;写入无校验、无审计、无底线 |
第一种好理解。第二种值得多说一句:agent 自带的文件读写工具是“通用”的,它不理解你的 frontmatter 规范,不知道哪些目录能动哪些不能,更不会在写完之后告诉你它改了什么。权限给了,约束没了。
我之前写过一篇对比 MCP 和 CLI 两条路,结论是对内单机 CLI 也够用。这次我还是选了 MCP,理由有三:
- 客户端是三家,不是一家。 Codex、Cursor、Claude Code 各有各的 shell 习惯,给每家写一版 CLI 用法说明,成本比一个 MCP server 高。
- 工具 schema 是自描述的。
@mcp.tool装饰器下的函数签名和 docstring 会变成协议里的工具描述,agent 不用猜参数怎么传;CLI 的--help得靠它自己去读。 - 写护栏要收在 server 里,不能散在 prompt 里。 路径校验、frontmatter 检查、审计日志,写进代码就是硬约束;写在 prompt 里就是贴在墙上的标语。
二、柜台背后:一个再普通不过的 Sphinx 知识库
柜台背后不需要任何特殊设施,一套标准 Sphinx 就行:
kb/
├── docs/                  # KB_ROOT:唯一事实源,全是 .md
│   ├── conf.py            # Sphinx 配置
│   ├── index.md
│   ├── decision/          # 决策与取舍(为什么这么定)
│   ├── runbook/           # 操作手册(怎么干)
│   ├── domain/            # 业务与领域知识(只有我们知道的事)
│   └── reading/           # 读书与论文笔记
├── _build/                # make html 的产物,可重建,不进 git
├── Makefile               # make html / make clean
└── AGENTS.md              # 告诉 agent:查库请走 kb_* 工具
conf.py 里关键的就这么一行:
extensions = ["myst_parser", "sphinxcontrib.mermaid", "sphinxcontrib.plantuml"]
每篇文档是一张带 frontmatter 的卡片:
---
title: 为什么我们的重试上限定在 3 次
type: decision
status: current
updated: 2026-10-13
---
# 为什么我们的重试上限定在 3 次

下游 P99 已经 800ms,3 次重试叠加退避,最坏情况把调用方拖到超时线之外……

```mermaid
flowchart LR
    A[调用失败] --> B{第几次?}
    B -- "≤3" --> C[退避后重试]
    B -- ">3" --> D[熔断]
两个要点,都是老规矩:**Markdown 源文件是唯一事实源,`_build` 删了能一条命令长回来**——这套分层我在[知识库工作流](./2026-08-31-knowledge-base-workflow.html)那篇里详细写过;**`make html` 就是知识库的编译器**,Mermaid 代码块写坏了、内链断了,build 的时候全会暴露。这个性质后面有用。
## 三、柜台设计:五个工具,少而正交
| 工具 | 输入 | 输出 | 护栏 |
|---|---|---|---|
| `kb_catalog` | 无 | 全部文档的路径 + frontmatter 摘要 | 只读 |
| `kb_search` | 正则、条数上限 | `文件:行号: 摘要` | 只读,上限 50 条 |
| `kb_read` | 相对路径 | 整篇原文 | 路径白名单,只 `.md` |
| `kb_write` | 路径、内容、事由 | 成功或明确的拒绝理由 | 校验 frontmatter,原子写,留审计,不删 |
| `code_graph_query` | 自然语言问题 | 代码知识图谱的查询结果 | 只调本地 CLI,30 秒超时 |
设计上就两条原则:
**工具要少而正交。** 每加一个工具,agent 的选择空间就大一分,选错的概率也大一分。五个工具对应五个动作:看目录、找、读、写、查代码图,没有第七个动作的位置。
**返回必须带路径。** 搜索结果的每一条都落在具体文件的具体行上,读出来的内容自带出处。**不给路径的答案不算答案**——这一条能把大部分幻觉挡在门口,因为 agent 接下来要引用时,必须先去读原文。
## 四、开张:一百多行代码
先装 FastMCP(Python 3.10+):
```console
$ pip install fastmcp
然后是柜台本身,完整代码:
# kb_mcp_server.py —— 知识库柜台:catalog / search / read / write / 代码图查询
import json
import os
import re
import subprocess
from datetime import datetime, timezone
from pathlib import Path

from fastmcp import FastMCP

KB_ROOT = Path(os.environ.get("KB_ROOT", "~/kb/docs")).expanduser().resolve()
CODE_ROOT = Path(os.environ.get("CODE_ROOT", KB_ROOT)).expanduser().resolve()
AUDIT_LOG = KB_ROOT.parent / ".kb_audit.jsonl"
ALLOWED_SUFFIX = ".md"
ALLOWED_GLOB = "*.md"
MAX_WRITE_BYTES = 200_000
VALID_STATUS = ("current", "draft", "superseded")
REQUIRED_META = ("title", "type", "status", "updated")

FRONTMATTER_RE = re.compile(r"\A---\s*\n(.*?)\n---\s*\n", re.DOTALL)

mcp = FastMCP("kb")


def safe_path(rel: str) -> Path:
    """把 agent 给的路径关进 KB_ROOT,出界或非 .md 一律拒绝。"""
    p = (KB_ROOT / rel).resolve()
    if not p.is_relative_to(KB_ROOT):
        raise ValueError(f"path escapes KB_ROOT: {rel}")
    if p.suffix != ALLOWED_SUFFIX:
        raise ValueError(f"only .md is served, got: {rel}")
    return p


def parse_frontmatter(text: str) -> dict:
    meta = {}
    m = FRONTMATTER_RE.match(text)
    if m:
        for line in m.group(1).splitlines():
            k, sep, v = line.partition(":")
            if sep:
                meta[k.strip()] = v.strip()
    return meta


def audit(action: str, path: str, extra: dict | None = None) -> None:
    entry = {"ts": datetime.now(timezone.utc).isoformat(), "action": action,
             "path": path, **(extra or {})}
    with open(AUDIT_LOG, "a", encoding="utf-8") as f:
        f.write(json.dumps(entry, ensure_ascii=False) + "\n")


@mcp.tool
def kb_catalog() -> str:
    """列出知识库全部文档的路径和 frontmatter 摘要。先看这个,再决定读哪篇。"""
    items = []
    for p in sorted(KB_ROOT.rglob(ALLOWED_GLOB)):
        rel = p.relative_to(KB_ROOT)
        if any(part.startswith(".") for part in rel.parts):
            continue
        meta = parse_frontmatter(p.read_text(encoding="utf-8"))
        items.append({
            "path": str(rel),
            "title": meta.get("title", ""),
            "type": meta.get("type", ""),
            "status": meta.get("status", ""),
            "updated": meta.get("updated", ""),
        })
    return json.dumps(items, ensure_ascii=False, indent=1)


@mcp.tool
def kb_search(query: str, limit: int = 10) -> str:
    """按正则搜索全部 .md 文档,返回 "文件:行号: 摘要"。"""
    limit = max(1, min(limit, 50))
    rx = re.compile(query, re.IGNORECASE)
    hits = []
    for p in sorted(KB_ROOT.rglob(ALLOWED_GLOB)):
        for n, line in enumerate(p.read_text(encoding="utf-8").splitlines(), 1):
            if rx.search(line):
                hits.append(f"{p.relative_to(KB_ROOT)}:{n}: {line.strip()[:120]}")
                if len(hits) >= limit:
                    return "\n".join(hits)
    return "\n".join(hits) if hits else "no hits"


@mcp.tool
def kb_read(path: str) -> str:
    """读一篇文档的完整原文。"""
    return safe_path(path).read_text(encoding="utf-8")


@mcp.tool
def kb_write(path: str, content: str, reason: str) -> str:
    """新增或更新一篇文档。content 必须带 frontmatter
    (title/type/status/updated),status 只能是 current/draft/superseded。
    不提供删除——删东西走 git,让人来决定。"""
    p = safe_path(path)
    if len(content.encode("utf-8")) > MAX_WRITE_BYTES:
        return f"rejected: content over {MAX_WRITE_BYTES} bytes"
    meta = parse_frontmatter(content)
    missing = [k for k in REQUIRED_META if not meta.get(k)]
    if missing:
        return f"rejected: frontmatter missing {missing}"
    if meta["status"] not in VALID_STATUS:
        return f"rejected: status must be one of {VALID_STATUS}"
    p.parent.mkdir(parents=True, exist_ok=True)
    tmp = p.with_name(p.name + ".tmp")
    tmp.write_text(content, encoding="utf-8")
    os.replace(tmp, p)
    audit("write", path, {"reason": reason, "bytes": len(content)})
    return f"ok: {path} ({len(content)} chars, reason recorded)"


@mcp.tool
def code_graph_query(question: str) -> str:
    """查代码知识图谱(graphify-out/graph.json),回答"谁调用谁、改哪会影响哪"。
    前提:先在 CODE_ROOT 跑过 graphify。"""
    graph = CODE_ROOT / "graphify-out" / "graph.json"
    if not graph.exists():
        return "no graph found: run `graphify update` in CODE_ROOT first"
    try:
        out = subprocess.run(
            ["graphify", "query", question],
            cwd=CODE_ROOT, capture_output=True, text=True, timeout=30,
        )
    except FileNotFoundError:
        return "graphify CLI not installed: uv tool install graphifyy"
    return (out.stdout or out.stderr)[:8000]


if __name__ == "__main__":
    mcp.run()   # stdio:本地 agent 够用,零部署
顺手交代一个调试时踩的坑:Path.rglob(".md") 匹配的是文件名恰好叫 .md 的文件,不是所有 Markdown——要写 rglob("*.md")。这个坑的 symptom 很有迷惑性:目录和搜索永远返回空,读单篇却正常,因为读不走 rglob。
这份代码的每个工具都用 FastMCP 的 Client 逐个调过一遍(FastMCP 4.1.0,Python 3.11),关键输出长这样:
SEARCH: decision/retry.md:2: title: 为什么重试上限定 3 次
WRITE no-frontmatter: rejected: frontmatter missing ['title', 'type', 'status', 'updated']
TRAVERSAL blocked: Error calling tool 'kb_read': path escapes KB_ROOT: ../../etc/passwd.md
WRITE ok: ok: runbook/deploy.md (85 chars, reason recorded)
审计流水也真的落了盘,kb/.kb_audit.jsonl 里一行一条:
{"ts": "2026-10-13T06:30:51.964687+00:00", "action": "write",
 "path": "runbook/deploy.md", "reason": "test", "bytes": 85}
五、接线:Codex、Cursor、Claude Code
三个客户端,三份配置,都是 stdio 直连。
Codex(~/.codex/config.toml):
[mcp_servers.kb]
command = "python3"
args = ["/Users/walter/kb/kb_mcp_server.py"]
env = { KB_ROOT = "/Users/walter/kb/docs", CODE_ROOT = "/Users/walter/src/myproject" }
Cursor(~/.cursor/mcp.json):
{
  "mcpServers": {
    "kb": {
      "command": "python3",
      "args": ["/Users/walter/kb/kb_mcp_server.py"],
      "env": {
        "KB_ROOT": "/Users/walter/kb/docs",
        "CODE_ROOT": "/Users/walter/src/myproject"
      }
    }
  }
}
Claude Code(一条命令):
$ claude mcp add kb --env KB_ROOT=/Users/walter/kb/docs \
    -- python3 /Users/walter/kb/kb_mcp_server.py
再在知识库的 AGENTS.md 里写一句软约束,把用法钉在 agent 的常驻上下文里:
## 知识库怎么用
- 查知识库一律走 kb_* 工具:先 kb_catalog 看目录,再 kb_search / kb_read。
- 引用结论必须给出 kb 里的文件路径。
- 写入用 kb_write,必须带 reason;删除不归你管,提给人类。
六、写护栏:防呆,不防贼
写工具是整套东西里最危险的一个,护栏也最多:
| 护栏 | 代码位置 | 挡住什么 |
|---|---|---|
| 路径白名单 | safe_path:resolve 后 is_relative_to(KB_ROOT) |
../../etc/passwd.md 这类越界访问 |
| 后缀限制 | 同上,只放行 .md |
顺走配置文件、脚本 |
| frontmatter 校验 | kb_write 开头 |
无元数据的裸文档进库,污染目录层 |
| 大小上限 | 200 KB | agent 把整段日志或生成物灌进知识库 |
| 原子替换 | 写 .tmp 再 os.replace |
写一半断电留下半截文件 |
| 审计流水 | 每笔写一行 JSONL | 事后说不清“这篇是谁改的、为什么改” |
| 不提供删除 | 压根没有这个工具 | 删除是不可逆动作,走 git、让人拍板 |
得诚实地说清楚这套护栏的边界:它防呆,不防贼。 agent 理论上仍然可以用自带的文件工具绕过柜台直接改文件——MCP server 管不了协议之外的动作。真要硬约束,得靠客户端的沙箱(Codex 的 sandbox、Cursor 的权限设置),把直连文件系统的路封死,只留柜台这一扇门。柜台的价值不在绝对安全,在于两点:正门足够好用,agent 没动机走野路子;账本足够清楚,出了事能对上账。
还有一个升级选项:把 make html 挂进写入流程。Sphinx build 就是知识库的编译器,写入后自动 build 一次,Mermaid 写坏了当场报错——相当于给文档加了 CI。个人用没必要常开,定期跑一遍就够。
七、把代码分析工具的图也挂上柜台
知识库里除了人写的文档,还有一类“从代码里长出来的知识”——代码知识图谱。agent 在陌生代码库里 grep 的惨状我写过:问“重定向逻辑在哪处理的”,它 grep 出三十个文件读五个,发现读错了再 grep 一轮。治这个病的思路是同一个:别让它翻文件,让它查图。
柜台上的 code_graph_query 已经接了 graphify。它在柜台里的角色是常挂的免费地图:tree-sitter 纯本地解析,建图零 token,graphify-out/graph.json 常驻磁盘,agent 问“谁调用谁”,一个工具调用就回来,比 grep 又快又准。
另一个是 Understand-Anything,角色是按需的贵导游。它用多 agent 流水线把代码库解析成 .ua/knowledge-graph.json,LLM 给节点写人话摘要、生成导览、映射业务领域——解释力比纯 AST 强一档,但首次全库分析要烧不少 token。它的产物也可以挂上柜台,几行就够:
@mcp.tool
def ua_graph_summary() -> str:
    """读 Understand-Anything 图谱的摘要:节点数、边数、核心节点。"""
    g = CODE_ROOT / ".ua" / "knowledge-graph.json"
    if not g.exists():
        return "no graph: run /understand first"
    data = json.loads(g.read_text(encoding="utf-8"))
    return json.dumps({
        "nodes": len(data.get("nodes", [])),
        "edges": len(data.get("edges", [])),
        "top": [n.get("label", n.get("id")) for n in data.get("nodes", [])[:20]],
    }, ensure_ascii=False)
| graphify | Understand-Anything | |
|---|---|---|
| 解析方式 | tree-sitter,纯本地 | tree-sitter + LLM 多 agent |
| 建图成本 | 零 token,秒级 | 首次全库分析烧 token |
| 强项 | 结构关系:谁调用谁、改哪影响哪 | 人话解释:这个模块是干什么的 |
| 挂柜台方式 | code_graph_query(本文已含) |
读 .ua/knowledge-graph.json 的工具 |
| 适合 | 常挂 | 按需,接手新库或大改动前跑一次 |
老规矩,边界要讲清楚:图上的解释是阅读线索,不是签字证据。 LLM 写的节点摘要可以很通顺又漏掉真正决定行为的那一行,两个工具给的答案最后都要回源码核对——这个判断我在上一篇里展开过。另外 graphify 的中文查询我实测是失效的,问它请用英文。
八、边界与升级路径
这套最简方案的适用边界,和往哪儿升级:
| 现状 | 什么时候不够 | 升级方向 |
|---|---|---|
| stdio 本地直连 | 想跨机器共享、给团队用 | mcp.run(transport="http") 起服务,加鉴权;无状态部署的坑我写过 |
| Python 正则搜索 | 文档涨到几万篇,扫描变慢 | SQLite FTS5 → pgvector,三级检索递进见知识库工作流 |
| 单仓库知识库 | 业务拆成七八个仓库,知识落进缝里 | 联邦式领域知识库,见上一篇 |
| 五个工具 | agent 开始组合出危险动作 | 加确认门:写 status: current 的文档先返回 diff 等人类点头 |
验收别用“能不能连上”这种弱标准,用 golden question:问一个只有你的知识库知道答案的问题(“我们重试上限为什么是 3 次”),agent 应该先 kb_catalog、再 kb_search、然后 kb_read 原文、引用时带路径——这条链走通了,柜台才算开张。
总结:柜台要小,账本要清
回到开头那句:别把仓库钥匙整个交给 agent,给它开个柜台。这套方案里最值钱的不是那五个工具,而是三条约束——路径进白名单,写入过校验,每笔留流水。工具可以加减,这三条别动。
全套加起来:一个 Sphinx 知识库(你多半已经有了),一百多行 Python,三份客户端配置。没有部署、没有数据库、没有向量库,grep 和目录在这一档规模下就是最便宜也最准的检索。
今天就能做的四件事
- 挑你最常被问的 10 篇文档,补上 frontmatter(
title/type/status/updated四个字段)。 - 把
kb_mcp_server.py存下来,pip install fastmcp,KB_ROOT指到你的 docs 目录,跑通kb_catalog。 - 给你最常用的那个 agent 配上这份 MCP server,问一个 golden question 验收。
- 在
AGENTS.md里写下“查库走 kb_*、引用带路径、删除提给人类”这三句,下周看看审计流水里有没有第一笔账。
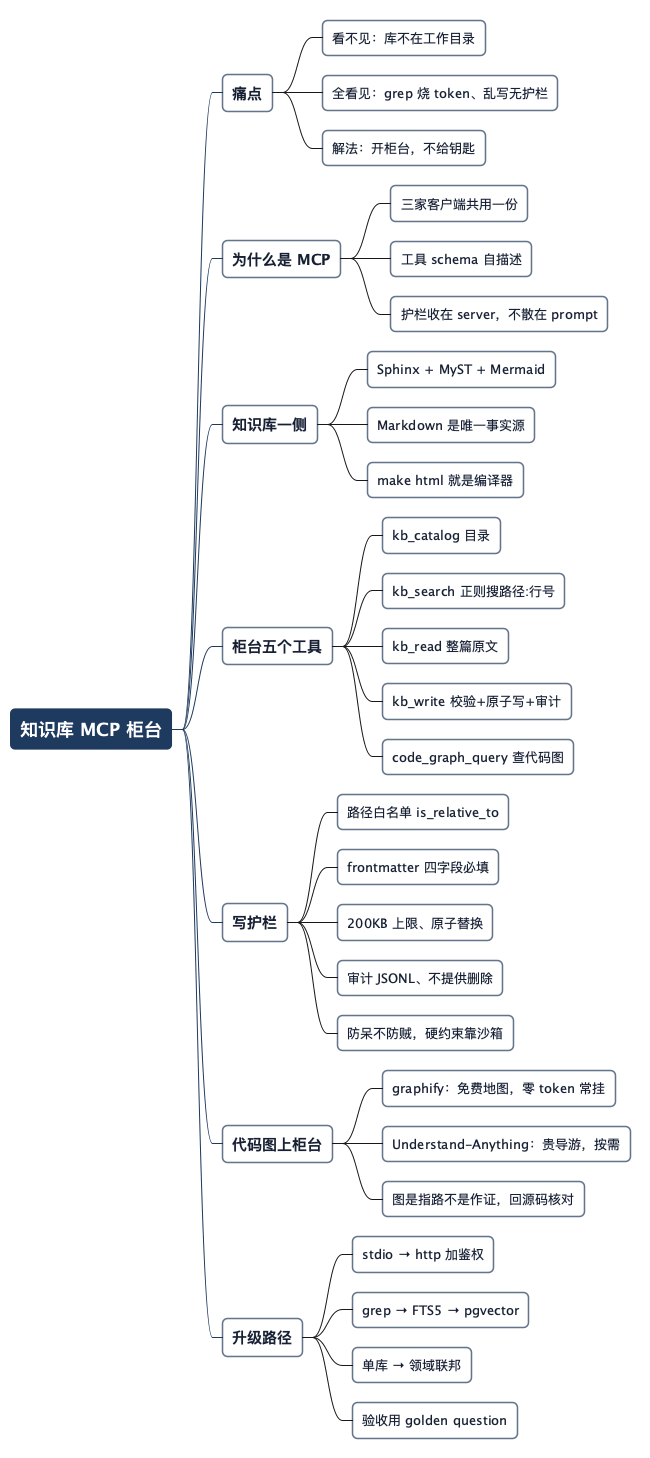
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    LineColor #64748B
    FontColor #172033
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    LineColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* 知识库 MCP 柜台
** 痛点
*** 看不见:库不在工作目录
*** 全看见:grep 烧 token、乱写无护栏
*** 解法:开柜台,不给钥匙
** 为什么是 MCP
*** 三家客户端共用一份
*** 工具 schema 自描述
*** 护栏收在 server,不散在 prompt
** 知识库一侧
*** Sphinx + MyST + Mermaid
*** Markdown 是唯一事实源
*** make html 就是编译器
** 柜台五个工具
*** kb_catalog 目录
*** kb_search 正则搜路径:行号
*** kb_read 整篇原文
*** kb_write 校验+原子写+审计
*** code_graph_query 查代码图
** 写护栏
*** 路径白名单 is_relative_to
*** frontmatter 四字段必填
*** 200KB 上限、原子替换
*** 审计 JSONL、不提供删除
*** 防呆不防贼,硬约束靠沙箱
** 代码图上柜台
*** graphify:免费地图,零 token 常挂
*** Understand-Anything:贵导游,按需
*** 图是指路不是作证,回源码核对
** 升级路径
*** stdio → http 加鉴权
*** grep → FTS5 → pgvector
*** 单库 → 领域联邦
*** 验收用 golden question
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。