领域知识库:用 DDD 的思路,让人和各种 AI 工具都能读写
Posted on 一 05 10月 2026 in Tech
| Abstract | 领域知识库:用 DDD 的思路,让人和各种 AI 工具都能读写 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v2.0 |
| Updated | 2026-10-06 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 难在哪:项目知识库成立的四条隐含假设,到了领域级全部失效
- 这是个老问题:Evans 2003 年用 DDD 已经回答过——限界上下文、统一语言、上下文映射
- 中央大 wiki 为什么必然烂掉:复制即腐烂、权限被拉平、成本押错、无人消费
- 联邦三层:事实源在仓库、领域层三类文件、索引层可重建;判据=归哪个限界上下文
- 三类文件对应 DDD 三件武器:统一语言表、上下文映射、跨上下文决策
- 四类原料:文档、代码、测试用例、issue,可信度和意图含量完全不同
- 人和多个 AI 如何共同读写:写-管-读闭环,MCP 做统一出口,各工具的入口文件
- 业界对照:Backstage、DeepWiki、Context7、Unblocked、Glean、GraphRAG 各解决哪一层
- 落地顺序:按限界上下文间的链路推进,用 golden question 做验收
- 治理:腐烂是默认状态,所以要有门
- 参考文献:DDD、RAG、GraphRAG、上下文工程、Agent 记忆、MCP、业界产品
一个实时音视频业务,拆开看是七个仓库:接入与信令、媒体服务器、三端 SDK、房间与会控、录制转码、用量计费、管理后台。每个仓库都有自己的 docs/,都用 Sphinx 或 MkDocs 发了站点,都写了 AGENTS.md。单看每一个,知识库建得都不错。
然后新人问了一个问题:一场会议的计费时长,从哪个事件算起,到哪个事件算止?
信令团队说从 INVITE 成功算起;媒体团队说得等第一个 RTP 包;SDK 团队说用户看到"已连接"才算;计费团队说以房间的第一个 participant join 事件为准。四个答案,四份文档,每一份在自己仓库里都是对的。这个问题没有家——它横跨好几个仓库,不属于任何一个,于是没人写它,也没人维护它。
绝大多数团队这时候的第一反应是:建一个中央知识库,把各项目文档同步进来。这是错的。 一个靠同步和复制撑起来的中央 wiki,三个月后会变成一个比原来更不可信的信息源——因为它看起来权威,实际全是快照。
而且这个问题根本不新。你要建的不是"业务知识库",而是领域知识库(domain knowledge base)——Eric Evans 在 2003 年的《领域驱动设计》里,已经把它的病因和药方都写清楚了。那本书讲的根本不是怎么写 Java 类,而是怎么在一个复杂领域里,让不同团队用一套不打架的语言和模型协作。这和"让人和一堆 AI 工具共享同一份知识"是同一个问题的两副面孔。
下面把 DDD 的三件武器搬到知识库上,再详细讲人和 Cursor、Codex、Claude Code 这些工具如何通过一个"写-管-读"闭环共同维护它,最后给一份带链接的参考文献。
一、项目知识库好做,领域知识库难做,难在哪
不是量变。单仓库知识库之所以能成立,靠的是四条很少被说出口的假设。到了领域级,它们一条都不剩。
| 假设 | 单仓库里成立 | 领域级失效的样子 | DDD 里对应的概念 |
|---|---|---|---|
| 事实源单一 | 一件事只有一处写法,冲突在 code review 里就解决了 | 两个仓库对同一事实各写一份,互相矛盾,没人有权裁决 | 模型需要 unified |
| 边界清晰 | 这个仓库管什么,README 第一段就说清了 | 端到端链路横跨好几个仓库,没有一个是它的家 | 缺少显式的限界上下文 |
| 所有权明确 | 每个目录有 owner,MR 必须有人批 | 跨项目知识是所有权真空,谁写都行,等于谁都不写 | 上下文之间关系未定义 |
| 术语一致 | 一个词在一个代码库里基本是一个意思 | 同一个词在不同项目里指不同的东西,而且没人发现 | 没有统一语言 |
第四条最阴险,因为它不会报错。拿"session"这个词来说:
- 信令服务里,一个 session 是一条 SIP dialog;
- 媒体服务器里,一个 session 是一路媒体流的上下文,一个人开麦关麦可能产生两个;
- 计费服务里,一个 session 是一次计费周期,从第一个人入会到最后一个人离会;
- SDK 里,一个 session 是用户从点"加入"到点"离开"。
于是"这场会有几个 session"这个问题,四个团队给四个答案,每个都对。更麻烦的是,这四个含义会以 sessionId 的名义出现在四套日志、四张表、四个 API 里,然后在某一次对账时集中爆炸。
Evans 对这种词有个精确的说法:polysemic concept(一词多义的概念)。他在《领域驱动设计》里把 Bounded Context(限界上下文)列为战略设计的核心模式,专门用来对付大模型、大团队下的这类矛盾——同一个概念在不同上下文里可以有完全不同的模型,上下文之间要有明确的机制来映射(Fowler 对 Bounded Context 的综述,2014)。
这类知识有一个共同特征:它不住在任何一个仓库里,只住在几个老员工的脑子里。 领域知识库真正要建的,就是这一部分。不是把各项目的文档再抄一遍。
二、三件武器,Evans 二十年前就给了
DDD 把设计分成战术和战略两层。写知识库用得上的全在战略层,就三个概念,一个一个对上。
统一语言(Ubiquitous Language)。 Evans 2003 年书里第 2 章的标题,Fowler 把它概括为"在开发者和用户之间建立一套共同的、严谨的语言"(Ubiquitous Language)。关键词是"严谨"——因为软件不能处理歧义。放到知识库上,这就是那张统一术语表:把 session、tenant、room 这些词在每个上下文里的确切含义钉死,否则人和模型都会在同一个词上各想各的。
限界上下文(Bounded Context)。 一个上下文内部,模型必须自洽;跨上下文,概念可以不同。Evans 的原话思路是:不要强求一个覆盖整个系统的大模型,而要把系统切成多个限界上下文,每个内部统一(BoundedContext)。放到知识库上,这就是判据:一条知识归哪个上下文,就住在那个上下文的仓库里。
上下文映射(Context Map)。 Evans 原书 344 页专门讲这个:把各个限界上下文之间的关系画出来、写明白——谁依赖谁、翻译层在哪、哪些概念要在边界上转换。放到知识库上,这就是那批端到端链路和跨上下文契约:计费时长那个问题,本质就是"信令上下文的 INVITE 成功"如何映射到"计费上下文的 session 起点",这个映射没写下来,就只能靠人脑现场翻译。
还有一个常被忽略的点。Evans 本人并不主张堆文档——他的建议是把文档保持到最少,让它去补充代码和对话,并维护一份随项目活动持续演进的"活文档"(living documentation),以统一语言及其演化为线索(见对 Evans 战略设计的综述,note.com, 2026-04)。这句话几乎就是本文联邦主张的祖师爷版本:事实源在代码和对话里,文档只做最少的、活的补充。
三、中央大 wiki 为什么必然烂掉
反对中央化不是口味问题,有四个结构性原因。
一、复制即腐烂。 从仓库同步到中央库的那一刻,你得到的是一张快照。源一改,副本就假了,而且没有任何机制会告诉你它假了——代码写错了编译器会骂你,测试会红,文档写错了只会安静地躺在那里误导下一个人。副本越多,腐烂面越大。联邦制的第一条纪律:领域层只放指针,不放副本。
二、权限边界被拉平。 跨上下文知识库天然跨权限域:有些设计文档只对本组可见,有些客户名单有合规要求,有些生产配置根本不该进文档库。中央库的结局通常是——要么拿不到那些数据,知识库是残的;要么把分级的东西拉成一级,变成合规问题。
企业搜索产品 Glean 的解法值得借鉴:它不把内容搬进共享空间,而是从各源系统同步每份文档的 ACL,在查询时逐文档过滤(Glean 知识图谱文档,2026-08)。权限留在源头,索引层只做转发。
三、成本押错了时机。 "既然要统一,干脆上知识图谱"很有吸引力,直到你算账。微软研究院自己的数据:LazyGraphRAG 的索引成本是完整 GraphRAG 的 0.1%,与普通向量 RAG 相当,全局查询上达到可比质量的查询成本低 700 倍(Microsoft Research, 2024-11-25)。重点不是图谱不好,是付费时机:完整 GraphRAG 先付——建索引时把实体抽取和社区摘要全跑完。在术语还在打架、链路还在变的阶段,这笔钱买的是一张马上要重建的图。先把统一语言和上下文映射用人话写清楚,图谱什么时候加都不迟。
四、没人消费的索引会死。 llms.txt 是个好例子:思路完全正确——在站点根目录放一份给模型看的 Markdown 索引。但 Ahrefs 对 137,210 个域名的分析显示,2026 年 5 月有 97% 的 llms.txt 文件收到零次请求,AI 检索爬虫只占到访流量的 1.1%;截至 2026 年没有主流模型厂商公开承诺在生产中读取它(etched.io, 2026-07-24)。教训:为 AI 准备的索引,必须由你能控制的工具去消费,不能发布了就指望别人来读。
四、联邦三层:事实源、领域层、索引层
flowchart TB
    subgraph L1["L1 领域层 — 薄,只有三类文件,人工维护"]
        G["统一语言表<br/>Ubiquitous Language"]
        F["上下文映射 / 端到端链路<br/>Context Map"]
        D["跨上下文决策与契约<br/>ADR + contracts"]
    end
    subgraph L0["L0 事实源 — 各限界上下文的仓库,唯一可写处"]
        R1["信令上下文<br/>docs · AGENTS.md · tests · ADR"]
        R2["媒体上下文<br/>docs · AGENTS.md · tests · ADR"]
        R3["SDK 上下文<br/>docs · AGENTS.md · tests · ADR"]
        R4["计费上下文<br/>docs · AGENTS.md · tests · ADR"]
    end
    subgraph L2["L2 索引层 — 可重建、可丢弃,不是资产"]
        I["全文检索 · 向量 · 符号图 · 服务目录"]
    end
    L1 -. "只放指针,不放副本" .-> L0
    L0 --> I
    L1 --> I
    I --> H["人:文档站 + 搜索 + 导航"]
    I --> A["AI:入口文件 + MCP / CLI 工具"]
三层各有一条铁律:
- L0 事实源:唯一可写处。文档和代码同仓同 MR,改代码不改文档的 MR 不该合。
- L1 领域层:只写跨上下文才存在的东西,其余一律指向 L0。这一层要刻意保持薄——越厚越说明有东西放错了地方。
- L2 索引层:embedding、符号图、服务目录、全文索引,全部可一键重建。它是缓存,不是资产。 删掉不心疼,才算做对了。
判断一条知识住哪儿,只问一个问题:
它属于哪个限界上下文? 只属于一个 → 写在那个上下文的仓库。 跨多个、谁都不算单一 owner → 才上领域层。
"媒体服务器的码率自适应算法"属于媒体上下文,写在媒体仓库;"一场会议的计费时长口径"是信令、计费两个上下文边界上的映射,没有单一 owner,上领域层。
这个结构 Backstage 已经做成产品了
Backstage 的 Software Catalog 定义了 Component、API、System、Domain 等实体,其中 Domain 的官方定义就是"一组共享术语、领域模型、业务目的或文档的 System 集合,即一个 bounded context"(Backstage 实体描述格式)。限界上下文被直接做成了目录里的一级实体。
更关键的是 TechDocs 的做法:文档源留在各自仓库的 docs/,仓库的 catalog-info.yaml 里只加一行注解:
metadata:
  annotations:
    backstage.io/techdocs-ref: dir:.
目录在中心,内容在各家。 Backstage 2020 年 9 月进入 CNCF,2022 年 3 月升为 Incubating(CNCF 项目页)。
五、领域层只写这三类文件
薄到什么程度?一个七仓库的领域,领域层大概就这些:
domain-kb/
├── AGENTS.md              # 给 agent 的入口:这是什么、去哪找、不要自己瞎猜
├── index.md              # 给人的入口:七个上下文各管什么,一句话一个
├── glossary.md           # 统一语言表 ← 最高 ROI 的一页
├── context-map.md        # 上下文映射:谁依赖谁,边界上怎么翻译
├── flows/                # 端到端链路(上下文映射的展开)
│   ├── join-meeting.md
│   ├── billing-cycle.md
│   └── recording.md
└── decisions/
    ├── adr-001-session-id-unification.md
    └── contracts/        # 跨上下文 API / 事件 schema 的变更记录
第一类:统一语言表。 整个知识库里 ROI 最高的一页,因为它同时修人和 AI 的歧义。每个词至少四样:
| 字段 | 例子(session) |
|---|---|
| 领域定义 | 一次完整的会议生命周期,从第一人入会到最后一人离会 |
| 各上下文里的叫法 | 信令:dialogId/媒体:mediaSessionId/SDK:sessionId/计费:billingSessionId |
| 不是什么 | 不是 SIP dialog,不是一路 RTP 流,不是用户的一次点击 |
| 口径 owner | 计费上下文(因为对账以它为准) |
"不是什么"这一栏最值钱。它是唯一能治住"看起来像所以就当成同一个"的东西——人会犯这个错,模型犯得更勤。
第二类:上下文映射与端到端链路。 context-map.md 画清上下文之间的依赖和翻译关系,flows/ 把每条关键链路展开:触发事件、途经的上下文(带仓库和关键文件链接)、数据落在哪、已知失败模式、谁 oncall、可验证的断言。最后一条是关键——"用户入会后 2 秒内应收到 room.joined 事件"能被测试,"系统会快速建立连接"不能。
第三类:跨上下文决策。 单仓库的 ADR 留在单仓库。上领域层的只有两种:动了多个上下文的架构决策,以及跨上下文契约(API / 事件 schema)的变更记录。契约变更尤其重要,因为它是跨团队事故的主要来源,而它的"为什么"通常只存在于某个已关闭的 issue 里。
其余的——repo map、模块说明、部署手册——全部留在各上下文的仓库,它们归谁改很清楚。
六、四类原料,四种提炼法
文档、代码、测试用例、Jira/git issue,这四样的可信度、意图含量、信噪比完全不同。把它们一锅端进同一个向量库,是领域知识库最常见的错。
| 原料 | 可信度 | 意图含量(为什么) | 信噪比 | 该怎么处理 |
|---|---|---|---|---|
| 文档 | 中(会过期) | 高 | 高 | 必须有 owner 和核实日期;没人认领的标"历史参考" |
| 代码 | 最高(它就是事实) | 零 | 中 | 结构化成符号图/调用图再喂,别整文件灌 |
| 测试用例 | 高(能跑就是真的) | 中高 | 高 | 当作可执行的规格,优先喂验收层用例 |
| issue / MR 讨论 | 低(含大量作废方案) | 最高 | 最低 | 不要全量灌;人工提炼成决策记录 |
两类被系统性低估。
测试用例是可执行的统一语言。 Gojko Adzic 在 2011 年的《Specification by Example》里讲清了这件事:把规格写成可执行测试,它就不会静默过期——跑一遍就知道还成不成立(InfoQ 书评)。这和 DDD 是一脉相承的:统一语言不只活在术语表里,还活在测试用例的命名和断言里。想让 agent 理解"入会成功"到底指什么,给它二十条端到端验收用例,比给它三页描述管用得多,而且代码一改、用例一红,知识库自动就知道自己过期了。所以 flows/*.md 里那条"可验证的断言"最好直接链到对应的验收用例文件。
issue 是"为什么"的唯一记录,也是信噪比最低的一堆东西。 代码只告诉你 what,从不告诉你 why;而 why 恰恰是 review 和改动时最需要的。做这件事的商业产品 Unblocked 把问题说得很准:"Coding agents know the code. They do not know why it was written that way, which of two conflicting docs is current, what a ticket decided."(Slack Marketplace)但别把一万条 issue 直接灌进检索库——里面绝大部分是被否掉的方案和早就不成立的约束。提炼成一行一条的决策记录:这条 issue 决定了什么、排除了什么、现在还成不成立。一百条高质量决策记录,比一万条原始 ticket 有用。
七、人和多个 AI 工具,如何共同读写维护
这是本文的重点。知识库不是建完就完事的静态资产,它是一个持续的闭环。关于 AI agent 怎么处理外部知识,2026 年的一篇综述把它形式化成一个"写-管-读"循环(write–manage–read loop),和感知、行动紧耦合(Agent 记忆综述,arXiv:2603.07670)。这个框架拿来描述"人+多 AI 共同维护知识库"正好合适——把每个角色放进这三个动作里看。
flowchart LR
    subgraph Write["写 Write"]
        H1["人:定口径、签字"]
        A1["AI:生成草稿、提炼 issue"]
    end
    subgraph Manage["管 Manage"]
        M1["重建索引 · 跑 lint · golden question 回归"]
    end
    subgraph Read["读 Read"]
        H2["人:文档站 + 搜索"]
        A2["AI:AGENTS.md + MCP/CLI 渐进披露"]
    end
    Write --> Manage --> Read
    Read -. "发现缺口/过期" .-> Write
写:人定口径,AI 出草稿,但只准一份事实源
分工要清楚:
- AI 适合做的:根据代码和测试生成链路文档初稿、把一堆 issue 提炼成决策记录候选、扫出孤立页面、给术语表补"各上下文里的叫法"这种机械活。
- 人必须做的:裁定口径(计费时长到底从哪算)、给跨上下文决策签字、判断一条提炼出来的决策"现在还成不成立"。
铁律:AI 可以写草稿,不能发布结论。 一个自信的错误口径,比一页空白危险得多。让 agent 产出的东西一律进 draft,由人合并。
还有一条:绝不为 AI 单独维护一份内容。 一旦开始给 agent 写一套"精简版文档",你就又回到了"复制即腐烂"。人和 AI 读的是同一批源文件。
管:索引是缓存,定期重建 + 回归
"管"这一层全是自动化:
- 索引重建:embedding、符号图、全文索引随源文件变化重建。因为它是缓存不是资产,重建随时可做。
- lint:孤立页面、死链、超期未核实的页面、术语表里缺"不是什么"字段的词,都能用脚本扫出来。
- golden question 回归:这是知识库的"测试",下一节细说。像跑 CI 一样每周一跑,命中率掉了就报警。
读:一份源,两种出口,三跳披露
人和 AI 要的东西不一样。
人要导航:清楚的目录、能扫的标题、一个搜索框。走 Sphinx/MkDocs 构建的站点就够了。
AI 要渐进披露:上下文预算有限,不能一次塞一百页。正确的喂法是三跳——入口文件说清这是什么、去哪找;索引给目录和一句话摘要,让模型自己挑;选中之后再取具体页。DeepWiki 的 MCP 接口就是照这个顺序设计的,三个工具分别是 read_wiki_structure(先拿结构)、read_wiki_contents(再取内容)、ask_question(带引用问答)(Devin 文档)。先给目录让模型自己挑,是最便宜的检索。
让不同 AI 工具都能读:MCP 做统一出口
现在团队里 Cursor、Codex、Claude Code 可能同时在用,你不可能给每个工具单独做一套接口。两个层面解决:
入口文件层:AGENTS.md 已经接近事实标准。 它是一份放在仓库根、给 agent 看的 Markdown,自 2025 年 8 月发布以来被六万多个开源项目采用,2025 年 12 月由 OpenAI 捐给 Linux 基金会下的 Agentic AI Foundation(OpenAI, 2025-12-09)。同一份 AGENTS.md 被 Codex、Cursor、Gemini CLI、GitHub Copilot 等共同读取。它的规则是嵌套、就近者胜——每个限界上下文的仓库放自己的一份,领域层放一份总的,agent 自动读目录树里最近的那个。这天然就是联邦结构(agents.md)。
不过别把采用率想得太好。一项调研发现扫描到的仓库里只有 5% 采用了任一种 AI 配置文件格式,而且 AGENTS.md 的内容组织还没形成定式,表述方式五花八门(arXiv:2510.21413)。格式有了,规范还没有——你得自己定。 对 Claude Code 等默认读 CLAUDE.md 的工具,通用做法是建个软链指回 AGENTS.md,保证单一事实源。
检索出口层:一个 MCP server 喂所有工具。 MCP(Model Context Protocol)是 Anthropic 2024 年 11 月开源的标准,"用一个通用协议替代碎片化的集成,给 AI 系统一个更可靠的方式去拿它需要的数据"(Anthropic, 2024-11-25)。它是双向的:既能读,也能触发动作。做法是把领域知识库的检索能力(搜文档、取链路、查术语、查契约)包成一个 MCP server,Cursor、Codex、Claude Code 都接这一个 server。写一次,所有工具通用——这正好呼应了前面那条"为 AI 准备的索引必须由你能控制的工具去消费"。
一张表总结各工具怎么接:
| 工具 | 入口文件 | 检索出口 | 要注意 |
|---|---|---|---|
| Cursor | AGENTS.md(就近嵌套) |
MCP server | rules 也可指向同一份 AGENTS.md,别另写 |
| Codex | AGENTS.md(原生) |
MCP server | 它就是 AGENTS.md 的发源地,嵌套支持最好 |
| Claude Code | CLAUDE.md → 软链到 AGENTS.md |
MCP server | 默认文件名不同,用软链保证单一源 |
| 其它(Gemini CLI/Copilot…) | AGENTS.md |
MCP server | 配置里指定 context 文件名即可 |
核心就一句:入口文件统一到 AGENTS.md,检索出口统一到一个 MCP server。 这样换工具不用重建知识接口,加工具只是多接一个客户端。
八、业界对照:各解决哪一层
| 产品 / 方案 | 解决哪一层 | 联邦还是集中 | 什么时候值得上 | 坑 |
|---|---|---|---|---|
| Backstage + TechDocs | L1 目录 + L0 指针 | 联邦(目录在中心,文档在各仓库) | 服务数超过十几个、团队边界清楚 | 本身是个要养的平台,小团队成本倒挂 |
| DeepWiki / Devin | L0 自动生成 + MCP 出口 | 单仓库视角 | 快速摸清一个陌生仓库 | 看不到跨上下文的链路;生成内容需人审 |
| Context7 | L2 外部文档注入 | 联邦(源在官方文档) | 依赖的库比模型训练数据新 | 管的是第三方库,不是你的领域语义 |
| Unblocked | L2 跨源上下文层 | 联邦(不搬数据,沿用源权限) | 知识散在 Jira/Slack/Confluence/代码里 | 商业产品,依赖外部服务与数据出域策略 |
| Glean / Onyx | L2 企业搜索 | 联邦(同步 ACL,查询时过滤) | 全公司级信息检索 | 解决"找得到",不解决"写得对" |
| GraphRAG / LazyGraphRAG | L2 图检索 | 集中索引 | 多跳问题占比高、语料已稳定 | 完整 GraphRAG 先付重金;语料常变就白建 |
| 自建 Sphinx/MkDocs + MyST + MCP | L0 + L1 + 出口 | 联邦 | 任何阶段,起步首选 | 跨仓库搜索要自己接;治理全靠纪律 |
一句话选型:L0 和 L1 自己写,L2 买或借。 统一语言和上下文映射是你的核心资产,别人代写不了;索引和检索是通用能力,犯不上自研。
九、落地顺序:按限界上下文间的链路推进
常见的失败姿势是先铺模板:建十个目录,写 00-overview.md、01-repo-map.md……写到第四篇热情耗尽,剩下目录空着,整个知识库像个烂尾楼。
换个方向——一条跨上下文链路一条链路地打穿:
- 挑一条最常被问的链路。 翻 oncall 记录和新人提问,哪条反复被问先打哪条。
- 先立 20 个 golden question。 把这条链路上真实被问过的问题写下来,带标准答案和出处。"计费时长从哪个事件算起"就是一个。这 20 个问题是验收基准,不是文档大纲。
- 只补答不上来的那几页。 跑一遍:人能答对几个?Cursor/Codex 带现有上下文能答对几个?答错和答不出的,才是真缺口。能答对的一个字别写。
- 接到出口。 新页进
flows/,术语进glossary.md,AGENTS.md加指针,MCP server 能检索到。不接出口等于没写。 - 量。 三个数:golden question 命中率、引用是否指向真实存在的文件(防模型编路径)、新人不问人能独立答对的比例。
- 下一条链路。 重复。
第 5 条值得多说。文档天然缺反馈,所以大家写完就撒手——好不好没人知道,过期了也没人知道。给知识库定指标,和给服务定 SLI 是同一件事:没有指标的系统,只能靠人的自觉维持,而自觉撑不过三个季度。golden question 回归可以像跑测试一样进 CI。我在《微服务之道:度量驱动开发》里花整本书讲这件事在服务上怎么做,知识库是同一个道理,只是指标换了一组。
十、治理:腐烂是默认状态
知识库不会"保持"良好,它只会从良好开始衰减。所以要有门:
- 每页两个字段:owner 和"最后核实日期"。 不是"最后编辑日期"——改错别字不叫核实。超过半年没核实的自动打标记。
- 事实源之外的任何副本,顶部标"派生内容,勿直接修改"并给源链接。 理想是一份副本都没有。
- 契约变更挂进 MR 模板。 改了跨上下文的 API 或事件 schema,强制要求一行 decisions 记录。这是唯一能在"为什么"还热乎时抓住它的时机。
- AI 写草稿,人签字。 业务口径类的东西必须有人负责。
- 定期跑 golden question 回归。 和跑测试一个频率。
也要承认联邦制的代价:发现成本高(得先知道去哪个上下文找);跨仓库搜索必须有工具(MCP server 就是干这个的),否则"联邦"就等于"散落";领域层会在 owner 缺位时空着。前两个花钱能解决,第三个只能靠组织——给领域层指定一个真实 owner,哪怕是个虚拟角色。
总结:领域知识库是一张上下文映射,不是一个仓库
从项目知识库走到领域知识库,要换的不是工具,是权属模型——而这个模型 Evans 二十年前就给好了。工具还是 Markdown、Git、Sphinx、Mermaid 加一个 MCP server,变的是三件事:用统一语言钉死术语、用限界上下文判断归属、用上下文映射记录跨界关系。
一句话:
事实源只有一份,住在它所属的限界上下文里;领域层只写那些横跨上下文才存在的东西;索引层随时可以删掉重建;人和所有 AI 工具共用同一份源,通过 AGENTS.md 加一个 MCP server 读写。 反过来做的,三个月后都会变成一个没人信的中央大 wiki。
今天就能做的五件事:
- 写
glossary.md,第一个词就挑团队里吵得最凶的那个,四栏填满——尤其"不是什么"那一栏。 - 翻 oncall 记录,挑一条被问得最多的跨上下文链路,写下 20 个 golden question 和标准答案。
- 拿现有上下文让 Cursor 或 Codex 答这 20 道题,统计命中率。这个数字就是你的起点。
- 把检索能力包成一个 MCP server,三个工具都接它;
AGENTS.md放仓库根,CLAUDE.md软链过去。 - 给每页加 owner 和最后核实日期,把两周后的复核排进日历。
知识库最难的从来不是建起来,是一年以后它还对。
参考文献
领域驱动设计(这套思路的根)
- Eric Evans, Domain-Driven Design: Tackling Complexity in the Heart of Software, Addison-Wesley, 2003(ISBN 0-321-12521-5)。统一语言在第 2 章,限界上下文与持续集成在第 14 章一带,上下文映射在第 344 页。
- Martin Fowler, Bounded Context(2014)、Ubiquitous Language、Domain Driven Design(2020)——比原书短,适合先读。
- Vaughn Vernon, Implementing Domain-Driven Design, Addison-Wesley, 2013。把统一语言和限界上下文讲得更可操作。
检索与上下文(AI 侧的地基)
- Patrick Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,NeurIPS 2020(arXiv:2005.11401)。RAG 的奠基论文。
- Darren Edge et al. (Microsoft), From Local to Global: A Graph RAG Approach to Query-Focused Summarization(arXiv:2404.16130,2024)。GraphRAG 原始论文。
- A Survey of Context Engineering for Large Language Models(arXiv:2507.13334,2025)。上下文工程综述。
- Memory for Autonomous LLM Agents(arXiv:2603.07670,2026)。把 agent 处理外部知识形式化成"写-管-读"循环,本文第七节的框架出处。
- Context Engineering for AI Agents in Open-Source Software(arXiv:2510.21413)。对开源仓库 AI 配置文件采用情况的调研。
活文档与可执行规格
- Gojko Adzic, Specification by Example, Manning, 2011(InfoQ 书评与访谈)。把测试当可执行的活文档。
标准与出口
- Anthropic, Introducing the Model Context Protocol(2024-11-25)。MCP 规范发布。
- agents.md 与 OpenAI 捐赠 AGENTS.md 给 Agentic AI Foundation(2025-12)。
产品与实践案例
- Backstage 实体描述格式 与 TechDocs。限界上下文做成目录的工程化样板。
- DeepWiki MCP(Cognition/Devin)。三跳渐进披露的接口范例。
- Context7(Upstash)。给文档加机器出口、不改写文档。
- Unblocked。跨源上下文层,专门捞"为什么"的商业解法。
- Glean 知识图谱与权限模型。查询时逐文档 ACL 过滤。
- LazyGraphRAG(Microsoft Research)。图谱成本的取舍数据。
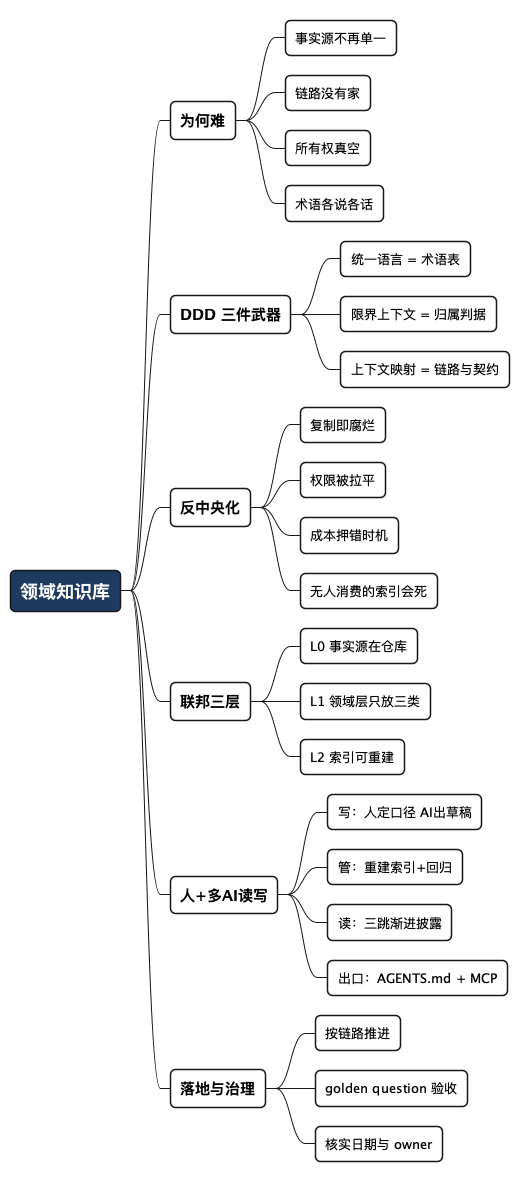
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* 领域知识库
** 为何难
*** 事实源不再单一
*** 链路没有家
*** 所有权真空
*** 术语各说各话
** DDD 三件武器
*** 统一语言 = 术语表
*** 限界上下文 = 归属判据
*** 上下文映射 = 链路与契约
** 反中央化
*** 复制即腐烂
*** 权限被拉平
*** 成本押错时机
*** 无人消费的索引会死
** 联邦三层
*** L0 事实源在仓库
*** L1 领域层只放三类
*** L2 索引可重建
** 人+多AI读写
*** 写:人定口径 AI出草稿
*** 管:重建索引+回归
*** 读:三跳渐进披露
*** 出口:AGENTS.md + MCP
** 落地与治理
*** 按链路推进
*** golden question 验收
*** 核实日期与 owner
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。