一个 Slot 挂了,为什么整个 Redis Cluster 都不可用?讲透 cluster-require-full-coverage
Posted on 三 21 10月 2026 in Tech
| Abstract | 讲透 Redis Cluster 的 cluster-require-full-coverage |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-10-21 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 一句话:
cluster-require-full-coverage管的不是“节点死活”,是“16384 个 slot 有没有被完整覆盖”;节点挂了集群还活着,靠的是副本 failover。 - 一个误会:以为一个节点挂了集群就挂——其实中间还隔着 failover 和 slot 覆盖两道关。
- slot 覆盖:每个 key 先算到一个 0~16383 的 slot,集群每一拍都在数“16384 个 slot 是不是都有活着的节点管”。
- 真源码:
clusterUpdateState()就是一个 for 循环,逐个 slot 看是不是NULL或FAIL,缺一个就把状态置成CLUSTER_FAIL。 - 三个阶段:master 挂 → slot 短暂没人管(集群 FAIL)→ 副本 failover 成功 → 覆盖恢复(集群 OK)。
- 两个配置分工:
require-full-coverage决定“覆盖不全要不要 FAIL”,allow-reads-when-down决定“已经 FAIL 了还让不让读”。 - 一张排查清单:从 CLUSTER INFO 的 slots_fail 一路查到客户端 CLUSTERDOWN。
设想这样一个半夜被叫起来的场景:现象是“整个 Redis 都连不上了”。三主六从的集群,机器都在,ping 得通,但应用侧大面积 CLUSTERDOWN。值班工程师第一反应往往跟很多人一样——是不是哪台挂了整个集群就跟着挂了?
查下来才发现,挂的只有一个主节点,它负责的那一段 slot 的副本没能及时顶上。问题不在“有节点挂了”,而在“有一段 key 空间暂时没人管”。这两件事,长得像,本质完全不同。
这篇想说清楚一个被普遍误读的配置:cluster-require-full-coverage。 它控制的从来不是“节点挂了 Redis 还能不能用”,而是“当 16384 个 slot 没法被活着的节点全部覆盖时,集群要不要干脆整体停摆”。看懂这一条,半夜排查时就不会把力气花错地方。
先把最容易记错的一句话摆出来:
节点挂了集群还活着,靠的是副本 failover,不是
cluster-require-full-coverage。 这个配置只负责在 failover 失败、slot 真的没人管之后,决定集群是停摆还是降级服务。
先搞清楚:集群到底在盯着什么
Redis Cluster 把整个 key 空间切成 16384 个 slot(槽)。每个 key 先过一遍 CRC16,取低 14 位,落到一个 0 到 16383 的编号上:
slot = CRC16(key) & 16383
这里的 16384 不是随便定的,源码里写死成
CLUSTER_SLOTS (1<<14)——14 位二进制,刚好 16384 个。所以你看keyHashSlot里是& 0x3FFF(低 14 位),不是常见误传的% 16384,结果一样但按位与更快。
每个主节点认领一段连续的 slot。三主的典型分法是这样:
关键来了。集群判断自己健不健康,不是挨个去数“A 活着吗、B 活着吗、C 活着吗”,而是反过来问一句:
16384 个 slot,是不是每一个都有活着的节点在管?
全部有人管,集群状态就是 ok;只要有一个 slot 没人管(术语叫 uncovered),在默认配置下,集群就会把自己标成 fail。
节点视角和 slot 视角的差别,正是前面那种排查最容易绕进去的地方——人盯着“哪台机器挂了”,而集群盯着的是“哪段 slot 没人管了”。
真正干活的那段源码:clusterUpdateState()
这套逻辑在 src/cluster.c 里,核心函数叫 clusterUpdateState(),集群每隔一段时间就跑一遍,更新自己的状态。它判断覆盖的那段,剥掉注释后其实短得出奇:
void clusterUpdateState(void) {
    int j, new_state;
    new_state = CLUSTER_OK;          /* 默认乐观:先假设一切 OK */

    /* 只有在 require-full-coverage=yes 时才逐个 slot 检查 */
    if (server.cluster_require_full_coverage) {
        for (j = 0; j < CLUSTER_SLOTS; j++) {
            if (server.cluster->slots[j] == NULL ||
                server.cluster->slots[j]->flags & (CLUSTER_NODE_FAIL))
            {
                new_state = CLUSTER_FAIL;
                break;               /* 只要有一个 slot 没人管,立刻判 FAIL */
            }
        }
    }
    /* ... 后面还有少数派分区、重启延迟等逻辑 ... */
}
就这么点东西。有两处值得盯一眼:
slots[j] == NULL是“这个 slot 压根没有节点认领”;flags & CLUSTER_NODE_FAIL是“认领它的节点被集群判定为 FAIL 了”。两者任意一个成立,这个 slot 就算没人管。break:16384 个里只要撞上第一个没人管的,循环立刻退出,整个集群状态置为CLUSTER_FAIL。头文件里写得很直白:CLUSTER_OK 0(一切正常)、CLUSTER_FAIL 1(集群没法工作)。
所以这个配置的本质,就是这个 if 和这个 for。require-full-coverage=no 时,这段检查直接被跳过——集群不会因为某段 slot 没人管就把自己判死。
真实源码当然比这复杂得多,还要处理 failover、quorum、PFAIL/FAIL、epoch、网络分区。但要理解 cluster-require-full-coverage,抓住这个 for 循环就够了。
一个 master 挂掉,到底发生了什么
这才是上面那种场景的主线。还是三主三从(这里先各带一个副本):
A → A1    slots 0 - 5460
B → B1    slots 5461 - 10922
C → C1    slots 10923 - 16383
现在 B 挂了。整件事会分成界限分明的三个阶段,它们对应的集群状态完全不同,排查时千万别混为一谈:
阶段一:B 刚挂,副本还没顶上。 5461-10922 这段暂时没人管,覆盖不完整。默认配置下 clusterUpdateState() 撞上这段 slot,集群状态变成 fail。这个窗口通常只有几秒,但它确实存在。
阶段二:B1 完成 failover,升为新 master,接管 5461-10922。 16384 个 slot 又全部有人管,集群状态回到 ok。
阶段三:一切照常。 这时候再看,会以为“B 挂了集群根本没事”——其实它只是飞快地走完了前两个阶段。
把顺序理清楚,结论就很清楚了:
真正把 slot 覆盖补回来的,是副本 failover,不是
cluster-require-full-coverage。
这个配置没有任何“修复”能力,它只是个判断开关。能不能从 master 故障里恢复,取决于有没有健康的副本、以及它能不能顺利选举上位。这也是为什么你的集群值得配三主六从——每个主多备几个副本,就是为了让阶段一尽量短、让阶段二尽量稳。
failover 没成功,这个配置才真正登场
如果 B 的副本因为某些原因没能完成 failover——比如副本也一起挂了、数据太旧被拒绝参选、或者网络分区导致选不出票——那 5461-10922 就会长时间没人管。这才是 cluster-require-full-coverage 真正起作用的时刻。
这时候 yes 和 no 走向两条完全不同的路:
| 配置 | 覆盖不全时集群状态 | 行为 |
|---|---|---|
yes(默认) |
fail |
停止服务,宁可整体停摆,也不提供只有半拉 key 空间可用的集群 |
no |
仍可 ok 地服务已覆盖的部分 |
落在 A、C 那段的请求照常,落在 B 那段的请求失败 |
no 的本质不是“集群完全没事”,而是允许集群在部分 key 空间可用的情况下继续工作。举个具体的:
GET user:1  → slot 1000  → A(活着)→ 成功
GET user:2  → slot 7000  → B(没人管)→ 失败
GET user:3  → slot 15000 → C(活着)→ 成功
对缓存类业务,这种“坏一部分、其余照用”往往可以接受——缓存 miss 回源就是了。但对那些需要明确知道“整个数据集是否完整可用”的系统,悄悄提供一个半残的集群可能比直接停摆更危险。所以 Redis 官方的默认值是 yes:
宁可整个集群暂停,也不要不声不响地提供一个只有部分 key 空间可用的集群。
顺带澄清一个措辞上的坑:官方 redis.conf 的注释说覆盖不全时节点“停止接受 queries(查询)”,而 Scale 文档里说的是“停止接受 writes(写)”。两处说法略有出入,实际行为还受 cluster-allow-reads-when-down 影响——这就引出下一个配置。
别和它搞混:cluster-allow-reads-when-down
这两个配置经常被当成一回事,其实分工很清楚,是前后两道关:
slot 覆盖是否完整?
   └─不完整─→ require-full-coverage = yes?
                 └─是─→ 集群标记为 FAIL
                           └─→ allow-reads-when-down = yes?
                                  ├─否(默认)→ 读写全停
                                  └─是        → 还能提供读
说白了:
cluster-require-full-coverage回答的是:覆盖不全,要不要把集群判成 FAIL?cluster-allow-reads-when-down回答的是:集群已经 FAIL 了,要不要还让它服务读请求?
官方文档对后者的定义是:默认 no,当集群被标记为 failed(无论是因为凑不齐 master quorum,还是因为覆盖不满足)时,节点会停止服务所有流量;设成 yes 才会在 FAIL 状态下继续放行读请求。
一个管“要不要死”,一个管“死了还能不能喘气”,别指望其中一个去替另一个干活。
还有一层:Redis 认为的“挂”,和客户端看到的“挂”
这类排查最绕的一点在这里:Redis Server 认为集群 FAIL,和客户端表现为“整个 Redis 都用不了”,是两个层次的问题。
集群内部用的是 Cluster Bus 来互相探活,判定一个节点是否 FAIL,要经过 cluster-node-timeout 这道门槛——一个节点长时间联系不上,先标 PFAIL(疑似挂),够多的节点都这么认为了才升级成 FAIL。所以:
cluster-node-timeout决定“多久才认为一个节点有问题”;cluster-require-full-coverage决定“确认 slot 覆盖不全之后,集群要不要整体停摆”。
这俩不是一回事。更要命的是,“客户端连不上某个节点”不等于“集群判定这个节点 FAIL”:
应用 → B   (网络不通,客户端这边连不上)
A ←→ B ←→ C(集群内部的 Cluster Bus 仍然通)
这种情况下,集群内部可能一切正常,是你的客户端被网络挡在了门外。反过来,客户端库自己也有脾气——比如 redis-py 的集群客户端有个独立的 require_full_coverage 参数,专门区分“客户端这边要求 slot 全覆盖”和“服务端的 cluster-require-full-coverage”。客户端初始化时如果发现覆盖不全,可能直接抛异常,让你误以为整个集群都塌了。
所以“整个 Redis 不可用”这个表象,可能来自服务端 FAIL,也可能来自客户端的 topology 刷新策略或某条连接的网络问题。排查时得分层看。
一张排查清单
把这类排查的路径沉淀成一张清单,下次照着走就行,不用再在“哪台机器挂了”上绕圈:
-
先看集群状态,别先看机器。
bash redis-cli -c -h <host> -p <port> CLUSTER INFO盯住这几行:cluster_state(ok / fail)、cluster_slots_assigned(该是 16384)、cluster_slots_ok、cluster_slots_fail。slots_fail > 0基本就锁定了方向。 -
看 slot 到底谁在管。
bash
   redis-cli -c -h <host> -p <port> CLUSTER NODES
看三段 slot(如0-5460/5461-10922/10923-16383)是不是都挂在master上,以及对应的slave副本在不在、健不健康。 -
确认 failover 有没有发生。 挂掉的那个主,它的副本是不是升成了新 master 并接管了那段 slot。没升上去,就要查副本为什么选不上(数据太旧?网络分区?副本也挂了?)。
-
确认两个开关的取值。
bash
   redis-cli -h <host> -p <port> CONFIG GET cluster-require-full-coverage
   redis-cli -h <host> -p <port> CONFIG GET cluster-allow-reads-when-down
这决定了“覆盖不全”会变成“整体停摆”还是“降级服务只读”。 -
最后再看客户端。 服务端
cluster_state:ok但应用还在报错,大概率是客户端的 topology 还没刷新、某条连接网络不通,或者客户端库自己的require_full_coverage在作祟。这一层和服务端是分开的,别混着查。
整条链路串起来就是:节点是否真 FAIL → 它的 slot 是否 uncovered → 副本是否 failover 成功 → slots_fail 是否大于 0 → require-full-coverage 是 yes 还是 no → cluster_state 是 ok 还是 fail → allow-reads-when-down 是什么 → 客户端是不是因为 CLUSTERDOWN 或 topology 刷新而表现为“整个 Redis 不可用”。
总结:它管的是 slot 覆盖,不是节点死活
把整件事压成一句话:
cluster-require-full-coverage控制的不是“节点挂了 Redis 还能不能用”,而是“16384 个 slot 无法被活着的节点全部覆盖时,集群要不要继续提供部分 key 空间的服务”。
所以下次再看到有人说“一个节点挂了整个 Redis Cluster 就挂了”,你可以补一句:中间还隔着两道关——先看副本有没有 failover 成功把 slot 覆盖补回来,补不回来才轮到这个配置决定是停摆还是降级。真正扛高可用的是副本 failover,这个配置只是在 failover 失败之后,替你在“一致性”和“可用性”之间做一次选择。
默认选了一致性那边。清楚这一点,半夜被叫起来的时候,就知道该先敲 CLUSTER INFO 看 slots_fail,而不是先去数哪台机器还亮着灯。
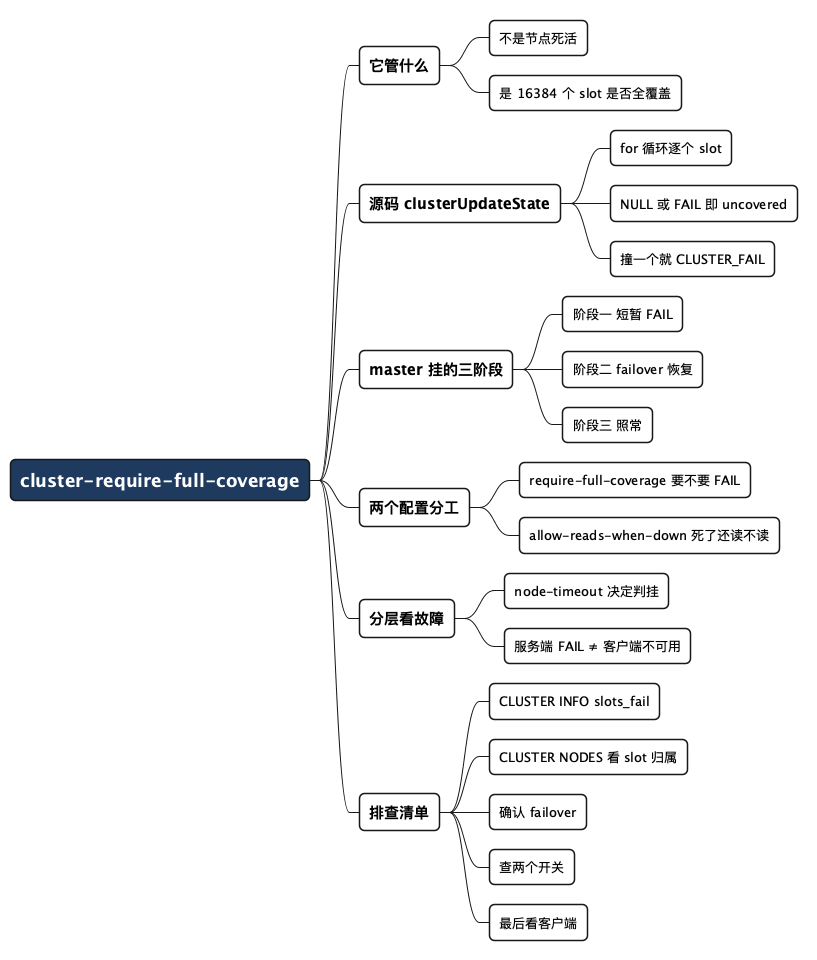
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* cluster-require-full-coverage
** 它管什么
*** 不是节点死活
*** 是 16384 个 slot 是否全覆盖
** 源码 clusterUpdateState
*** for 循环逐个 slot
*** NULL 或 FAIL 即 uncovered
*** 撞一个就 CLUSTER_FAIL
** master 挂的三阶段
*** 阶段一 短暂 FAIL
*** 阶段二 failover 恢复
*** 阶段三 照常
** 两个配置分工
*** require-full-coverage 要不要 FAIL
*** allow-reads-when-down 死了还读不读
** 分层看故障
*** node-timeout 决定判挂
*** 服务端 FAIL ≠ 客户端不可用
** 排查清单
*** CLUSTER INFO slots_fail
*** CLUSTER NODES 看 slot 归属
*** 确认 failover
*** 查两个开关
*** 最后看客户端
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。