AI 语音客服的两道生死坎:延迟和可信度
Posted on 三 30 9月 2026 in Tech
| Abstract | AI 语音客服的两道生死坎:延迟和可信度 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-09-30 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 两道坎:demo 能跑 ≠ 敢上生产,卡住的是延迟和可信度
- 延迟为什么致命:电话里没有表情填补空档,超过一秒的沉默就是灾难
- 延迟怎么构成:从"说完"到"听见回话"的完整瀑布,每段耗多久
- 延迟怎么破:流式是分水岭,句子级流水线,填充词遮盖,就近部署,模型分级
- 可信度的真问题:人工犯错和 AI 幻觉,错法不一样,危险程度不一样
- 五道防线:RAG、工具调用、边界收窄、置信度兜底、护栏审计
- 一个心智模型:把 LLM 当成"会说话但不能碰钱的实习生"
- 端到端语音大模型:在这两个问题上的不同表现
- 两难:延迟和可信度经常打架,只有按场景权衡
MRCP、架构、Lua 代码都齐了,拨个号、说句话、它听懂了回一句——一个 AI 语音客服的 demo,是真能跑起来的。
可你把它拿给业务方看,第一次真实通话,两件事立刻打脸:客户说完话,系统"嗯……"了两秒才吭声,对方已经"喂?喂?"了;好不容易接上话,它信誓旦旦报了个"您本月账单 128 元",一查真实数据——根本不是这个数,它编的。
demo 能跑和敢上生产,中间隔着两道坎:延迟和可信度。 这两坎,前面几篇都绕过去了,这回正面说。
- 主线仍是经典栈(FreeSWITCH + UniMRCP + LLM);文中数字均为行业经验值/参考区间,不是精确实测
- 这两件事经常打架,最后会讲怎么权衡
一、延迟:比你想的更致命,也比你想的更有救
为什么电话对延迟这么苛刻
同样是和 AI 对话,打字聊天你能忍它转好几秒圈,打电话你连一秒都忍不了。差别在于:面对面和文字聊天都有东西填补空档——表情、"正在输入"的提示、肢体语言。电话里只有纯粹的静默,而人对电话沉默的容忍度低得惊人。
几个可参考的经验区间(不同来源略有出入,当作量级感受而非精确基准):
- 传统电话行业里,对话中的"舒适沉默"大约在 500ms 上下。
- 超过 1 秒的静默,用户开始觉得"卡了""它是不是没听懂"。
- 超过 2 秒,很多人会重复一遍,或者直接"喂?喂?"——对话就乱了。
所以延迟优化的目标不是抽象的"总延迟做到多少",而是一个非常具体的靶子:用户听见 AI 第一个字(首响应),压进 ~1 秒。
延迟到底花在哪
先看清敌人。用户说完最后一个字,到听见 AI 第一个字,中间串了这么一条链:
各段大致的量级(经验区间,强依赖模型、网络、实现):
| 环节 | 干什么 | 经验区间 |
|---|---|---|
| 端点检测 endpointing | ASR 判定"这句说完了" | 200~800ms |
| ASR 出文本 | 音频转文字 | 强依赖是否流式 |
| 网络 + 拼 prompt | 到 LLM 网关、组织上下文 | 10~50ms |
| LLM 首 token(TTFT) | 大模型吐出第一个字 | 300ms ~ 2s+ |
| 工具调用(可选) | 查账务/订单等真实接口 | 50ms ~ 数秒 |
| TTS 首个音频块 | 文字转语音、开始出声 | 100~500ms |
一眼就能看出两个大头:LLM 的首 token 延迟(TTFT) 和 可选的工具调用。而如果整条链是"串行等"——等 ASR 全出完 → 等 LLM 全生成完 → 等 TTS 全合成完——那轻轻松松破 2 秒,必然翻车。
破局:把"串行等待"改成"流水线并行"
延迟优化的本质就一句话:别等整句,让链路流水线起来。
1. 全链路流式,这是分水岭。 三段全部开流式:
- ASR 流式:边说边出中间结果,靠 endpointing 尽早判定说完,别傻等静音两秒。
- LLM 流式:开 streaming,拿到第一个完整短语就往下传,不等整段生成完。TTFT 比总生成时间重要得多——用户听到第一个字就不焦虑了,后面的字可以边生成边说。
- TTS 流式:LLM 吐一句,TTS 就合成一句、播一句。绝不能攒齐全文再开口。
流式做到位,用户的体感延迟从"整句时间"压到"第一个短语的时间"。这是能不能用的临界点,不是优化项,是及格线。
2. 句子级流水线(sentence chunking)。 LLM 输出按标点切成句子块:第一句在播的时候,第二句已经在合成了。播放和合成重叠,用户耳朵里是连续的一段话,后台其实还在生成后半句。
3. 填充词遮盖长延迟。 明知道要调一个慢接口(查账务要 3 秒),先垫一句"好的,我帮您查一下"再去调。这句话本身消耗 1~2 秒,用户听着是自然应答,而不是死寂。这是真人客服的本能——没人会闷不吭声查半天——AI 也得学会。
4. 就近部署,砍网络往返。 ASR / LLM / TTS 尽量同机房甚至同机。语音链路里每个跨机房 RTT 都是几十毫秒净损失,一轮对话来回好几次,累起来很可观。
5. 模型分级,不是每轮都上最强的。 简单的意图分类、闲聊用小模型(TTFT 低),复杂推理才上大模型。甚至可以小模型先秒回一句应答,大模型在后面补内容。
一句话:
优化目标是"首响应"不是"总时长";手段是"流式 + 流水线 + 填充词",把用户能感知的等待,藏进后台的并行里。
二、可信度:AI 会一本正经地胡说
"人工客服尚且会犯错,凭什么要求 AI 不错?" 这个反问很对,但要看清:人工犯错和 AI 幻觉,错法不一样,危险程度也不一样。
| 人工客服的错 | AI 的幻觉 | |
|---|---|---|
| 错因 | 知识盲区、口误、态度 | 模型"脑补"了不存在的事实 |
| 语气 | 通常带犹豫,客户能感觉到 | 完全自信,毫无破绽 |
| 边界 | 错得"有边界" | 能编出细节完整的假信息 |
| 客户能否分辨 | 往往能 | 几乎无法分辨 |
危险就在这:AI 会用完全笃定的语气编造一个不存在的优惠、报错一个余额、承诺一个做不到的政策,而客户完全听不出破绽。在客服场景,这就是合规和信任事故。
所以对付幻觉,不能指望"让 LLM 更聪明"——它再聪明也会自信地错。得靠架构给它套缰绳。核心思想:
不让 LLM 自由发挥事实,只让它做擅长的事(理解语言、组织表达);所有事实,来自可信数据源。
五道防线

第一道:RAG——答案从知识库来,不从模型脑子里来。 业务问题(套餐说明、政策、FAQ)先去检索企业知识库,把检索到的真实条目塞进 prompt,让 LLM 基于给定材料回答,而不是凭记忆回答。system prompt 里划死:"只依据提供的资料回答,资料里没有就说不知道。"
第二道:事实必须走工具调用,LLM 不许自己填。 涉及金额、余额、订单状态、账户信息这类具体事实,一律来自工具调用(function calling)的真实接口返回,禁止 LLM 生成。LLM 只负责"决定调哪个工具、怎么把返回结果说得自然"。这是幻觉防控最硬的一条——开头那个"128 元",就是没守住这条:让 LLM 报了本该来自账务接口的数字。
第三道:收窄权限和话题边界。 system prompt 明确职责:只处理业务范围内的事,超出一律"这个问题我帮您转人工"。范围越窄越可控。别让一个客服机器人去回答"今天天气怎样",那是在给幻觉开口子。
第四道:置信度 + 兜底,该转人工就转。
- ASR 置信度低 → 复述确认("您是说查 9 月的账单吗?")
- LLM 反复答非所问,或命中高风险意图(投诉、退款、销户)→ 干脆转人工
- 关键操作(改密码、扣费)→ 二次确认或强制转人工
知道自己不知道、并且干脆利落地移交,本身就是可信度的一部分。硬聊比转人工危险得多。
第五道:护栏 + 事后审计。
- 输出护栏:回复发给用户前过一道校验——有没有承诺不该承诺的、泄露不该说的(另一个 LLM 或规则引擎来查)。
- 全程可追溯:每通对话的 ASR 文本、LLM 输入输出、工具调用、最终回复全部落日志。出问题能复盘,也能拿真实对话持续优化 prompt 和知识库。
一个好用的心智模型
把 LLM 当成一个"很会说话,但不能碰钱、不能碰数据的实习生"。
让它负责理解客户、组织语言、决定流程走向;所有涉及事实和操作的,都通过受控的工具去做,并且留痕、可审计、有兜底。这个比喻能帮你在设计每一个环节时快速判断:这一步该不该让 LLM 自己拿主意?
按风险分级授权
不同意图给不同的处理权限,别一刀切:
| 风险级别 | 例子 | 处理方式 |
|---|---|---|
| 只读信息 | 查话费、查套餐说明 | LLM + RAG/工具,可自动答 |
| 低风险操作 | 修改无关紧要的偏好 | 工具调用 + 二次确认 |
| 高风险操作 | 退款、销户、改密码 | 强制转人工,或严格身份核验 |
| 情绪/投诉 | 客户明显不满 | 优先转人工,别让 AI 火上浇油 |
三、端到端语音大模型:换个架构,这两个问题变了吗
前面讲的都是经典栈(ASR → LLM → TTS 三段拼接)。最近另一条路——端到端语音大模型(speech-to-speech,音频直接进、音频直接出,ASR/TTS 内化进模型)——在这两个问题上表现很不一样,值得对照:
| 经典栈(本系列主线) | 端到端语音大模型 | |
|---|---|---|
| 延迟 | 需自己做全链路流式,组件间有往返 | 天然更低——少了组件拼接的往返和转换 |
| 可信度 | RAG/工具/护栏每一环都能插手,可控可审计 | 更难控——中间是黑盒,幻觉和事实注入更难约束 |
| 工具调用 | 成熟,function calling 好接 | 支持程度和可控性因平台而异 |
| 审计 | 每段都有文本,天然可留痕 | 音频进音频出,中间文本未必可见 |
一句话对照:端到端在延迟上占便宜,在可信度和可审计上吃亏。 客服这种强合规、要留痕、事实不能错的场景,经典栈的"每一环都能插手"反而是优势。追求极致自然对话体验、且能接受黑盒的场景,端到端更香。
现实里不少团队用经典栈打底(稳、可控),在高价值场景试点端到端。架构选型从来不是选最先进的,是选最匹配你约束的。
四、点破真相:这两件事经常打架
写到这你可能已经嗅到了张力:延迟和可信度,是一对矛盾。
- 加 RAG 检索、加工具调用、加输出护栏 → 可信度上去了,但每一步都是延迟。
- 一味追求快、砍掉检索和确认 → 快了,但幻觉和错误率上去了。
工程上没有免费的午餐,只有按场景权衡:
- 简单只读查询 → 偏向快:轻检索、不确认,让它秒回。
- 高风险操作 → 偏向稳:该慢就慢,该确认就确认,该转人工就转。宁可慢,不可错。
- 用填充词把"稳"带来的延迟遮盖过去 → 这是同时兼顾两者最实用的技巧:一边说着"我帮您核实一下",一边在后台做检索、工具调用、护栏校验。
换句话说,不存在一套"又快又稳"的通用参数。你要做的是给不同风险的场景,配不同的快慢档位。
总结:能上生产的语音 AI,拼的不是模型,是工程
回到开头那两次打脸——两秒的沉默,和那个编出来的"128 元"。
它们都不是模型不够强导致的,恰恰相反:模型已经够强了,卡住的是工程。
三句话记住:
- 延迟:盯"首响应"而不是"总时长"。流式是及格线,句子级流水线 + 填充词把可感知的等待藏进后台并行,首响应压进 ~1 秒。
- 可信度:别让 LLM 更聪明,给它套缰绳。五道防线——RAG、工具调用、边界收窄、置信度兜底、护栏审计。把它当"会说话但不能碰钱的实习生"。
- 权衡:这两件事经常打架,没有又快又稳的通用解,只有按风险分级配快慢档。
整条路是这样的:协议(MRCP)→ 架构(分工)→ 代码(Lua)→ 工程(延迟与可信)。前面三段解决"怎么搭起来",延迟和可信度解决"怎么敢上线"。
真正的门槛从来不是"能不能跑通",而是跑通之后,那些让人半夜被叫醒的边界情况,你有没有一个一个填平。语音 AI 客服拼到最后,拼的不是谁的模型强,是谁的工程细。
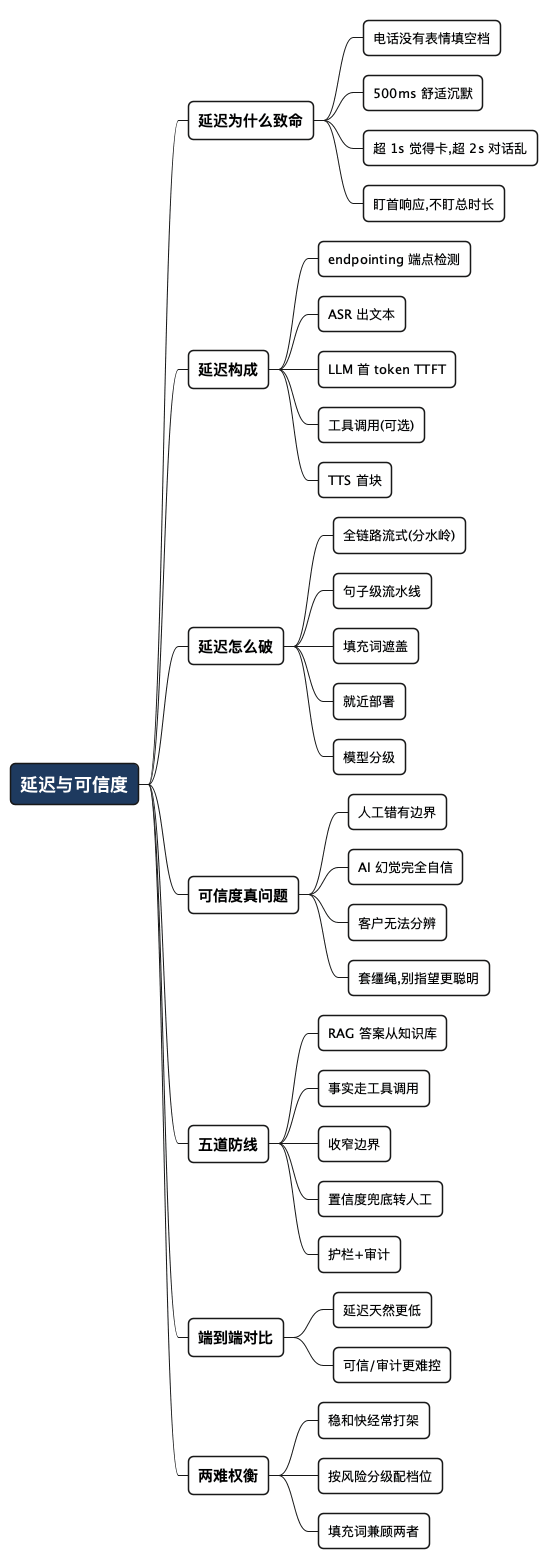
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* 延迟与可信度
** 延迟为什么致命
*** 电话没有表情填空档
*** 500ms 舒适沉默
*** 超 1s 觉得卡,超 2s 对话乱
*** 盯首响应,不盯总时长
** 延迟构成
*** endpointing 端点检测
*** ASR 出文本
*** LLM 首 token TTFT
*** 工具调用(可选)
*** TTS 首块
** 延迟怎么破
*** 全链路流式(分水岭)
*** 句子级流水线
*** 填充词遮盖
*** 就近部署
*** 模型分级
** 可信度真问题
*** 人工错有边界
*** AI 幻觉完全自信
*** 客户无法分辨
*** 套缰绳,别指望更聪明
** 五道防线
*** RAG 答案从知识库
*** 事实走工具调用
*** 收窄边界
*** 置信度兜底转人工
*** 护栏+审计
** 端到端对比
*** 延迟天然更低
*** 可信/审计更难控
** 两难权衡
*** 稳和快经常打架
*** 按风险分级配档位
*** 填充词兼顾两者
@endmindmap
参考资料
- RFC 6787 - MRCPv2
- 系列前三篇:MRCP 协议入门、FreeSWITCH + UniMRCP + LLM 语音智能体、用 Lua 写 Dialplan 接 LLM(本站)
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。