MRCP 协议入门:让 SIP 呼叫用上语音识别与合成的那根控制通道
Posted on 日 27 9月 2026 in Tech
| Abstract | MRCP 协议入门:让 SIP 呼叫用上语音识别与合成的那根控制通道 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-09-27 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 它解决什么问题:媒体流在 RTP 上跑,但"什么时候识别、用什么语法、合成哪段文本"需要一根独立的控制通道,这就是 MRCP
- 它不是独立协议:MRCP 自己不建会话,靠 SIP/SDP 协商、靠 RTP 传音频,自己只管"控制"
- v1 vs v2:v1 走 RTSP,v2 走 SIP+SDP,两者不互通、没有网关、没有迁移路径
- 四类资源:合成器(TTS)、识别器(ASR)、录音器、说话人验证,各有一套方法和状态机
- 消息模型:请求 / 响应 / 事件三类,响应里 PENDING/IN-PROGRESS/COMPLETE 是关键
- 一次识别的完整流转:从 INVITE 到 RECOGNIZE 到 RECOGNITION-COMPLETE,逐条拆
- UniMRCP 落地:一个 Apache 2.0 的开源实现,客户端 / 服务端 / 插件三层怎么分
- 典型场景:IVR、语音信箱、语音验证、和 FreeSWITCH 对接
- 最佳实践与常见坑:barge-in、超时、TLS、语法缓存、通道复用
你已经用 FreeSWITCH 接通了一路电话,RTP 音频在双向流动。现在产品经理说:"能不能让用户直接说话,系统听懂了自动办业务?顺便再用合成的声音把结果念出来。"
于是你接了一个 ASR(Automatic Speech Recognition,自动语音识别)引擎和一个 TTS(Text-to-Speech,语音合成)引擎。音频有了,引擎也有了,但很快你会撞上一个问题:媒体流只是一串音频字节,它不会告诉引擎"现在这段该开始识别了""识别要用这套语法""识别到就停"。你需要另一根线,专门下达这些指令、接收这些结果。
这根线,就是 MRCP(Media Resource Control Protocol,媒体资源控制协议)。说白了:SIP/RTP 负责把音频送到语音引擎门口,MRCP 负责隔着门喊话——告诉引擎干什么、什么时候干、干完把结果递回来。
- MRCP 是控制协议,不是传输协议,更不是语音引擎本身
- 它离不开 SIP/SDP/RTP——自己不建会话、不传音频,只管发指令收结果
一、MRCP 到底站在哪一层
先把语音栈的分工摆清楚。一次"打电话给机器人办业务"的通话,至少有三层协议在协作:
| 层次 | 协议 | 干什么 | 类比 |
|---|---|---|---|
| 信令层 | SIP + SDP | 建立/拆除会话,协商用哪些资源、开哪些端口 | 打电话前的"接线、约定频道" |
| 媒体层 | RTP / RTCP | 双向传输实际的音频字节 | 电话线里流动的声音 |
| 控制层 | MRCP | 告诉语音引擎"开始识别/合成这段/用这个语法",并回传结果 | 隔着玻璃对录音棚里的人喊"3、2、1,开始" |
RFC 6787 里对 MRCP 的定位说得很直白:MRCPv2 不是一个"独立"协议。它依赖 SIP 来协调客户端与服务端、管理它们之间的会话,依赖 SDP 来描述和交换能力,还依赖 SIP/SDP 在媒体源(或媒体宿)与媒体服务器之间建立媒体会话。这些都就绪之后,MRCP 的交互才在上面那条已经建好的控制会话里跑起来。
换个说法:MRCP 是个"寄生"协议。它自己既不认识对方的地址,也不知道音频从哪个端口来,这些全靠 SIP/SDP 事先谈好。它只负责一件事——在已经建好的控制通道上,对语音资源发号施令。
这个定位很重要,因为它解释了为什么 MRCP 服务器几乎总是和一个 SIP 栈捆在一起部署。你不会单独跑一个 MRCP,就像你不会单独跑一个"遥控器"却没有电视。
二、v1 和 v2:两个同名但不通的协议
MRCP 有两个版本,而这两个版本的关系有点尴尬——同名,但根本不是一路货。
- MRCPv1(RFC 4463):由 Cisco、Nuance、SpeechWorks 早年联合开发,走的是 RTSP(实时流协议)。它把控制消息塞进 RTSP 的信道里传。
- MRCPv2(RFC 6787,2012 年成为 IETF 标准):改走 SIP + SDP 建会话,控制消息则单独通过一条 TCP(或 TLS)连接传输。
为什么要换掉 RTSP?RFC 6787 的引言里给了原因:当年在 RTSP 上跑 MRCP 的做法,被认为会"破坏 RTSP 协议或造成向后兼容问题",而 SPEECHSC 的需求(RFC 4313)明确禁止这么干。所以 MRCPv2 干脆不再基于 RTSP。
最需要记住的一条:v1 和 v2 不互通。RFC 6787 写得毫不含糊——不指望 MRCPv2 客户端能和 MRCPv1 服务器协作,反之亦然;两者之间没有迁移方案,也没有网关定义。第一版 MRCP 基本上"只是作为开发 v2 的输入参考"。
| 维度 | MRCPv1 (RFC 4463) | MRCPv2 (RFC 6787) |
|---|---|---|
| 会话建立 | RTSP | SIP + SDP |
| 控制消息传输 | 复用 RTSP 信道 | 独立 TCP / TLS 连接 |
| 起始行格式 | SPEAK 543257 MRCP/1.0 |
MRCP/2.0 <len> SPEAK 543257 |
| 资源寻址 | RTSP URL | SIP URI(如 sip:mrcpv2@example.net) |
| 状态 | 早期专有方案的规范化 | 现行 IETF 标准 |
| 互通性 | 与 v2 不互通,无网关 | 与 v1 不互通,无网关 |
新项目基本都用 v2,但存量系统里 v1 还活着,尤其是一些老牌 IVR 平台。选型时先确认对端说的是哪个版本——这不是小数点后的差别,是两个协议。
三、四类媒体资源
MRCPv2 把语音服务器上的能力抽象成几类"媒体资源"(Media Resource),每类资源有自己的一组方法、事件和状态机。RFC 6787 定义了这几种 IANA 注册的资源类型:
| 资源类型标识 | 资源 | 干什么 |
|---|---|---|
speechsynth |
语音合成器(Speech Synthesizer) | 把文本(通常是 SSML)合成为语音,完整支持 SSML |
basicsynth |
基础合成器(Basic Synthesizer) | 能力受限,只能拼接音频片段,SSML 支持是子集 |
speechrecog |
语音识别器(Speech Recognizer) | 接收音频流,按语法识别,并做语义解释 |
dtmfrecog |
DTMF 识别器 | 识别按键音(DTMF),按数字语法匹配 |
recorder |
录音器(Recorder) | 录音并给出录音文件的 URI,自带端点检测(去掉首尾静音) |
speakverify |
说话人验证(Speaker Verification) | 拿音频和已有声纹比对,验证"你是不是你"(或做说话人识别) |
每类资源都有自己的核心方法。挑几个最常用的:
- 合成器(TTS):
SPEAK(合成并播放)、STOP、PAUSE、RESUME、BARGE-IN-OCCURRED(用户打断);事件有SPEAK-COMPLETE、SPEECH-MARKER。 - 识别器(ASR):
DEFINE-GRAMMAR(预加载语法)、RECOGNIZE(开始识别)、GET-RESULT、START-INPUT-TIMERS、STOP、INTERPRET;事件有START-OF-INPUT(检测到用户开口)、RECOGNITION-COMPLETE。 - 录音器:
RECORD、STOP;事件有START-OF-INPUT、RECORD-COMPLETE。 - 说话人验证:
START-SESSION、VERIFY、VERIFY-FROM-BUFFER、END-SESSION;事件有VERIFICATION-COMPLETE。
这里有个设计上的关键点:一个 SIP 会话里,每类资源要单独一条控制通道。你要同时用 TTS 和 ASR,就得在 SDP 里放两条控制用的 m= 行,服务器为每条通道分配一个不重复的 Channel-Identifier(通道标识)。所有 MRCP 消息都带着这个标识,服务器靠它区分这条消息是发给哪个资源的。
四、消息模型:请求、响应、事件
MRCP 的消息是文本格式的(可以携带内嵌的二进制数据),长得很像 HTTP——起始行 + 一堆头字段 + 空行 + 消息体。一共三类消息:
- 请求(Request):客户端发给资源的指令,如
SPEAK、RECOGNIZE。 - 响应(Response):服务器对请求的即时回执,带一个状态码和一个请求状态。
- 事件(Event):服务器在处理过程中主动推送的异步通知,如
START-OF-INPUT、RECOGNITION-COMPLETE。
最容易被新手忽略、也最关键的,是响应里的请求状态。因为语音识别、合成天然是异步的——你发一个 RECOGNIZE,不可能立刻就有结果,得等用户开口、说完、引擎算完。所以响应里会带三种状态之一:
| 请求状态 | 含义 | 后续 |
|---|---|---|
PENDING |
请求已排队,还没开始处理 | 排在当前请求之后,等着 |
IN-PROGRESS |
请求正在处理中 | 稍后会有事件通知最终结果 |
COMPLETE |
请求处理完毕 | 响应本身就是终态,不会再有事件 |
理解这三个状态,你就理解了 MRCP 交互的节奏:发请求 → 收到 IN-PROGRESS 响应(表示"收到了,正在办")→ 一段时间后收到 RECOGNITION-COMPLETE 事件(带着真正的结果)。别把响应当成结果——响应往往只是"我开始干了"的回执,结果在后面的事件里。
一条真实的 MRCPv2 RECOGNIZE 请求长这样(节选自协议规范风格的样例):
MRCP/2.0 903 RECOGNIZE 543257
Channel-Identifier:32AECB23433801@speechrecog
Confidence-Threshold:0.9
Content-Type:application/srgs+xml
Content-ID:<request1@form-level.store>
Content-Length:702

<?xml version="1.0"?>
<grammar xmlns="http://www.w3.org/2001/06/grammar"
        xml:lang="en-US" version="1.0" root="request">
     ...
</grammar>
拆开看:
MRCP/2.0 903 RECOGNIZE 543257:版本、整条消息长度、方法名、请求 ID。Channel-Identifier:这条消息发给哪个资源通道(@speechrecog说明是识别器)。Confidence-Threshold:置信度门槛,低于 0.9 不算识别成功。Content-Type+ 消息体:这次识别要用的语法(这里是 W3C 的 SRGS 语法)。
对比一下合成请求 SPEAK,消息体换成了 SSML(语音合成标记语言):
MRCP/2.0 732 SPEAK 543257
Channel-Identifier:32AECB23433802@speechsynth
Voice-gender:neutral
Content-Type:application/ssml+xml
Content-Length:...

<?xml version="1.0"?>
<speak version="1.0" xml:lang="en-US">
  <p><s>You have 4 new messages.</s></p>
</speak>
识别的结果,则通过 RECOGNITION-COMPLETE 事件回传,消息体是 NLSML(Natural Language Semantics Markup Language,自然语言语义标记语言)格式,里面带着识别文本和语义解释,以及置信度:
<result>
  <interpretation confidence="0.97">
    <instance>...</instance>
    <input mode="speech">I want to fly to Boston</input>
  </interpretation>
</result>
五、一次识别的完整流转
把上面的碎片拼起来,看一次"用户对着 IVR 说话、系统识别"在协议上到底怎么走。这里以 MRCPv2 为例:
几个地方要留意:
- 阶段一二三分工清楚:SIP 管建会话、SDP 管协商通道和端口、RTP 管音频、MRCP 管控制。这四者各司其职,少了哪个都跑不起来。
- 控制通道是独立的 TCP 连接:SDP answer 里服务器会给出一个 TCP 监听端口(SDP offer 里客户端按规范填 discard 端口 9),客户端再连过去建 MRCP 控制连接。多条 MRCP 通道可以复用同一条 TCP 连接,靠 Channel-Identifier 区分。
RECOGNIZE之后先收到IN-PROGRESS,再收到RECOGNITION-COMPLETE:前者是回执,后者才是结果。中间还可能插一个START-OF-INPUT,告诉你"用户开口了",这对做 barge-in(打断播报)特别有用。
六、UniMRCP:一个能上手的开源实现
协议说清楚了,拿什么落地?最主流的开源实现是 UniMRCP(https://github.com/unispeech/unimrcp),Apache 2.0 许可,C/C++ 写的,同时支持 MRCPv1(RTSP)和 MRCPv2(SIP+SDP)。它的 README 里明确写着兼容 RFC 6787 和 RFC 4463。
它的分层很清晰,理解这几层你就知道代码该往哪找:

几个关键落点(都来自源码目录,不是我编的):
- 可运行的程序:服务端是
unimrcpserver(入口platforms/unimrcp-server/src/main.c),客户端示例有umc(C++,platforms/umc/)和unimrcpclient(C)。想跑起来看效果,直接编译后跑unimrcpserver+umc就能走通一次合成或识别。 - 插件模型:每类语音引擎是一个插件,导出
mrcp_plugin_create()。注意:in-tree 自带的都是 demo 插件——demo-synth、demo-recog、demo-verifier加一个真实的mrcp-recorder。真正的引擎桥接(如早年的 PocketSphinx、Flite)已经被移出主源码树到外部方案目录了。所以你想接真实的 ASR/TTS 引擎(比如接一个云端识别),得自己照着插件接口写桥接,或者用外部插件。 - 信令双栈:MRCPv2 的 SIP+SDP 靠
modules/mrcp-sofiasip/(基于 Sofia-SIP 库,LGPL),MRCPv1 的 RTSP 靠modules/mrcp-unirtsp/。 - 媒体与编解码:
libs/mpf/(Media Processing Framework)管 RTP/RTCP 和编解码,自带 G.711、G.722、AMR、linear 等。
七、典型应用场景
MRCP 不是新东西,它在电话语音领域已经是事实标准。几个最常见的落地场景:
- IVR / 语音导航:传统按键菜单("普通话请按 1")升级成"直接说出你要办的业务"。VoiceXML 平台 + MRCP 服务器是经典组合,RFC 6787 引言里就把 VoiceXML 分布式 IVR 列为主要目标场景。
- 语音信箱 / 通话录音:用 Recorder 资源录音,自带端点检测能去掉首尾静音、给出录音 URI。
- 呼叫中心的语音质检 / 转写:把通话音频实时送识别器,转成文本做后续分析。
- 声纹验证:银行、电信客服里的"念一段话验证身份",对应 Speaker Verification 资源。
- 和 FreeSWITCH 对接:FreeSWITCH 有
mod_unimrcp模块,内置一个 MRCP 客户端。你在 dialplan 里调play_and_detect_speech之类的应用,底层就是 FreeSWITCH 作为 MRCP 客户端,去连一个 MRCP 服务器(比如 UniMRCP server 或商业引擎)。这正好接上了前面几篇讲的 FreeSWITCH 呼叫处理——MRCP 是给已经接通的呼叫加上"听懂"和"会说"的那一层。
八、最佳实践与常见坑
结合协议规范和 MRCP 工程的常见问题,列一份能直接对照的清单。
最佳实践:
- 优先用 v2,选型先对齐版本。除非你在维护存量 v1 系统,新项目一律 MRCPv2。上来先确认对端是 v1 还是 v2——它俩不互通。
- 控制通道上 TLS。RFC 6787 要求客户端和服务器都必须实现 TLS(
TCP/TLS/MRCPv2)。控制通道里跑的是语法、识别结果这些可能带敏感信息的数据,生产环境别裸奔。 - 善用
DEFINE-GRAMMAR预加载语法。频繁用到的语法先DEFINE-GRAMMAR加载好、拿到引用,后续RECOGNIZE直接引用,省去每次重复传输和编译语法的开销。 - 正确处理 barge-in(打断)。TTS 在播报时用户开口了,识别器发来
START-OF-INPUT,这时客户端应该停掉合成(靠Kill-On-Barge-In头或主动STOP),让用户能打断机器。体验好坏往往就差在这一下。 - 配好各种超时。识别器有
No-Input-Timeout(等了半天没人说话)、Recognition-Timeout、Speech-Complete-Timeout(说完多久算结束)。这些直接决定了"用户不说话时系统多久放弃""用户说完多快给结果",要按业务调。 - 复用 TCP 连接。多条 MRCP 通道可以共享一条 TCP 连接,靠 Channel-Identifier 区分。高并发下别为每个通道都开新连接。
常见坑:
| 坑 | 现象 | 原因 / 解法 |
|---|---|---|
| 把响应当结果 | 发了 RECOGNIZE,拿到 200 就去读结果,发现是空的 |
200 往往是 IN-PROGRESS 回执,真正结果在 RECOGNITION-COMPLETE 事件里 |
| v1/v2 混用 | 客户端连不上服务器,或握手就失败 | 两者协议栈完全不同(RTSP vs SIP),不互通,先对齐版本 |
| 忘了独立控制通道 | 想同时用 TTS+ASR,只协商了一条通道 | 每类资源要一条 m= 控制行 + 一个独立 Channel-Identifier |
| SDP 端口理解错 | offer 里填了真实端口,握手异常 | 规范要求 offer 里 TCP 填 discard 端口(9),真实监听端口在 answer 里由服务器给 |
| barge-in 不生效 | 用户打断了,机器还在自顾自念 | 没处理 START-OF-INPUT 事件,或没设 Kill-On-Barge-In |
| 语法每次重传 | 高并发下延迟高、服务器 CPU 飙 | 用 DEFINE-GRAMMAR 预加载 + 引用,别每次 RECOGNIZE 都内联整份语法 |
总结:MRCP 是给通话加上"听懂"和"会说"的控制层
回到开头那个问题:音频在 RTP 上跑,谁来告诉引擎"现在开始识别"?答案就是 MRCP。
几句话记住它:
MRCP 是控制协议,不是传输协议。 它自己不建会话、不传音频,靠 SIP/SDP 协商、靠 RTP 传声音,只负责在控制通道上对语音资源发指令、收结果。
三个最该记住的点:
- 分工:SIP 建会话、SDP 协商通道、RTP 传音频、MRCP 发控制——四层协作,缺一不可。
- 异步:响应里的
IN-PROGRESS只是回执,结果在后面的事件里。这是理解 MRCP 交互节奏的钥匙。 - 落地:开源用 UniMRCP,和 FreeSWITCH 对接用
mod_unimrcp;自带的是 demo 插件,接真实引擎要自己写桥接。
如果你正在做语音相关的产品,下一步很自然:编译一份 UniMRCP,用 umc 跑通一次 demo 识别,抓包看看 SIP INVITE → RECOGNIZE → RECOGNITION-COMPLETE 这一串到底长什么样。协议这东西,读十遍规范不如抓一次真实的包。
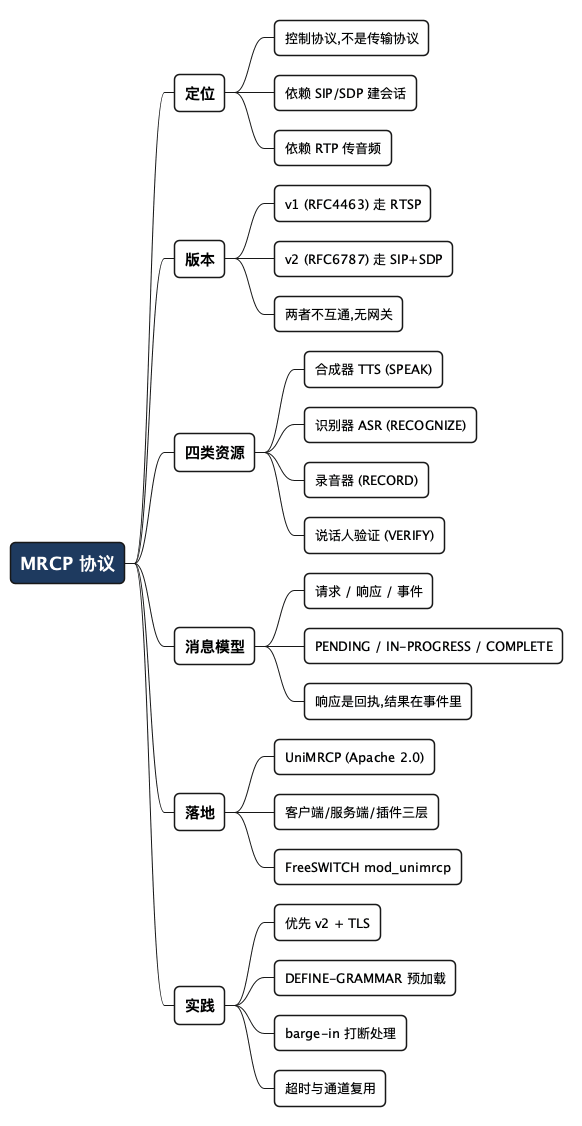
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* MRCP 协议
** 定位
*** 控制协议,不是传输协议
*** 依赖 SIP/SDP 建会话
*** 依赖 RTP 传音频
** 版本
*** v1 (RFC4463) 走 RTSP
*** v2 (RFC6787) 走 SIP+SDP
*** 两者不互通,无网关
** 四类资源
*** 合成器 TTS (SPEAK)
*** 识别器 ASR (RECOGNIZE)
*** 录音器 (RECORD)
*** 说话人验证 (VERIFY)
** 消息模型
*** 请求 / 响应 / 事件
*** PENDING / IN-PROGRESS / COMPLETE
*** 响应是回执,结果在事件里
** 落地
*** UniMRCP (Apache 2.0)
*** 客户端/服务端/插件三层
*** FreeSWITCH mod_unimrcp
** 实践
*** 优先 v2 + TLS
*** DEFINE-GRAMMAR 预加载
*** barge-in 打断处理
*** 超时与通道复用
@endmindmap
参考资料
- RFC 6787 - Media Resource Control Protocol Version 2 (MRCPv2)
- RFC 4463 - A Media Resource Control Protocol (MRCP)
- UniMRCP - 开源 MRCP 实现
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。