评估 AI Skills 和知识库:自己写的技能,可能比不装还差
Posted on in Tech
| Abstract | 评估 AI Skills 和知识库:自己写的技能,可能比不装还差 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-11-13 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- **一个反直觉的发现**:SkillsBench 发现自己写的 Skill 可能比不装还差 - **评估框架**:把“看起来像”换成“测出来”——Skill 怎么测、内容怎么测 - **“靠不靠谱”问错了问题**:生成、验证、维护,这是三笔不同的账 - **落地:五条用得上的做法**:风险分级验证、确定性检查、gold test、A/B 对比 - **常见陷阱**:把页面数当成果、自造技能顶替精心设计、AI 审 AI 的幻觉放大 - **附录**:一张能贴墙的检查清单 - **总结**:省下来的是打字的时间,不是判断的时间最近这半年我陆续用 PKB 相关的技能(project-knowledge-base、graphify 这一类)跑过几个项目,体验很一致:一声令下,Markdown 文件、架构说明、ADR 唰唰地就生成出来了,页面数量看着挺可观。可是真坐下来逐页看,不少内容经不起推敲——结构工整,用词漂亮,但细节站不住,或者和另一页悄悄打架。更麻烦的在后面:这些页面以后谁来更新、怎么知道它还对不对,变成了一个全新的、比写文档本身更难的问题。
这不是我一个人的毛病。这篇文章想回答两个问题:AI 生成的知识库内容和 AI Skill,到底怎么判断它有没有用;用 AI 来建设和维护知识库,这件事本身靠不靠谱。 答案不是“看情况”这种和稀泥的说法,而是一套能落地的判断框架——外加一个会让人愣一下的研究结论打底。
一个反直觉的发现:自己写的技能,可能比不装还差
先说这个打底的结论。Anthropic 等团队提出的 Agent Skills 概念,是把“怎么干这活”打包成一个文件夹让模型按需加载——我上一篇《Agent Skills 落地指南》拆过它的结构。问题是:一个 Skill 到底有没有用,光读起来像不像专业文档说了不算。
2026 年的论文 SkillsBench(arXiv:2602.12670)给了一个成对测试:同一批 87 个任务,分别在“不装 Skill”和“装经过策划(curated)的 Skill”两种条件下跑 18 种模型-工具组合。结果是策划过的 Skill 把平均通过率从 33.9% 拉到 50.5%,提升 16.6 个百分点——这证明 Skill 这个机制本身是有效的。
但论文接着做了一个更扎心的对照:让 Agent 先用 Anthropic 官方的 skill-creator 自己给自己写 Skill,再拿这份自造的 Skill 去解同样的任务。结果这份自造 Skill 在三种工具组合上全部低于不装任何 Skill 的基线——Claude Code + Opus 4.7 上掉 8.1 个百分点,Codex + GPT-5.5 上掉 11.3 个百分点,Gemini CLI + Gemini 3.1 Pro 上掉 11.5 个百分点。论文还有一个更现实的数字:拿到的真实世界 Skill 样本,质量均分只有 6.2/12,而论文自己精心策划的基准 Skill 均分是 10.1/12。
一份 AI 自己写的说明书,可能比没有说明书更糟。 不是 Skill 机制不好,是没人把关的那份“写得像模像样”的文档,正在悄悄教坏模型。
同一方向上,另一篇《A Framework for Evaluating Agentic Skills at Scale》(arXiv:2606.17819)在 500 个真实开源 Skill、1000 个生成任务上做了同样的“有没有这个 Skill”对照,结论一致:Skill 带来的提升主要来自“指令遵循”维度,而这个提升幅度因 Skill 质量差异极大——有没有用,必须测出来,不能靠读起来顺不顺眼去猜。
这条结论直接回应了我开头的困惑:PKB 技能生成的那些页面“看起来洋洋洒洒”,恰恰符合“未经策划的真实世界 Skill 均分只有策划样本一半”这个现象——生成端的流畅度,和它实际有没有用,是两件事。
评估框架:把“看起来像”换成“测出来”
既然“读起来专不专业”靠不住,那该测什么?Skill 和知识库内容要分开测,维度也不一样。
测 Skill:有没有它,结果不一样。 Anthropic 给 skill-creator 加的内置评测工具就是这个思路(claude.com):写一组测试 prompt,定义“好”的标准,跑 benchmark 模式记录通过率、耗时、token 用量;再用一个不知道哪份是哪份的“比较器 Agent”去盲比 Skill A 和 Skill B、或者“有 Skill”和“没 Skill”。关键不是看 Skill 文档写得漂不漂亮,而是跑一轮有/无对照,拿真实任务通过率说话。
测知识库内容:拆成能分别打分的几个维度,而不是问一句“这篇写得怎么样”。 Document360 提出的四柱框架(document360.com)是个很具体的参考:
| 维度 | 权重 | 测什么 | 怎么测 |
|---|---|---|---|
| 可信(Trust) | 35% | 每条事实性断言能不能在源材料里找到依据 | 抽取claim,逐条做自然语言推理(NLI),标“有依据/矛盾/查无依据” |
| 完整(Completeness) | 25% | 源材料里该讲的点,是不是都讲了 | 逐主题比对覆盖率,源里 5 步讲没讲全 5 步 |
| 工艺(Craft) | 25% | 详略是否得当、结构是否顺、有没有“正确但空洞”的废话 | 检测“正确的废话”、营销腔、结构是否按读者需要的顺序排 |
| 合规(Compliance) | 15% | 术语、UI 标签、风格是否和组织规范一致 | 规则+术语表做确定性检查,部分项交给 LLM 判断 |
这张表最值钱的一条是“可信”维度的拆法:50% 看有没有依据(faithfulness)、30% 看有没有自相矛盾(non-contradiction)、20% 看术语实体对不对(entity accuracy)。哪怕只错一条会自相矛盾的断言,这一项分数就会被拉得很低——因为一条自相矛盾的陈述,比十条平庸但一致的陈述更有破坏力。
另一个常被漏掉的区分,来自数据治理公司 Atlan 的分析(atlan.com):检索指标和源内容质量,是两件可以分别失败的事。 他们引用 Deepchecks 的话很精准——“评估关注的是模型说了什么,不是它看到了什么”。团队常年盯着命中率、NDCG、忠实度(faithfulness)这些检索侧指标,却没人追踪“这份被检索到的文档本身有没有人认领、多久没核实过、和另一份文档是否冲突”。下面这张对照表值得贴在评审清单上:
| 今天大家在测的 | 还应该测的 |
|---|---|
| 命中率 / 召回率 | 文档认证率(有没有人审过) |
| NDCG / MRR(排序质量) | 新鲜度覆盖率(有没有设更新 SLA) |
| 忠实度(答案是否贴合上下文) | 所有权覆盖率(有没有责任人) |
| 答案相关性 | 跨文档冲突率 |
一句话:答案听起来对不对,和它引用的文档本身靠不靠谱,是两条独立的曲线,得分开画。
“靠不靠谱”问错了问题:按三个阶段算账
回到“用 AI 建知识库到底靠不靠谱”这个问题——我的判断是,这个问题问得太笼统了。靠谱不靠谱得按三个阶段分别算账,因为 AI 在这三步上改变的东西完全不一样。
生成:确实变便宜了,这一步没什么好争的。 把一堆素材、代码、会议记录转成结构化的初稿,AI 比人快得多,这是实打实的进步,相当于雇了一个不知疲倦的实习生写初稿。
验证:没有变便宜,反而暴露得更彻底。 有篇实践文章把这件事讲得很直白(hotovo.com):
“AI 能让文档生成变得很便宜,但不会让维护文档变得免费。事实上,它可能会增加需要维护的文档总量。”
一个功能改动,AI 可能同时在实现代码、行内注释、一份 spec、docs 目录下的好几篇文档里都留下了说法,而且经常是同一件事被重复表述了好几遍。这几份文档互相之间会不会说法一致,谁都没有把关——这正是“AI slop”这个词想描述的现象。学界给它提炼出三条特征(arXiv:2509.19163):表面胜任(superficial competence)、投入不对称(asymmetric effort)、能大批量生产(mass producibility)。翻译过来就是:读起来挺像那么回事,生成它几乎不花力气,但验证它要不要花力气、花多少力气,完全由内容本身决定——这个不对称,正是“洋洋洒洒却经不起细看”的结构性原因,不是哪次运气不好。
维护:这一步不但没变便宜,反而被放大了。 国内一篇分析企业知识管理四重风险的文章(huxiu.com)引用斯坦福和耶鲁的研究:即便是专业法律 AI 工具,幻觉率也有 17% 到 33%。更值得警惕的是它提出的“综合性幻觉”概念——AI 把几个局部正确的知识片段拼接整合时,可能拼出一个整体错误的结论,这种错误单看每个片段都挑不出毛病,只有看整体才会发现不对。一旦未经验证的内容混进知识库,被别的文档引用、被检索系统召回、被下一次 AI 生成当作“已有共识”去学习,错误就沿着知识链条扩散放大了。这比“一篇文档写错了”严重得多,因为它会自我复制。
把三笔账摆在一起看,问题就清楚了:
flowchart LR
    G["生成<br/>成本:↓↓↓<br/>AI 做得又快又多"] --> V["验证<br/>成本:持平或更难<br/>内容越多,要查的越多"]
    V --> M["维护<br/>成本:↑↑<br/>过期检测靠人;AI 幻觉会被复用放大"]
    M -. "未验证内容被当作已有共识<br/>喂给下一轮生成" .-> G
这条反馈环才是真正的风险:没人把关的产出,会被当成“已经验证过的知识”喂回下一轮生成,错误不是线性累加,是滚雪球。 这也是为什么我自己用 PKB 技能跑出来的那批页面,光靠“生成得快”这个优点,根本盖不住“以后谁来验证、谁来发现它过期”这个新增的负债。
落地:五条用得上的做法
既然问题出在验证和维护没有跟上,解法也得往这两步使劲,而不是继续在生成端卷。
-
按风险分级验证,别一刀切。 国内一些团队的做法是“双库协同”:用户提问先查人工审核过的传统知识库,只有传统库答不上来才启用 AI 生成(huxiu.com)。微软 Copilot 的“接地检查”(grounding check)走的是另一条路:把 AI 输出和授权知识库交叉验证,标出无法溯源的内容。两种做法的共同逻辑是:合规、客户交付、战略判断这类高风险内容必须过人工审核;内部参考、日常查询这类低风险场景可以让 AI 直接出。 验证节点要嵌进流程里,不能靠“大家自觉”。
-
测试 Skill 用有/无对照,别靠通读。 照着 SkillsBench 和 Anthropic skill-creator 评测工具的思路,上线前至少跑一组“装了这个 Skill vs 不装”的真实任务对比,记下通过率差值。差值为负或接近零,这个 Skill 现在就不该用,不管它的 SKILL.md 写得多周正。
-
确定性检查先垫底,它治不了全部但能排除一类错误。 死链检测、frontmatter 格式校验、术语表一致性,这些能写成脚本的检查就别指望人去记得做。某团队把死链检测做进了 CI(hotovo.com)——它不能保证内容准确、完整、有用,但能稳定排除“链接指向一个不存在的页面”这一类错误,这就够了。
-
先把少量内容治理好,再谈覆盖率。 一篇拆解企业知识库建设的文章说得直接(53ai.com):“宁可先做 300 份高质量文档,也不要先上 3 万份未经治理的资料。” 把所有文档一股脑灌进向量库看着全面,实际是在稀释检索质量——这条建议直接对上了我开头那个困惑:生成的页面数量从来不是目标,能不能被信任才是。
-
建一份 gold test suite,用它当验收线,而不是生成完就算完工。 一篇讲企业 AI 评估的文章(deviq.io)主张分层评估——检索对不对、答案准不准、最后才是“一个真实用户会不会信这个答案”——并且强调 AI 能帮忙批量生成候选测试题,但判定题目是否靠谱、答案是否可信,必须由领域专家(SME)来定。这一点我在之前讲领域知识库治理的文章里也用过类似的 golden question 做法,这里的差别是:这次 golden question 评的不是检索链路通不通,是 AI 自己生成的内容本身站不站得住。
常见陷阱,和我自己踩过的那个
| 陷阱 | 症状 | 对策 |
|---|---|---|
| 把页面数当成果 | “这周生成了一堆文档”被当成进度汇报 | 换成“这周有几份通过了验证”,数量不进汇报 |
| 自造 Skill 顶替精心设计的 Skill | 让 Agent 自己给自己写 SKILL.md 就收工 | 至少跑一轮有/无对照测试,差值不达标就别用 |
| AI 审 AI,循环里没有外部信号 | 用另一个 LLM 去判断前一个 LLM 写得好不好 | 高风险内容必须有人工审核节点,LLM-as-judge 只做初筛 |
| 一次性思维,上线即完工 | 建完知识库就认为“能用很多年” | 设新鲜度 SLA、责任人字段,像给服务定 SLI 一样定指标 |
| 只盯检索指标,不查源内容质量 | 命中率、NDCG 很漂亮,内容本身没人认领 | 把认证率、所有权覆盖率、冲突率也纳入监控 |
我自己踩的就是第一个。用 PKB 技能批量产出页面的时候,很容易被“一下子多出这么多文档”的成就感带偏,而没有在生成的同时就把“谁来验证这一页”“多久之后要重新核实”这两个字段写进去。回头看,这两个字段比多生成十页更值钱。
附录:一张能贴墙的检查清单
前面讲的是道理,这一节是能直接抄走的一页。打印贴墙上也行,存进个人笔记也行,用的时候对着打勾。
A. 每篇 AI 生成的内容,放行前 30 秒
- [ ] 有没有责任人(没人认领的页面,注定腐烂)
- [ ] 有没有最后核实日期(last_verified)
- [ ] 关键断言能不能指向源材料(找不到出处的那条,恰是最危险的那条)
- [ ] 有没有和另一页打架(放行前把关键词搜一遍)
- [ ] 写没写失效规则(这一页多久要重新核一次)
B. 每个 Skill 上线前,跑一组再收工
别靠通读 SKILL.md 判断,跑有/无对照:
- 挑 5~10 个真实任务(用最近真被问过的那几个)
- 同一批任务,不装这个 Skill 跑一遍,记通过率
- 装上再跑一遍,记通过率
- 差值 > 0 才留下;负的或接近零的,文档写得多漂亮都先别用
- 顺手记 token 用量和耗时——贵到用不起,同样是另一种“不可用”
C. gold test suite,一份三件套
- 真实问题原样记录,别加工
- 标准答案 + 出处(判定答案对不对,以谁的话为准,先钉死)
- 打分规则分几档(完全正确 / 差一口气 / 答错)——这一层必须由懂行的人来定,AI 只帮忙批量出候选题
D. 巡检节奏
| 频率 | 干什么 | 谁来 |
|---|---|---|
| 每次合入 | 死链、frontmatter、术语一致 | 脚本,进 CI,别靠记性 |
| 每周 | gold test 回归一遍,命中率掉了就查最近改了啥 | 脚本 + 人工抽查 |
| 每季 | 过一遍没人认领的页面:标“历史参考”还是删 | 负责人 |
E. 三条铁的决策规则
- 汇报里报数字,别报“生成了几页”——要说“这几页有几篇过了验证”
- LLM-as-judge 只做初筛,高风险内容必须过人手
- 答不出处的那条结论,删掉或标“待核实”,别留着撑场面
总结:省下来的是打字的时间,不是判断的时间
AI 建知识库、写 Skill 这件事,生成端的进步是真实的,不用否认;但它省下来的只是打字和排版的时间。判断一条信息是否可信、一个 Skill 是否真的有用,这件事的工作量一分没少——甚至因为产出变多了,需要判断的总量反而更大。SkillsBench 那个“自造 Skill 比不装还差”的结果,说的就是这件事:没有人把关的产出,连“中性”都算不上,它是负资产。
所以别再问“AI 建知识库靠不靠谱”这种笼统的问题。该问的是:这一页有没有人认领、多久会被重新核实、它的 Skill 有没有做过有/无对照测试。答得上这三句,靠谱不靠谱就不用猜了。
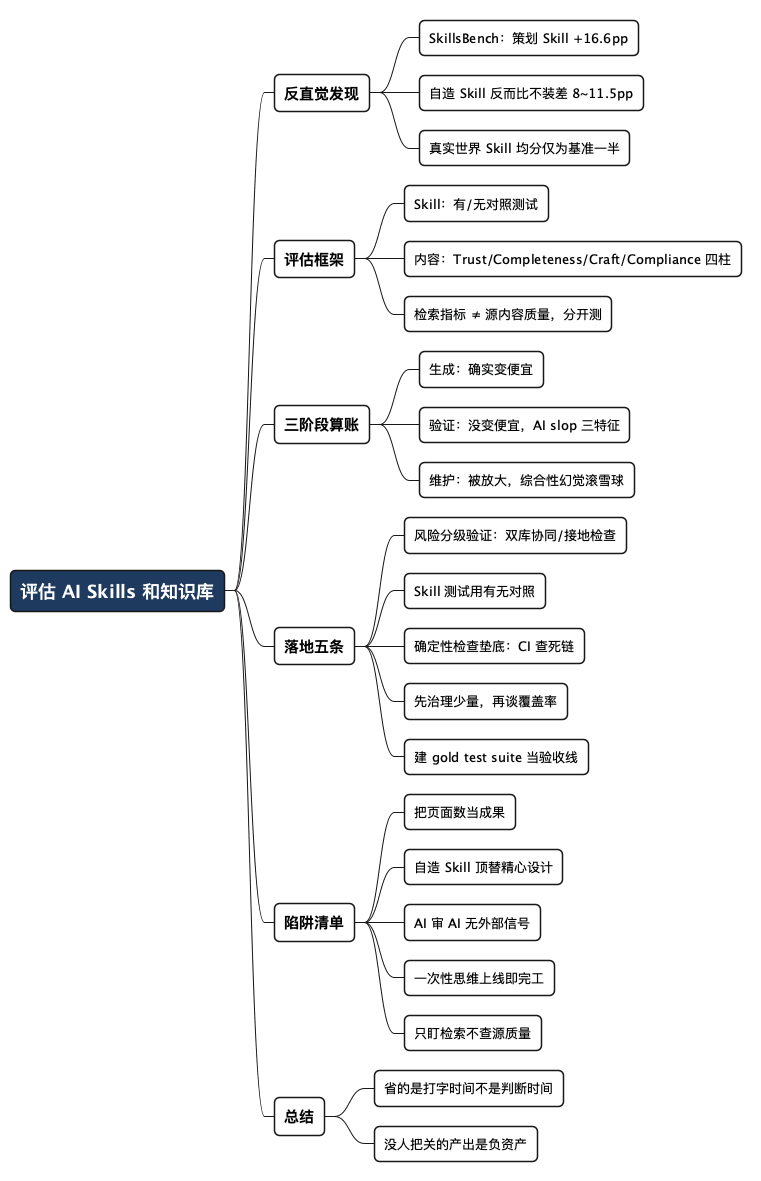
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* 评估 AI Skills 和知识库
** 反直觉发现
*** SkillsBench:策划 Skill +16.6pp
*** 自造 Skill 反而比不装差 8~11.5pp
*** 真实世界 Skill 均分仅为基准一半
** 评估框架
*** Skill:有/无对照测试
*** 内容:Trust/Completeness/Craft/Compliance 四柱
*** 检索指标 ≠ 源内容质量,分开测
** 三阶段算账
*** 生成:确实变便宜
*** 验证:没变便宜,AI slop 三特征
*** 维护:被放大,综合性幻觉滚雪球
** 落地五条
*** 风险分级验证:双库协同/接地检查
*** Skill 测试用有无对照
*** 确定性检查垫底:CI 查死链
*** 先治理少量,再谈覆盖率
*** 建 gold test suite 当验收线
** 陷阱清单
*** 把页面数当成果
*** 自造 Skill 顶替精心设计
*** AI 审 AI 无外部信号
*** 一次性思维上线即完工
*** 只盯检索不查源质量
** 总结
*** 省的是打字时间不是判断时间
*** 没人把关的产出是负资产
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。