从填鸭到因材施教:Andrew Ng 的新赌注,和我们这代学习者的改变
Posted on in Journal
| Abstract | 从填鸭到因材施教:Andrew Ng 的新赌注,和我们这代学习者的改变 |
|---|---|
| Authors | Walter Fan |
| Category | learning note |
| Version | v1.0 |
| Updated | 2026-11-13 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- Andrew Ng 又创业了:这次赌的不是更强的模型,是"怎么学"
- 我女儿的处境:题做得不错,一碰到没有标准答案的事就露怯
- LearnVector 想赌的三个转变:从一对多到一对一,这事两千年前就有人算过账
- 一对一不是万能药:换个投喂的对象,学生还是可能继续伸手等答案
- AI 该干的三件事,不该干的三件事:想点子、找资料、干脏活;理解、判断、内化不能外包
- 具体怎么做:Anthropic 一项研究把用法拆成六种,分数从 24% 到 86%,给她和给自己各三条
- 总结:因材施教的门槛能打下来,但那道坎得自己迈
Andrew Ng 又创业了。
这名字不用多介绍:Coursera 联合创始人、Google Brain 创始人、DeepLearning.AI 创始人,斯坦福计算机系客座教授。过去十五年,他是把"在线教育"这件事从概念做成现实的那批人之一。这次他的新公司叫 LearnVector,拿到了 Coursera 一亿美元的战略投资,CEO Greg Hart 亲自站台。
一个把在线教育做成功的人,掉头回来说在线教育没做对,这事挺值得琢磨。他在官网上把话说得很直白:Coursera 和线上课程改变的是在哪学——把教室从物理空间搬到了互联网上;但怎么学,这十五年几乎没变——还是统一进度、统一内容、统一方式,教给每一个点进来的人。
这句话我读了两遍。因为它说中的事,正好是我这段时间一直在操心的一件事。
我女儿的处境
我女儿在读大学,这几年我看着她学习,心里一直悬着一块。
她做题没问题,考试成绩也拿得出手,这套应试的本事,她比我当年强。可一旦要她独立做一件没有标准答案的事——拼一个完整的小项目、做一个能拿出手的东西、面对一个题目本身就模糊的问题——她就开始不安,不知道从哪儿下手。更让我意外的是,AI 工具摆在那儿,她却不太会用:不是不会打开对话框,是不知道该拿它干什么、该问什么、该怎么追问。
这不是她一个人的毛病。她学的那套东西——刷题、考试、按标准答案打分——训练出来的本事是"答对题",不是"把事做成"。一个只练过打靶的人,第一次被要求自己判断目标在哪、要不要开枪,自然会愣住。
这就是 Andrew Ng 那句话落到一个具体人身上的样子:学校这套机器,效率很高,产出很稳定,但它教的是怎么在一个已经设好边界的题目里拿分,不是怎么在没有边界的世界里把一件事做成。AI 时代偏偏反过来——边界模糊、答案不唯一、工具随时在变的那类问题,才是真正值钱的那类问题。
LearnVector 想赌的三个转变
LearnVector 官网上把它想做的事拆成三条:
| 转变 | 过去 | 想要的样子 |
|---|---|---|
| 规模 vs 个性 | 一对多(One-to-many),一个老师教一屋子人 | 一对一(One-to-one),每个人一条自己的路径 |
| 动力 | 苦差事(Labor),为了考试和学分硬扛 | 乐趣(Love),学得进去、学得想继续 |
| 频率 | 偶尔(Occasional),考前突击 | 日常(Daily),变成一个习惯 |
这三条里,最站得住脚的是第一条,因为它背后有一笔早就算过的账。
1984 年,芝加哥大学教育心理学家 Benjamin Bloom 发表过一篇论文,后来被称为"2 西格玛问题":接受一对一辅导的学生,平均成绩比传统课堂的学生高出两个标准差——相当于把一个中等生的水平,拉到传统课堂前 2% 的位置。他把这个结果叫作一个"问题",是因为一对一辅导这件事,大多数社会负担不起。给每个孩子配一个专属老师,这笔钱没有哪个国家出得起。
这就是因材施教为什么几千年来只属于少数人——请得起家教的人家。LearnVector 赌的,就是 AI 能把这笔账的门槛打下来:不是每个孩子配一个真人老师,是每个人配一个足够懂他、随叫随到、不嫌他问题幼稚的助教。
这里要多说一句公道话:Bloom 的"两个标准差"这些年争议不小。后续的荟萃分析发现,大多数真实的辅导项目效果远没有这么夸张,平均在零点三到零点四个标准差左右,远不到两个标准差。这个数字被过度引用了四十年,不该再被当成板上钉钉的结论去用。但争议归争议,"一对一辅导比大班教学更有效"这个方向上,几十年的研究从来没有反过来过——分歧只在效果有多大,不在有没有效果。
一对一不是万能药
但这里有个容易被 LearnVector 的三个转变掩盖掉的问题:一对一辅导为什么有效?
不是因为换了个更贴心的投喂对象。是因为好的辅导者会逼学生自己想、自己试、自己卡壳、然后在卡壳的地方给一把推力——这个"卡壳"的环节,恰恰是学习真正发生的地方。如果一对一变成了"伸手问、秒拿答案",那和在教室里抄同桌的作业,没有本质区别,只是抄的对象从人变成了机器。
这事我在另一篇文章里拆得比较细:《思维导图必须自己画:把被 AI 借走的脑子要回来》讲的是认知科学这些年攒下的证据——越信任 AI、批判性思维投入得越少;而真正留得住的理解,必须是自己生成、自己复述过的。LearnVector 说它会"耐心陪着你,直到你真正掌握一项技能,而不只是上完一门课",这句话说得很好,但效果好不好,最终不取决于 AI 有多耐心,取决于学习者在被推一把之后,愿不愿意自己往前走那一步。
换句话说:因材施教解决的是"谁来教、怎么因材",没解决"学的人到底有没有真学"。这道坎,换了多贴心的老师,都得学生自己迈。
AI 该干的三件事,不该干的三件事
这道坎落到我们这些已经工作、还得继续学的人身上,更具体一点。我自己这些年摸出一条边界:
| AI 该干的 | 具体样子 |
|---|---|
| 想点子 | 头脑风暴、给反例、追问"这个假设站得住吗" |
| 找资料 | 检索、摘要、把一堆零散信息先整理出个轮廓 |
| 干脏活 | 非核心竞争力的杂事、重复性的脚本和文档、一次性跑完就扔的分析 |
这三样,交出去一点不心疼,省下来的力气该拿去干正事。但有三样,不管 AI 多好用,都不能交:理解、判断、内化。理解是把一件事在脑子里拆开、拼回去的过程;判断是在没有标准答案的地方,自己担责任做选择;内化是把别人(或 AI)给的东西,嚼碎了变成自己能随时调出来、能迁移到新场景的本事。这三样,AI 给不了你,只能你自己长。
我现在对自己的要求很简单:AI 是副驾,我是主驾。副驾可以帮我看路况、提醒我前面有个弯、递张地图过来,但方向盘握在谁手里、什么时候踩刹车、走哪条路,是我的事,不是副驾的事。真出了事,担责任的是开车的人,不是坐在旁边的人。这条边界我在《逆流而上:AI 时代程序员的深度学习法》里拆过具体做法——带着问题出发、先裸想再开 AI、用变式练习逼自己讲清楚——这里不重复,想看方法的可以翻那一篇。
这条边界,同样是我现在最想讲给我女儿听的一句话:AI 可以帮她把杂事干完、把资料找齐、把思路想开,但没法替她把一件事真正弄懂。这道坎,当年是我自己一步步迈过去的,现在轮到她了——区别只是,她手里多了一个副驾,而我当年没有。
具体怎么做:一张给她,一张给我自己
道理讲完了,落到动作上。先说一组数据,再分两张清单——一张给我女儿,一张给我自己。
2026 年初,Anthropic 的研究人员 Judy Hanwen Shen 和 Alex Tamkin 做了一项随机对照实验:找 52 名有至少一年 Python 经验的工程师,学一个他们都没用过的新库,一组可以用 AI 助手,一组只能查文档、搜索引擎。两组花的时间差不多,但随后的知识测验,用 AI 那组平均分比不用的低了 17%。
更有意思的是后续拆解。他们把参与者用 AI 的方式归成六种具体模式,按测验分数从低到高排开:
| 用法 | 测验得分 | 本质 |
|---|---|---|
| 直接照抄 AI 给的答案 | 39% | 整段外包,没自己走一遍 |
| 先自己做,扛不住了全交给 AI | 35% | 半路弃守 |
| 报错 → 贴给 AI → 改 → 再报错 | 24% | 死循环,没搞懂错误本身 |
| 只问概念,不要代码 | 65% | 先把框架搭进脑子里 |
| 要代码的同时要求解释 | 68% | 边拿边消化 |
| 先让 AI 生成,再追问"为什么这样写" | 86% | 生成之后自己嚼一遍 |
六种用法,分数从 24% 到 86%,差的从来不是"用没用 AI",是用完之后,自己有没有再走一遍。这张表给了我一个实在的参照:下面这两份清单,都是在想办法把人往表格下半部分推。
给她,三条具体的:
- 先自己答一遍,再让 AI 挑错。 不管是作业还是一篇论文,先写下自己的答案或理解,哪怕写得很糙,再拿去跟 AI 对一遍,看漏了哪、错在哪。这个顺序不能倒——AI 先给答案,自己再回头补,大概率落在表格下半部分,收获有限。
- 动手前先问自己三句话。 这门课、这次作业允许用 AI 吗?它是在帮我学,还是在替我学?它说的这些,我能不能信?想不清楚这三句,先别开对话框。
- 逼 AI 给两个对立的答案,自己判断。 碰到没有唯一答案的问题,别只问"正确答案是什么",让 AI 给两种相反的方案或结论,自己比较证据、解释为什么会不一样,最后落一句自己的判断。这比抄一个标准答案费劲,但"比较和取舍"这道题,正是学校以前没教、AI 时代真正要补的那一课。
给我自己,三条具体的:
- 脑子三明治:先想、再看 AI、再想一遍。 拿到 AI 的输出当草稿看,不当答案看——读完它改了什么、为什么这么改,再决定收不收。一行代码解释不清楚,就不提交,这行账算在自己头上,不算在 AI 头上。
- 先搭骨架,再提需求。 让 AI 写代码之前,自己先把数据模型、接口边界、要处理的异常情况想一遍、画出来。边界画得越清楚,AI 吐出来的东西越规整;边界没想清楚就甩过去,出来的多半是一堆能跑但经不起推敲的代码。
- 定期关掉 AI,从零实现一遍。 哪怕是个用过很多次的小功能,隔一阵子不借 AI 自己敲一遍。敲得费劲、卡壳,那种卡壳感就是信号——这块肌肉这段时间没怎么用,正好是该补的地方,不是该绕开的地方。
两份清单说到底是同一件事换了个场景:AI 能帮她把答案核对清楚,能帮我把草稿打出来,但"自己有没有再走一遍",谁也替不了谁。
总结:因材施教的门槛能打下来,那道坎得自己迈
LearnVector 想做的事是真问题:几千年来,因材施教一直是少数人的特权,AI 第一次有机会把这个门槛打下来,让更多人用得起"贴身教练"。这件事值得期待。
但别被这件事带偏了方向——以为门槛打下来,学习本身也会变容易。不会。真正难的那部分,从来不是"有没有人(或 AI)贴身教你",是你愿不愿意在被推一把之后,自己往前迈那一步。学校那套填鸭式的东西,错不在它逼人学,错在它从头到尾没给人留下"自己迈那一步"的机会——标准答案都摆好了,迈不迈那一步,根本没人检查。
AI 把答案递到我们每个人面前的速度,比任何一位家教都快。接下来愿不愿意多想五分钟、自己迈那一步,才是这道题真正的分水岭。
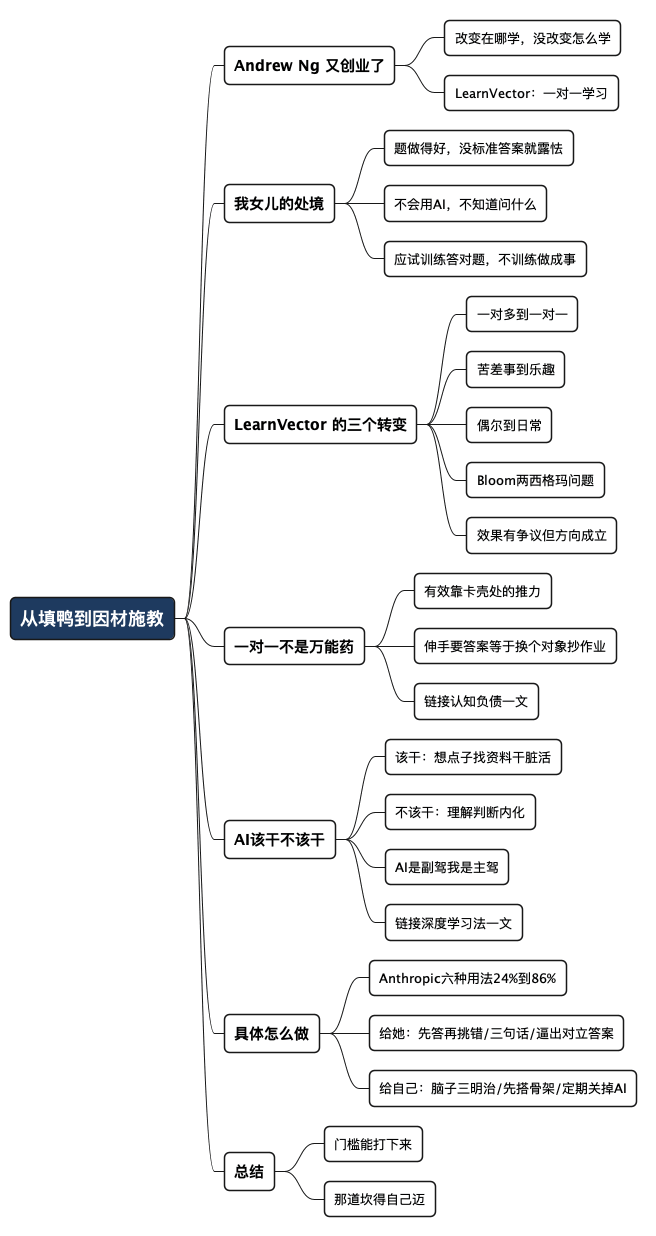
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* 从填鸭到因材施教
** Andrew Ng 又创业了
*** 改变在哪学,没改变怎么学
*** LearnVector:一对一学习
** 我女儿的处境
*** 题做得好,没标准答案就露怯
*** 不会用AI,不知道问什么
*** 应试训练答对题,不训练做成事
** LearnVector 的三个转变
*** 一对多到一对一
*** 苦差事到乐趣
*** 偶尔到日常
*** Bloom两西格玛问题
*** 效果有争议但方向成立
** 一对一不是万能药
*** 有效靠卡壳处的推力
*** 伸手要答案等于换个对象抄作业
*** 链接认知负债一文
** AI该干不该干
*** 该干:想点子找资料干脏活
*** 不该干:理解判断内化
*** AI是副驾我是主驾
*** 链接深度学习法一文
** 具体怎么做
*** Anthropic六种用法24%到86%
*** 给她:先答再挑错/三句话/逼出对立答案
*** 给自己:脑子三明治/先搭骨架/定期关掉AI
** 总结
*** 门槛能打下来
*** 那道坎得自己迈
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。