Agent Skills 落地指南:把“怎么干这活”写进文件夹
Posted on in Tech
| Abstract | Agent Skills 落地指南:把“怎么干这活”写进文件夹 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-11-10 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 上篇的续集:上下文工程是原则,Agent Skills 是拿它落地的东西
- 一个技能就是一个文件夹:三级渐进式披露怎么逐级打开
- 聪明归模型,确定性归代码:技能里的脚本是工具,不是文档
- 造技能是评估驱动的:四条官方开发法则,外加安全审计
- 落地:拿我的博客仓库当标本:一个真实技能的解剖
- 总结:让 AI 学会你的干法,而不是让它猜
上篇拆完 Anthropic 的 《Effective context engineering for AI agents》,结论压在三个字上:渐进式披露——别把整座图书馆搬进上下文,给 Agent 指路牌,用到哪块再取哪块。
理论是立住了,可很多人的下个问题是:那我到底怎么做?这篇就是官方给的答案。半个月后(2025 年 10 月 16 日),Anthropic 又发了篇文章,题目直译是《用 Agent Skills 给 Agent 装配真实世界的能力》。他们把“渐进式披露”这条原则,做成了一个人人能写的文件格式——技能(Skill)就是一个文件夹。
打个比方:以前你想让 AI 按你们团队的规矩干活,得在每次对话里把规矩念一遍,或者指望它自己悟。技能把这套行为写成一份“新员工入职手册”——AI 知道自己什么时候该翻这本手册、哪一章、看几页,而不是把整本手册背下来。早在今年 1 月我就写过一篇 《Agent Skills:给 AI 助手装上“技能包”》 介绍这个格式的来历和各家用它的状况,这篇不再重复那部分,直接往深里拆官方这篇文章,并把重点放在日常怎么落地——最后用这个博客仓库里一个真实在用的技能当解剖标本。
一个技能就是一个文件夹
官方定义很朴素:技能就是一组装着指令、脚本和资源的文件夹,AI 能发现它们、按需加载它们,用来把特定任务干得更好。 结构上就是一个目录,里面至少躺着一个 SKILL.md(技能清单文件),文件开头是 YAML 格式的元数据区(frontmatter),至少得有 name(名字)和 description(描述)。
它最精妙的设计叫三级渐进式披露:
| 级别 | 装什么 | 什么时候进上下文 |
|---|---|---|
| 第一级 | SKILL.md 开头的 name + description |
启动时,所有已装技能的这两行全部预载进系统提示词 |
| 第二级 | SKILL.md 正文 |
Agent 觉得任务有关时才整篇读入 |
| 第三级及以后 | 附属文件:模板、参考文档、专项脚本 | 只有用到那一小块才翻开 |
理解这个分层,就理解了技能的全部秘密。第一级是“目录”:Agent 靠 name 和 description 决定“这活跟我有关吗,要不要翻这本手册”——所以这两行是你整个技能的广告位,写不好,后面写得再好也大概率不被触发。第二级是“正文”:决定要用了,才把整篇 SKILL.md 读进上下文。第三级是“附录”:技能一大,就把内容拆到单独文件里,从正文里引用。官方用 PDF 技能举例:Claude 本来就会读 PDF,但不会“填表单”这种操作,于是技能作者把 SKILL.md 正文做得精简,填表细则单独放进一个 forms.md 文件,只有真在填表时才会被读进上下文。
用官方那句原话:渐进式披露(progressive disclosure)是让技能可扩展、可伸缩的核心设计原则。 它像一本好手册的目录→章节→附录三级结构;也因为 Agent 有文件系统、能按需读取,一个技能里能打包的上下文量,实际上没有上限——装得再多,也不是一次性搬进窗口。
聪明归模型,确定性归代码
技能里还能装代码——不是当文档,是当工具让 AI 直接跑。
为什么要这么干?大模型强在语言和推理,弱在“精确执行”。官方给的例子很实在:给一列数排序,让模型用生成 Token 的方式排,又贵又容易错;直接跑一段现成的排序脚本,又快又准。很多场景要的就是这种确定性(同样的输入,同样的输出),这是代码的看家本领,不该交给模型临场发挥。
PDF 技能就是这么做的:它带一个写好的 Python 脚本,专门抽取 PDF 里的表单域。Claude 用到时直接跑脚本——不用把脚本内容、也不用把 PDF 文件读进上下文,跑完拿结果就行。因为代码是确定性的,这一步永远可复现(这个技能的细节我 5 月拆过一篇:从 PDF Skill 学到什么)。
这也是对上篇“工具要省 Token”的呼应:技能里的代码,就是省 Token 又保准头的确定性工具。 顺便说,代码本身也是文档——官方提醒作者要写清楚,某一处到底是“该让 Claude 直接跑”,还是“该读进上下文当参考”,别让 AI 猜。
造技能是评估驱动的,不是写文档
官方给了四条开发法则,每一条都在反一个常见的错误习惯。大多数人的第一反应是把技能当“把我知道的全写下来”,官方说反了——技能是“让 AI 反复摔跤的地方长出来的”。
-
从评估开始,别从写作开始。 先在代表性任务上真实跑一跑,观察 AI 在哪几步挣扎、缺什么上下文,再针对这些缺口增量地补技能。不是闭门造一份十全大补的说明书。
-
面向规模去拆。
SKILL.md一臃肿就拆文件、拆路径。互相排斥、很少同时用到的上下文,路径分开本身就能降 Token。代码能当工具也能当文档,想清楚再写。 -
站在 Claude 的视角。 在真实场景里盯着它用你的技能,注意有没有走冤枉路、对某个上下文是不是过度依赖。尤其盯
name和description——触发与否,全看这两行判断。 -
跟 Claude 一起迭代。 干活时让 Claude 把“这次成功的做法”和“这次踩的坑”沉淀进技能里;用技能跑偏了,让它自己复盘错在哪。这样收集到的是 AI 真正需要的上下文,而不是你提前猜的。
再加一条官方单拎出来的红线:安全。 技能=指令+代码,等于给 AI 开了新权限,恶意的技能能引入漏洞、把数据外泄出去、指使 AI 干幺蛾子。只装可信来源;装了来路不明的,先通读里面绑的每个文件——重点看代码依赖、捆绑的图片和脚本,以及有没有指使 AI 去连不可信的外部网络源。一句话:把陌生技能当陌生代码一样 review 再放行。
落地:拿我的博客仓库当标本
说了半天,落地长什么样?直接看这个博客仓库里真实在用的 walter-blog-write 技能,它把我“怎么写博客”这件事的三级披露解剖得明明白白:
.claude/skills/walter-blog-write/
├── SKILL.md                                  # 第二级:正文
├── templates/journal_template.md             # 第三级:发文的骨架模板
└── references/popular-science-and-diagrams.md # 第三级:配图/科普写作才翻的附录
- 第一级(预载):文件开头只有 name、version、author,和一段很长的 description——description 写清“什么时候用它:写博客、改稿、去 AI 味、把笔记转成文章;什么时候不用它”。这就是它的触发条件。
- 第二级(正文):
SKILL.md正文是一整部写作规范——Contract(这篇能做什么、不能做什么)、四问(动笔前先问事实/观点/语言/读者)、六戒四看、写作五遍法、收尾写法……这些是每篇都必然要用的,所以留在正文。 - 第三级(附录):发文骨架模板、科普配图规范这些,只有真到了排版或配图那一步才会被读。正文里一句“复制
templates/journal_template.md打底”就把它们引用出去了,从不整篇预载。
看出门道了吗:正文只放“每次都绕不开”的东西,其余全部下沉到附录按需取。 这篇和上一篇就是沿着这套流程出来的——元数据让它在我打开这个仓库时被“想起”,正文在动笔时整篇读入,模板和配图规范一直留在硬盘里,直到真要用。
同样的结构我另一份 .agents/skills/、.cursor/skills/ 也各备了一份——官方在 2025 年 12 月已经把它做成开放标准(agentskills.io),理想要做到“写一次,Claude Code、Cursor、Codex 各处通用”,跨工具、跨人、跨团队流转。
落到日常开发,给你一条可照着走的清单:
- 收集,而不是设计。 干活时留意那些你反复向 AI 强调/纠正的地方——团队规范、提交信息格式、接口文档模板、常用命令——那就是技能的雏形,先记进一张草稿纸。
- 元数据当门面。
name具体、可检索;description写清“什么时候用、什么时候不用”,别写人话都看不懂的形容词堆。 - 正文只放必看的。 一旦
SKILL.md超过一两屏,就把分支拆成模板/参考/脚本文件,正文里引用文件名。 - 能确定性就代码化。 解析、批量改、格式转换这类活,写成脚本让 AI 直接跑,别让它在上下文里演算。
- 定期复盘自己的技能。 每季度翻一遍:哪个技能触发率低、哪两个该合并、哪个该删;代码会腐烂,技能也会。
总结:让 AI 学会你的干法,而不是让它猜
把 Anthropic 两篇串起来就一句话:上下文工程给原则(渐进式披露、用到再取),Agent Skills 给交付物(一个文件夹、三级披露、代码进脚本)。 它们是一套东西的两层。上篇读完你懂了“为什么”,这篇读完你该动手装一个“自己的”。
技能的本质,是把过程性知识——你这行真正怎么把活干成——编码成 AI 能发现、能按需加载的资产。它不要求你写得十全十美,要求你从“AI 反复摔跤的地方”开始,边用边收。
动手的最小切口:今天干的那件重复活里,挑一步你每次都要纠正 AI 的,把它写成一个 SKILL.md。写完你会发现,最受益的不只是 AI——把“想当然”讲清楚,逼出的是一套你自己以前也没意识到的、关于怎么干这活的说明书。
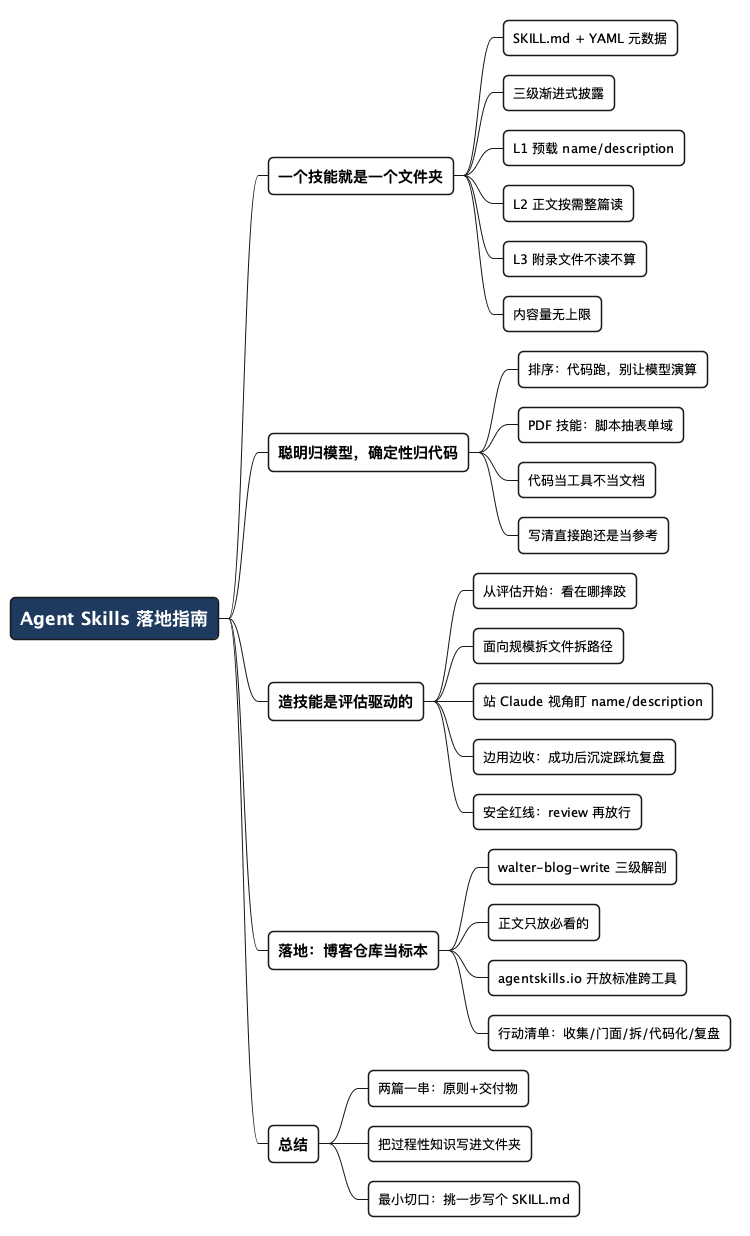
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* Agent Skills 落地指南
** 一个技能就是一个文件夹
*** SKILL.md + YAML 元数据
*** 三级渐进式披露
*** L1 预载 name/description
*** L2 正文按需整篇读
*** L3 附录文件不读不算
*** 内容量无上限
** 聪明归模型,确定性归代码
*** 排序:代码跑,别让模型演算
*** PDF 技能:脚本抽表单域
*** 代码当工具不当文档
*** 写清直接跑还是当参考
** 造技能是评估驱动的
*** 从评估开始:看在哪摔跤
*** 面向规模拆文件拆路径
*** 站 Claude 视角盯 name/description
*** 边用边收:成功后沉淀踩坑复盘
*** 安全红线:review 再放行
** 落地:博客仓库当标本
*** walter-blog-write 三级解剖
*** 正文只放必看的
*** agentskills.io 开放标准跨工具
*** 行动清单:收集/门面/拆/代码化/复盘
** 总结
*** 两篇一串:原则+交付物
*** 把过程性知识写进文件夹
*** 最小切口:挑一步写个 SKILL.md
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。