AI 生成的知识库,到底怎么保证质量
Posted on in AI
| Abstract | AI 生成的知识库,到底怎么保证质量 |
|---|---|
| Authors | Walter Fan |
| Category | AI |
| Version | v1.0 |
| Updated | 2026-10-26 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 三个纠缠在一起的问题:质量、正确性、及时性其实是三件事,别混着治
- 我试过的几条路,为什么都不彻底:自动生成、让 AI 自己审、加规则
- 业界的四层防线:接地约束、自动评估、新鲜度监控、留一道人工闸门
- 分层架构 + 来源链接:把知识库分成源头层/提炼层/服务层,每条内容带 provenance
- "生成 + 校验"流水线:固定 schema、自动核对、按风险分级人审
- 度量体系:内容质量、新鲜度、检索问答、使用价值四组指标
- 能用的工具:RAGAS、TruLens、DeepEval、SelfCheckGPT、docs-as-code 那套
- 值得读的几篇论文:RAG 原始论文、谁来验证验证者、裁判也会偏心
- 一句话落地的检查清单
我写过几个 skill,干的是同一件事:把一个代码仓库、一堆散落的文档,自动嚼成一个结构化的知识库,让 AI agent 能查、能答、能当新人入职材料。思路不复杂——扫源码、读 README、抽概念、生成架构图和术语表,最后吐出一份看起来很专业的文档站。
跑起来那一刻确实挺爽。但用了几轮我就发现一个尴尬的事实:它生成的东西,我不敢不看就用。 有的地方把一个已经删掉的模块讲得头头是道,有的地方把两个同名类混成一个,有的术语解释昨天还对、今天代码一改就过时了。我陆陆续续加了自动校验、让模型自查、写死规则,每一招都能挡掉一部分错,但没有哪一招能让我彻底撒手。最后还是得我自己坐下来,一页一页地审。
这篇想说清楚的就是这件事:AI 生成的知识库,没有能让你彻底不用人审的银弹。人审是必要环节。但你可以把"人审"从"逐字通读"压缩到"只看机器挑出来的那几处"——这中间的差距,可能是十倍工作量。 下面讲我踩过的坑、业界怎么做、有哪些现成工具、哪几篇论文真能帮上忙。读者默认是做 AI / 知识库 / RAG 的同行,术语我就直接用了。
先把三个问题拆开:质量、正确性、及时性不是一回事
很多人(包括早期的我)把"保证知识库质量"当成一个问题来治,其实它是三个,治法完全不同:
- 正确性(correctness):这条陈述本身是不是真的?比如"X 服务用 Redis 做分布式锁"——代码里到底是不是。这是跟事实较劲。
- 质量(quality):就算每句话都对,它好不好用?结构清不清楚、有没有答非所问、该有的信息缺不缺。这是跟"有用"较劲。
- 及时性(freshness):它昨天对,今天代码改了,它还对吗?这是跟时间较劲,而且最阴险——因为一篇文档可以写得很好、当时也很对,却已经悄悄过期了。
混着治的后果是:你花大力气做了个漂亮的自动校验,专抓胡说八道,结果真正坑你的是一篇措辞严谨、三个月前完全正确的架构说明。页面的"最后修改时间"骗不了人,但它也救不了你——页龄不等于正确性,一篇昨天改过的页可能已经和今天的发布冲突,一篇一年没动的页可能依然准确。
记住这个拆分,后面所有工具和方法才能对号入座。
我试过的几条路,和它们各自的天花板
把我这几年在 skill 里试过的招数摆出来,顺便说清楚每条路撞在哪:
| 做法 | 能挡住什么 | 天花板在哪 |
|---|---|---|
| 纯自动生成,一次成稿 | 快,覆盖面广,从零到有 | 幻觉和过时无人把关,生成即定稿,错了也不知道 |
| 让 AI 自己复查自己 | 能抓一部分明显的自相矛盾 | 裁判和选手是同一个模型,它看不出自己的盲区;越自信的系统性错误越查不出来 |
| 写死规则 / 正则校验 | 格式、死链、已删符号这类确定性问题,极其可靠 | 只能查"能写成规则的",语义对不对、讲清楚没有,规则无能为力 |
| 跑一遍打分(自动 eval) | 给出可量化的质量信号,能做回归 | 分数是另一个模型打的,分数本身也要被校准,不然是自欺欺人 |
这张表其实就是我的教训史。最想说的是中间那条——让 AI 自己审自己,是最诱人也最靠不住的一条。它看着优雅:一个 agent 生成,另一个 agent 挑错,闭环,不用人。但只要这两个 agent 是同源的,它们的盲区高度重合:生成时想当然的地方,复查时照样想当然。更麻烦的是自一致性(self-consistency)这类方法的一个硬伤——如果模型"稳定地"犯同一个错,多采样几次投票,它会非常自信地把那个错答案投出来。一致不等于正确。
所以这几条路不是"哪条对哪条错",而是每条只覆盖一层,得叠起来用,最后还得留一道人工闸门。下面这套四层防线,就是把它们排进正确的位置。
业界的四层防线:接地、评估、监控、人审
把散落在各家博客、文档和论文里的做法归一归,其实收敛成四层,从最该先做的往后排:
第一层:接地约束(grounding)——不让它张口就来
这是性价比最高的一层,也是最该先做的一层。核心就一句话:知识库里的每条事实性陈述,都必须能指回一个来源,指不出来就标"未经证实"或者干脆弃权(cite-or-abstain)。
落到知识库上:每个概念、每张架构图、每条"X 用了 Y"的断言,都带上来源锚点——哪个文件、哪次提交、哪份 spec。这样做有两个好处:一是逼着生成环节不敢凭空编,二是把"正确性校验"这个难题,降维成了"这句话被它引的来源支持吗"这个可自动检查的小问题。这里有个关键区分值得记牢——
- 事实性(factuality):这句话和真实世界符不符。很难,得有外部真相源。
- 忠实性 / 接地性(faithfulness / groundedness):这句话被你给它的来源支持吗。相对好办,因为来源就在手边。
对大多数系统,忠实性是更可操作的目标:你未必有办法验证"世界上是不是这样",但你总能验证"它说的和它引的那段代码/文档是不是一回事"。把目标从"验证世界"换成"验证来源",一大半自动化就有抓手了。
第二层:自动评估(evaluation)——把质量变成可回归的指标
接地解决"别瞎编",评估解决"到底好不好、这次改动有没有变差"。业界现在的共识是把知识库 / RAG 系统当软件产品来治,给它配一套 eval harness,像跑单元测试一样跑质量。RAG 场景下最常被引用的是所谓 RAG 三元组(RAG Triad),它刚好把检索和生成分开诊断:
- 忠实性(faithfulness):答案有没有超出检索到的上下文乱讲——抓幻觉。
- 答案相关性(answer relevancy):答案有没有正面回应问题——抓答非所问。
- 上下文相关性 / 精度(context relevancy / precision):检索回来的内容有没有用——抓检索噪音。
好处是:哪层分低,你立刻知道是检索坏了还是生成坏了,而不是对着一个总分干瞪眼。建一个"黄金集(golden set)"——哪怕只有十几二十条你亲手标过对错的问答——每次知识库重建就跑一遍,分数掉了就拦住,这就是最朴素的回归测试。
但这层有个必须说破的前提:打分的是另一个模型,那个分数本身也得先被校准。 不然你只是用一个你不信的模型,去给另一个你不信的模型打分,自欺欺人。怎么校准,留到论文那节讲。
第三层:新鲜度监控(freshness)——跟时间赛跑
这是最难、也最被低估的一层,专治"写得好、曾经对、已过期"。业界把它拆成两种触发方式,得都上:
- 事件驱动(event-driven):代码一变就触发。最常见的是 PR / commit 钩子——某次提交动了某个文件、某个接口、某个服务名,就自动把引用到它的知识库章节标成"待复审"。这叫"在变更发生的那一刻抓漂移",而不是三个月后审计时才发现。更进一步,可以用 embedding 比对文档章节和对应代码模块,语义距离拉大了就报警。
- 时间驱动(time-based / 新鲜度 SLA):给每个章节记一个"最后复审时间 + 复审周期",到点没人碰就进复审队列。周期按变化速度和风险定——认证、部署、计费这类高风险内容每个发布周期查一次,稳定的概念性内容一年查一次就够。
这里有个很解气的结构性洞见,来自实践者:与其一遍遍重写,不如先大规模删。 大多数过时文档根本不该修,应该删掉或明确标成"历史快照(描述某日期的系统状态)"。把能删的删掉,剩下一小撮真正重要的,才有精力用机器盯住。删除是最高效的新鲜度策略——没有的东西不会过期。
还有一招治本:能从源头生成的,就别手写。 API 文档从 OpenAPI 生,基础设施文档从 terraform-docs 生——生成的文档是构建产物,它不会漂移,只会构建失败,而失败 CI 会告诉你。手写的部分(那些"为什么"和坑)就放进仓库、和代码同一个 commit 改,漂移至少发生在 review 里,有人看得见。
第四层:人工闸门(human-in-the-loop)——压到最低,但不取消
前三层能把错误、低质、过时挑出来并排好序,但最后"这条改动能不能发布"的判断,目前仍然得人来做。这不是技术不够先进,而是有个更根本的原因,下一节用一篇论文讲清楚。
人审的正确姿势不是逐字通读,而是:只看机器标红的那几处、按风险排序先看高危的、看一眼就能批或退。 理想状态是"修复比忽略更省事"——通知直接 @ 到写这段代码的人,带上代码变更、受影响的具体章节、一份 AI 草拟的改法,一键批准或退回。把人从"大海捞针"变成"确认机器捞出来的针对不对",这就是我说的十倍差距。
把知识库分三层,每条内容都带"来源链接"
四层防线是"怎么治",但要治得动,底层数据结构得先对。我的教训是:别让 AI 生成的内容和它的来源脱钩。 一旦脱钩,你连"这句话是从哪抽出来的"都查不到,上面所有校验都成了空中楼阁。
实践下来,分三层最清爽:
- 源头层(source of truth):代码、工单、会议纪要、聊天记录、设计文档。这是唯一的真相源,永远不碰它、只读它。
- 提炼层:AI 从源头抽出来的结构化条目——概念页、FAQ、故障模式、决策记录(ADR)。这一层是 AI 的主战场,也是最容易出错、最需要校验的一层。
- 服务层:RAG 索引和问答入口,面向使用者。
关键的一条纪律:每条 AI 生成的内容,都要留一条指回源头层的来源链接(provenance),并写明生成时间和模型版本。 这条链接有三个用处:一是出了问题能追溯"这句话从哪来";二是源头一变,就能顺着链接反向定位"哪些条目该重算"(这正是新鲜度那层的抓手);三是换了模型版本,你能知道哪些内容是旧模型的产物、值得重审。
还有一条血的教训单独说:只从源头层抽取,绝不从提炼层二次生成。 用 AI 生成的内容再喂给 AI 生成新内容,错误会被逐代放大——这就是"自我强化"陷阱。提炼层可以互相引用,但生成的输入必须是源头层。
"生成 + 校验"是一条流水线,不是一次调用
很多人把"用 AI 建知识库"理解成"写个好 prompt 让它生成"。不对。生成只是流水线的第一道工序,后面必须接校验。 三道工序:
1. 抽取——强制固定 schema。 别让 AI 自由发挥成一篇散文。要求它按固定字段输出,比如:
| 字段 | 作用 |
|---|---|
| 标题 / 摘要 | 检索和列表展示 |
| 适用范围、适用版本、适用环境 | 防止"在 A 环境对、在 B 环境错"被当成通用结论 |
| 负责人(owner) | 谁签字、谁背锅 |
| 来源(provenance) | 指回源头层,可追溯 |
| 有效期(TTL) | 到期自动触发复核 |
字段齐不齐,本身就是一个可自动检查的质量信号(结构合规率)。
2. 自动校验——两件事。
- 引用核对:每个论断都必须能在它引的来源里找到对应原文。可以用 NLI 模型逐句判"被支持 / 被矛盾 / 无关",也可以用 LLM-as-judge。这就是上面说的接地层。
- 去重与冲突检测:用 embedding 找相似条目,再让 LLM 判断两条是"互相矛盾"还是"互为补充"。矛盾的必须人来裁决——知识库里两页打架,比没有这一页还糟。
3. 人工审核——按风险分级。 不是所有内容都值得人逐字看。安全、计费、对外接口相关的,必须人确认;低风险 FAQ,抽样审就行。把人的注意力花在高危内容上,这是"压低人审成本"最直接的一刀。
这条流水线和前面的 Owner 制是一套的:AI 负责起草,人负责签字。 最该避免的状态是"一堆没人负责的 AI 内容"躺在库里——没有 owner 的页,既不会被复核,也没人对它的错误负责。
度量体系:没有指标,你根本不知道知识库在变好还是变烂
前面讲的都是"怎么做",但你怎么知道做得有没有用?得有指标。我把它分成四组,每组只讲最该先盯的几个,别一上来就铺二十个指标——那和没有指标一样。
A. 内容质量(静态,抽样测) - 有据率 / 忠实度(groundedness):有来源支撑的论断占全部论断的比例。这是最该先盯的一个,直接对应"别瞎编"。(RAGAS 的 faithfulness 就是测这个。) - 引用有效率:引用链接可访问、且确实支撑对应论断的比例。断链和"引了但其实没支撑"是两种常见病。 - 冲突率 / 重复率:被判为互相矛盾或高度重复的条目占比。 - 结构合规率:schema 必填字段(owner、版本、来源、有效期)的填充率。
B. 新鲜度与维护 - 过期内容占比:超过 TTL、或来源已变但条目还没复核的比例。这是"及时性"那层的核心度量。 - 变更传播延迟:从源头变更到知识库更新的时长(中位数 / P90)。衡量你的事件驱动跑得快不快。 - AI 草稿采纳率:AI 修订被直接接受 / 改后接受 / 拒绝的比例——反过来反映生成质量。 - 人工审核耗时:每条内容的平均审核时间,直接衡量 AI 到底帮你省了多少人力。
C. 检索与问答(RAG 层,在黄金集上测) - Recall@k / Hit Rate:正确来源页出现在前 k 个结果里的比例。这是检索好不好的第一指标。 - Context Precision / Recall:检索片段里相关内容的占比,以及答案所需信息的覆盖度(RAGAS)。 - 幻觉率:答案里无来源支撑的论断比例。 - 拒答准确性:库里确实没有答案时,能不能老实说"不知道"。这条最容易被忽略,却最影响信任。
D. 使用与业务价值 - 缺口率:零结果查询、低置信度查询的占比——它直接告诉你该补写什么。 - 自助解决率:问答后没再转人工 / 提工单的比例。 - 内容活跃度:长期零访问的"僵尸页"占比,可作归档候选。 - 业务指标:工单量、MTTR(排查时引用 Runbook 后的恢复时长)、新人上手时间。
一句话:先把"使用反馈"也接进来做闭环。 问答时的点踩、追问、转人工、搜不到结果,全汇总成一张缺口清单,反过来驱动补写——这比你拍脑袋想"该写点什么"靠谱得多。
能上手的工具清单
把上面四层对应到现成工具,省得你从零造轮子。下面每个都说清楚它是什么、拿来干哪层的活、从哪里获取。除特别说明外,都是 Python 生态、pip install 即可,开源免费。
RAGAS —— RAG 评估的事实标准
- 是什么:专门评 RAG 系统的开源库,直接给你 faithfulness(忠实度)、answer relevancy(答案相关性)、context precision / recall(上下文精度 / 召回)这几个指标。不少指标是 reference-free 的——不用标准答案,能直接跑生产流量。
- 干哪层:第二层(自动评估)。上面度量体系里一多半指标它都能算。
- 怎么获取:
pip install ragas;源码 https://github.com/explodinggradients/ragas;文档 https://docs.ragas.io。
TruLens —— 挂在问答链路上做在线评估
- 是什么:把 RAG 三元组(faithfulness、answer relevance、context relevance)做成可观测的"反馈函数",用装饰器给每一步打分,还能解释打分理由。它是 OpenTelemetry-native 的,trace 能导到任意 OTLP 后端,既能在请求落地时实时评,也能对数据集事后批量评。
- 干哪层:第二层,偏在线/生产监控那一侧,和 RAGAS 的离线回归互补。
- 怎么获取:
pip install trulens(接不同模型要配 provider 包,如trulens-providers-openai);源码 https://github.com/truera/trulens(MIT 许可);文档 https://www.trulens.org。
DeepEval —— 把 eval 做成 pytest,塞进 CI
- 是什么:像 Pytest 一样写 LLM 评估,
deepeval test run一跑,指标掉到阈值以下就让 CI 变红。还有"把生产里失败的 trace 攒成下一轮 golden"的闭环设计。想把 eval 当成质量门卡在流水线上,这个最顺手。 - 干哪层:第二层,偏 CI/CD 门禁那一侧。
- 怎么获取:
pip install -U deepeval(Python 3.9+);源码 https://github.com/confident-ai/deepeval(Apache-2.0)。本体开源免费,云端平台 Confident AI 是可选项,不接也能用。
SelfCheckGPT —— 零资源幻觉探测器
- 是什么:黑盒幻觉检测——同一个问题采样 N 次,看答案稳不稳,发散就标可疑。不要模型内部、不要标准答案,拿来当"这条断言稳不稳"的探针很合适。原理同族的还有 semantic entropy(语义熵)。
- 干哪层:第一层(接地/忠实性检查)。代价是要多采样几次,有成本和延迟,适合抽查高风险断言而不是全量跑。
- 怎么获取:
pip install selfcheckgpt;源码 https://github.com/potsawee/selfcheckgpt;论文 arXiv:2303.08896。
NLI 模型 —— 逐句核对"被支持 / 被矛盾 / 无关"
- 是什么:不是某个产品,而是一类做自然语言推理(NLI)的模型。把答案拆成一条条断言,逐条和来源文本比对,判定 entailment(被支持)/ contradiction(被矛盾)/ neutral(无关)。这是把忠实性检查做细、做得可解释的标准手法。
- 干哪层:第一层。相比 LLM-as-judge,NLI 模型更小更快、判定更稳定,适合大批量跑。
- 怎么获取:到 Hugging Face 上取现成模型(搜
nli、fact verification、MiniCheck这类),用transformers加载即可;无需从零训练。
docs-as-code —— 新鲜度和质量的工程底座
- 是什么:不是一个库,而是一套做法——文档进 Git、走 MR/PR、在 CI 里跑构建和校验(死链检查、文档内代码片段实跑、OpenAPI 名称比对)。再配上"能从源头生成的就别手写"(API 文档从 OpenAPI 生、基础设施文档从 terraform-docs 生)。
- 干哪层:第三层(新鲜度)的工程底座。
- 怎么获取:没有统一安装包,按需拼现成件——静态站点用 Sphinx / MkDocs / Docusaurus,死链检查用
lychee或linkchecker,接口文档生成用openapi-generator、terraform-docs。核心是流程,不是某个工具。
一个务实的组合:接地用 NLI 核对 + 抽查用 SelfCheckGPT,评估离线用 RAGAS + DeepEval 进 CI、在线用 TruLens 挂链路,新鲜度靠 docs-as-code + PR 钩子,最后留一道人工闸门。 不用全上,按你最疼的那层先补一件。
几篇真能帮上忙的论文
不是凑数的参考文献,是直接改变我想法的几篇:
《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》(Lewis et al., 2020, arXiv:2005.11401) —— RAG 的开山论文。想明白"为什么要把知识放外部检索、而不是塞进模型参数里",从这篇开始。知识库天然就是 RAG 的语料层,这篇讲清了为什么"外挂可更新的知识"比"重训模型"更适合知识会变的场景。
《Who Validates the Validators?》(EvalGen, UIST 2024) —— 这篇回答了最扎心的问题:既然用 LLM 当裁判来评 LLM,那谁来验证裁判?它的做法是让人先给一小批输出打"好 / 坏",用这些人工标注去挑选并校准那些自动评估函数(prompt 或代码断言),让裁判和人的口味对齐。但它真正值钱的发现是一个叫 criteria drift(标准漂移) 的现象:人得有标准才能打分,但打着打着分,标准自己会变——很多评判标准根本不是能提前定死的,而是看着模型的实际输出才逐渐长出来的。这句话基本宣判了"一次性定好规则然后全自动"这条路走不通,也从根上解释了为什么人审去不掉:标准本身是活的。
《A Survey on LLM-as-a-Judge》(arXiv:2411.15594) —— 想系统了解"用模型当裁判"怎么做得可靠,这篇综述是入口,讲怎么提升一致性、怎么缓解偏见、怎么评估裁判本身的可靠性。
一组关于裁判偏见的实证研究 —— 如果你打算用 LLM 当自动评估的裁判,先看看它有多不靠谱:
- 位置偏见:裁判会偏爱排在前面的答案,这不是随机噪声,是系统性的(《Judging the Judges》,arXiv:2406.07791)。
- 多种偏见叠加:冗长偏见(爱打分给更长的)、权威偏见(被看起来更可信的措辞带跑)、自我增强偏见(偏爱自己的输出)等等,人和模型都有(《Justice or Prejudice?》CALM 框架,arXiv:2410.02736;《Humans or LLMs as the Judge?》arXiv:2402.10669)。
- 单次评判太吵:有研究做了上万次重复评判,发现成对偏好平均有 13.6% 的翻转率,高方差的问题要重复 11 次以上投票才能稳定下来——单次 LLM 评判对高风险场景往往噪声太大,该用多次采样投票 + 位置随机化 + 显式报告不确定性(arXiv:2606.13685)。
SelfCheckGPT(EMNLP 2023, arXiv:2303.08896) —— 零资源幻觉检测的代表作,黑盒、不要标准答案,采样比一致性。要在知识库里加一个"这条稳不稳"的探测器,从这篇开始。
这几篇连起来读,会得到一个清醒的结论:你想用自动化取代人审,但自动化的核心部件——那个裁判——本身就带偏见、会漂移、单次不稳。 所以人退不出去,但人可以退到"校准裁判 + 抽查高危"这个位置上。
四个容易踩的坑,先打个预防针
方法和指标都讲完了,但有几个反直觉的陷阱,不提醒一下大概率会栽:
- LLM-as-judge 自带偏见:它偏爱长答案,也偏爱和自己风格相近的文本。所以裁判不能完全替代人工抽检——上线前最好用人工标注校准它,让裁判和人的一致性(比如 Cohen's κ)到 0.7 以上再当门禁用。
- 反馈信号很稀疏:点踩率低不代表内容好,很可能只是没人用。看满意度一定要和访问量一起看,否则"僵尸页"会伪装成"零差评的好页"。
- 自我强化会放大错误:前面说过一遍,这里再钉一次——AI 用 AI 生成的内容再生成,错误逐代放大。只从源头层抽取,不从派生内容二次生成,这条没有例外。
- 没有通用达标线:别去网上找"有据率该是多少才算好"。业内没有统一阈值,更靠谱的是拿你自己的基线和趋势说话——这个月比上个月好没好,比"是不是到了 90%"有意义得多。
总结:没有银弹,但人审能从"通读"压到"抽查"
回到最初那个困扰我的问题:AI 生成的知识库怎么根本保证质量、正确性、及时性?老实说,根本没有银弹,人审这道闸门目前去不掉。 《Who Validates the Validators?》已经讲明白了原因——评判标准本身是活的,会随着你看到的输出而变,不可能一次定死然后全自动。
但"去不掉人审"不等于"认命逐字通读"。真正能做的,是用四层防线把人审的负担压到最低。按优先级落地,别想着一口吃成胖子:
- 先建两样地基:黄金问答集(200–500 条真实问题 + 标准答案 + 来源页) 和 来源追溯(provenance)。没有这两样,后面所有指标都无从算起——先做这个,别的都往后放。
- 只盯 4 个核心指标:有据率、过期内容占比、Recall@5、自助解决率。每周出一次看板,先让趋势跑起来,别一上来铺二十个指标。
- 分层 + 固定 schema:源头/提炼/服务三层,提炼层按固定字段(owner、版本、来源、有效期)生成;只从源头抽,不从派生内容二次生成。
- 生成接校验:抽取后自动核对引用 + 去重查冲突,再按风险分级人审(安全/计费/对外接口必审,低风险抽样)。
- 新鲜度双触发:源头变更(代码合并、配置变更、事故复盘、发布)自动定位受影响条目、生成修订草稿;加 TTL 兜底。能删的大胆删,能从源头生成的别手写。
- 校准你的裁判:用 LLM 做自动评估前,先用人工标注对齐它(κ ≥ 0.7),警惕位置 / 冗长 / 自我增强偏见,高风险场景多采样投票。
- 人审只看红点:按风险排序,只审机器标出来的那几处,一键批或退。
把这几条落下去,你不会得到一个"永远正确、永不过时、完全不用人看"的知识库——那东西不存在。你会得到一个错误被提前挑出来、过时被及时报警、人只需要确认机器判断的知识库。从"每次重建都要通读一遍"到"只看机器标红的十几处",这中间省下的,就是你把自动化做对的全部回报。
把人审从"大海捞针"改成"确认机器捞出来的针"——这是目前能拿到的最好结果。
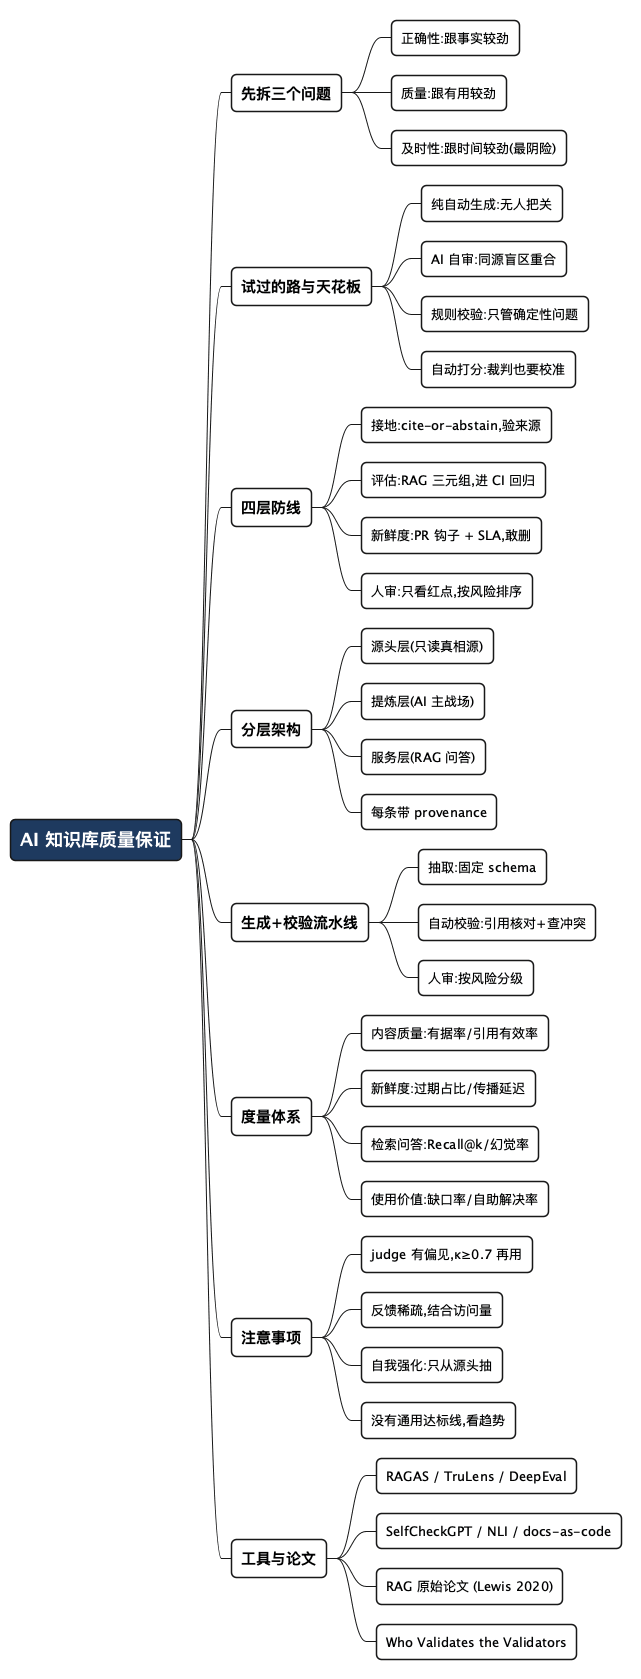
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* AI 知识库质量保证
** 先拆三个问题
*** 正确性:跟事实较劲
*** 质量:跟有用较劲
*** 及时性:跟时间较劲(最阴险)
** 试过的路与天花板
*** 纯自动生成:无人把关
*** AI 自审:同源盲区重合
*** 规则校验:只管确定性问题
*** 自动打分:裁判也要校准
** 四层防线
*** 接地:cite-or-abstain,验来源
*** 评估:RAG 三元组,进 CI 回归
*** 新鲜度:PR 钩子 + SLA,敢删
*** 人审:只看红点,按风险排序
** 分层架构
*** 源头层(只读真相源)
*** 提炼层(AI 主战场)
*** 服务层(RAG 问答)
*** 每条带 provenance
** 生成+校验流水线
*** 抽取:固定 schema
*** 自动校验:引用核对+查冲突
*** 人审:按风险分级
** 度量体系
*** 内容质量:有据率/引用有效率
*** 新鲜度:过期占比/传播延迟
*** 检索问答:Recall@k/幻觉率
*** 使用价值:缺口率/自助解决率
** 注意事项
*** judge 有偏见,κ≥0.7 再用
*** 反馈稀疏,结合访问量
*** 自我强化:只从源头抽
*** 没有通用达标线,看趋势
** 工具与论文
*** RAGAS / TruLens / DeepEval
*** SelfCheckGPT / NLI / docs-as-code
*** RAG 原始论文 (Lewis 2020)
*** Who Validates the Validators
@endmindmap
参考链接
- RAGAS 评测框架:https://docs.ragas.io
- TruLens(RAG Triad):https://www.trulens.org
- DeepEval:https://github.com/confident-ai/deepeval
- Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, 2020:https://arxiv.org/abs/2005.11401
- Zheng et al., Judging LLM-as-a-Judge, 2023:https://arxiv.org/abs/2306.05685
- Shankar et al., Who Validates the Validators? (EvalGen), 2024:https://arxiv.org/abs/2404.12272
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。