Keepalived 与浮动 IP:机器可以换,服务地址不能换
Posted on in Tech
| Abstract | Keepalived 与浮动 IP:机器可以换,服务地址不能换 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-11-12 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 一句话:机器可以换,服务地址不能换——Keepalived + 浮动 IP 就是给“服务地址”搬家
- 浮动 IP:不是独立网卡,是贴在当前主服务器网卡上的一张“值班牌”
- 原理:VRRP 广播互相报活,优先级高的当 MASTER 持有 VIP;收不到广告约 3 秒,BACKUP 接管并广播 gratuitous ARP
- 用法:一份照着改的
/etc/keepalived/keepalived.conf,健康检查走track_script - 最佳实践:无状态服务最合适;nopreempt 防老主回抢抖动;weight 要扣到低于对端;定期拔线演练
- 坑:VIP 不是独立 IP、VRRP 走 IP 协议 112 不是端口、忘发 ARP 切了也白切、不同步连接状态、双主脑裂(没有 quorum)、云上 SDN 不买账
- 分工:Keepalived 管“地址归谁”,HAProxy/Nginx 管“流量给谁”
半夜被值班电话叫起来,最让人心里发毛的一句话是“客户那边连不上了”。再一问,多半是前面那台机器挂了。挂机器不可怕,可怕的是客户端手里那个地址,只有这一台机器认。改内网地址?改 DNS?等解析生效?这一宿就别想睡了。
高可用的入门问题,其实就一句:机器可以换,服务地址不能换。 一台机器挂了,能不能让另一台在几秒钟之内顶上,继续用同一个地址接客?Linux 生态里最常用的答案,是 Keepalived + 浮动 IP。这篇就把这件事讲清楚:浮动 IP 是什么、Keepalived 怎么在故障时把地址交接过去、一份能照着改的配置、几个反复验证过的实践,以及六个真能让半夜值班的人惊出一身冷汗的坑。
先钉死一个容易跑偏的点:
Keepalived 只回答一个问题:此刻哪个服务器拥有服务 IP。 它不转发流量、不均衡负载、不同步会话——那些是别的工具的事。把这句话记牢,后面大半的坑你就能看穿了。
术语都会在第一处出现时解释;装配置那节可以整节跳过,不影响理解后面的坑。
一、浮动 IP:一张会搬家的值班牌
先说清“浮动 IP”(Floating IP,也叫 VIP,Virtual IP,虚拟 IP)到底是什么。它不是一个独立的网卡,也不是一台“跑在别处的服务器”——它是一个可以贴在任意一台服务器网卡上的 IP 地址。谁拥有它,谁就对外以这个地址提供服务。
举个具体的例子。两台 Linux 服务器:
| 机器 | 物理 IP | 角色 |
|---|---|---|
| 服务器 A | 192.168.1.101 | 主(MASTER) |
| 服务器 B | 192.168.1.102 | 备(BACKUP) |
| 浮动 IP | 192.168.1.100 | 对外服务地址 |
客户端永远只连 192.168.1.100。这个地址贴在 A 上,就在 A 上服务;A 挂了,它被“撕下来”、贴到 B 上。客户端不感知——最多断那么一下,重新连还是同一个地址。
把它想成两个门卫和一张值班牌:
两台服务器是两个门卫,浮动 IP 是那张“值班牌”。白班挂在 A 胸前,夜班换到 B 胸前。客人不看门卫是谁,只要他胸前还挂着牌子,就走上前去找他。
flowchart LR
  C[客户端] -->|"连 192.168.1.100"| V[VIP 192.168.1.100]
  V -->|"此刻贴在这块网卡上"| A[门卫 A · MASTER<br/>192.168.1.101]
  A -->|"VRRP 广播:我还活着"| B[门卫 B · BACKUP<br/>192.168.1.102]
这是正常状态的画面:A 持有值班牌,B 空着手待命,只监听 A 的广播。等 A 一倒,画面变成:
flowchart LR
  C[客户端] -->|"连 192.168.1.100"| V[VIP 192.168.1.100]
  V -->|"此刻贴在这块网卡上"| B[门卫 B · MASTER<br/>192.168.1.102]
  A[门卫 A · 宕机] -. "不参与" .-> V
对客户端来说,地址没变,变的只是牌子背后那个人。这就是浮动 IP 的全部意义:用“牌子会搬家”来换“地址永不变”。
二、Keepalived 与 VRRP:怎么决定谁挂值班牌
Keepalived 是一个 Linux 守护进程,专门管两件事:监控服务器健康,管理浮动 IP 的归属。它底下靠的关键东西叫 VRRP(Virtual Router Redundancy Protocol,虚拟路由冗余协议)——名字带着“路由”,因为这本来是给路由器做冗余的协议(RFC 3768 / RFC 5798),后来被借来给服务器用。
三个概念先立住,后面全靠它们说话:
- MASTER:当前拥有浮动 IP 的那台服务器。
- BACKUP:候补,随时准备顶替的那台。
- VRRP:两台机器互相发“我还活着”的广播,协调谁挂值班牌。
正常时的流程:
- A、B 都启动 Keepalived,都往同一个组播地址(multicast,一对多地广播)发 VRRP 通告(默认每秒一条,
advert_int 1说的就是这事)。 - 两边都收到对方通告,优先级高的当 MASTER——A 的优先级 150 大于 B 的 100,A 胜出。
- A 把浮动 IP 配到自己网卡上;B 保持 BACKUP,只监听、不持有。
A 挂了之后:
- B 连续几个周期收不到 A 的通告(默认 3 个通告周期,也就是 3 秒左右的窗口)。
- B 判定 MASTER 失联,把自己提升为 MASTER。
- B 把
192.168.1.100配到自己网卡上。 - B 广播一条 gratuitous ARP(无偿 ARP),通知全网:从此刻起,
192.168.1.100对应的 MAC 是我 B 的了。
最后一步是整场交接里最容易被忽视、却最要命的一环。交换机、路由器、还有别的服务器,都靠各自的 ARP 缓存记着“这个 IP 对应哪个 MAC”。IP 一搬家,如果缓存还指着老地址,流量会继续发给已经挂了的那台。所以新的持有者必须主动广播“我在这”,让所有缓存立刻刷新——而不是等缓存自然过期(那要几分钟,够客户把投诉电话打爆了)。
sequenceDiagram
    participant A as 服务器 A(MASTER)
    participant B as 服务器 B(BACKUP)
    participant N as 网络(ARP 缓存/交换机)
    participant C as 客户端

    loop 正常期
      A->>N: VRRP 通告:VRID 51,优先级 150,每秒一条
      N->>B: 转发通告,B 知道 A 活着
    end

    Note over A: A 宕机 / 断网
    Note right of B: 连续约 3 秒收不到通告
    B->>B: 提升为 MASTER,挂上 192.168.1.100
    B->>N: 广播 gratuitous ARP:100 的 MAC = B 的 MAC
    Note over N: 全网 ARP 缓存刷新
    B->>C: 以 192.168.1.100 继续对外服务
编进同一组的两台服务器要写同一个 VRID(Virtual Router ID,虚拟路由 ID,上例是 51)——它把两台的 Keepalived 绑成同一个组。同一个二层网络里 VRID 别重复用,重复了会互相打架。
三、装起来:一份照着改就行的配置
不想看代码的可以直接跳到第四节,结论在那边。套路其实很短,两台 Ubuntu 上都装上、配置一处地方、对比两处差异就行。
安装(两台都执行):
sudo apt update
sudo apt install keepalived
sudo systemctl enable --now keepalived
配置写在 /etc/keepalived/keepalived.conf。延续上面的 IP 假设:
- 服务器 A:
192.168.1.101 - 服务器 B:
192.168.1.102 - 浮动 IP:
192.168.1.100 - 网卡:
ens160 - VRID:
51
服务器 A:
global_defs {
    router_id SERVER_A
}

vrrp_instance VI_1 {
    state MASTER
    interface ens160
    virtual_router_id 51
    priority 150
    advert_int 1

    authentication {
        auth_type PASS
        auth_pass mysecret
    }

    virtual_ipaddress {
        192.168.1.100/24
    }
}
服务器 B:
global_defs {
    router_id SERVER_B
}

vrrp_instance VI_1 {
    state BACKUP
    interface ens160
    virtual_router_id 51
    priority 100
    advert_int 1

    authentication {
        auth_type PASS
        auth_pass mysecret
    }

    virtual_ipaddress {
        192.168.1.100/24
    }
}
两份配置只有三处不同,其他必须一致:
| 配置 | 服务器 A | 服务器 B |
|---|---|---|
state |
MASTER | BACKUP |
priority |
150 | 100 |
router_id |
SERVER_A | SERVER_B |
| VIP / VRID / 认证串 | 相同 | 相同 |
启动后验证,ip addr show ens160:
- A 上应该看到两个地址:
192.168.1.101/24和192.168.1.100/24(它持有值班牌)。 - B 上只有
192.168.1.102/24。
A 一挂,192.168.1.100 就出现在 B 上——这就是“浮”起来的意思。注意 auth_pass mysecret 这段:它只是防止两台服务器手滑配错群的明文口令,防不了抓包,别把它当安全机制使,见下文的坑。
四、健康检查:服务器活着,不等于服务活着
新手最常见的翻车点在这里。Keepalived 的默认健康检测是“收 VRRP 通告”,它只能告诉你另一台机器还在不在,根本不知道你的服务还正不正常。典型场景:Nginx 崩了,进程退出,但 Linux 还活得好好的,Keepalived 照样每秒报“我还活着”,VIP 纹丝不动——客户全挂在 502 上。
解法是 track_script,让 Keepalived 按周期跑一段你自己的健康检查脚本,把结果算进优先级里:
vrrp_script chk_nginx {
    script "/usr/bin/killall -0 nginx"
    interval 2
    weight -60
}

vrrp_instance VI_1 {
    state MASTER
    interface ens160
    virtual_router_id 51
    priority 150
    advert_int 1

    virtual_ipaddress {
        192.168.1.100/24
    }

    track_script {
        chk_nginx
    }
}
killall -0 nginx 不是去杀进程,是给进程发一个 0 号信号,单纯问一句“Nginx 进程还在吗”。检查失败时,Keepalived 从优先级里扣掉 weight 的绝对值。
这里藏着一个非常现实的坑,网上教程一抄一个错:
weight必须大到让你的优先级低于对端,否则“检查失败也不切”。
假设 A 是 150、B 是 100。如果 weight -30,A 的 Nginx 挂掉后,A 的有效优先级是 150 − 30 = 120,仍然大于 B 的 100——于是 B 永远不接管,VIP 还挂在病着的 A 身上。这也是为什么上面样例用 weight -60(150 − 60 = 90 < 100)。做故障演练时发现“明明写了 track_script 却不切”,先回来算这笔减法。
另一个务实建议:killall -0 只查“进程在不在”,卡死的进程也算活着。生产上更靠谱的是真正探服务本身——curl 一下健康检查 URL,或直连服务端口。进程在、端口通,才能算“真活着”。
五、最佳实践:让这套东西在半夜也不掉链子
配置能跑只是起点。下面几条是从一次次事故里磨出来的:
-
无状态的入口最合适。 Keepalived + VIP 是给“不记会话”的东西用的:Nginx 反向代理、HAProxy、静态入口、SIP 网关入口。要是有状态——数据库、登录会话、正在进行的媒体流——先解决状态怎么同步,再谈切不切。它只搬地址,不搬记忆。
-
两边配置保持一致,只有两处不同。 VIP、VRID、认证串、通告间隔,A 和 B 必须一模一样;允许不同的只有
router_id和priority。哪边手滑改了一个字段,两边就再也认不出对方是一个组。 -
用
nopreempt,别让老主恢复时抢镜。 默认(preempt)下,优先级高的只要回来,会立刻把 VIP 抢回去。老主只是抖了一下网络、不是真死,恢复后立刻回抢,两边来回切,比挂一台还糟。更稳的写法是两边都设state BACKUP+nopreempt,靠优先级和启动先后决定谁主:谁先启动谁当主,回落后不抢,流量不抖。 -
auth PASS只是防手滑,不是安全。 它是明文口令,能被抓包读到,也就够挡住“我把它配到别的机器上了”这类低级错误。别指望它防入侵。 -
故障演练是配置的一部分。 拔掉一台的网线、停掉它的服务,亲眼确认 VIP 在几秒内切过去;再恢复,确认它不会抢回(尤其配了 nopreempt 之后,回抢行为要专门测)。演练中发现的问题,好过半夜客户帮你发现。
-
监控盯“状态”,别只盯“进程”。 值班面板上除了 Keepalived 进程,还要有它当前的角色:现在是 MASTER 还是 BACKUP、最近一次切换时间、健康检查脚本是否在跑。
ip a里能看到 VIP,只说明“现在还没出事”,不说明“高可用是好的”。
六、六个坑:每一个都能让值班电话响起来
原理和配置都懂了,最容易踩的还是这六个。它们不是冷知识,是生产环境里被反复踩出来的。
1. 浮动 IP 不是独立 IP。
它是“贴”在当前 MASTER 网卡上的一个地址,由 Keepalived 替你 ip addr add 上去。它不单独存在,跟着 MASTER 走。别自己手贱去加这个地址,也别指望它离了 Keepalived 还有意义——MASTER 没了,它等于没了。
2. VRRP 走 IP 协议 112,不是端口 112。
VRRP 既不是 TCP 也不是 UDP,它直接用 IP 协议号 112,而且默认发往组播地址 224.0.0.18。配防火墙、安全组时,要放行的是 protocol 112 和那个组播地址,不是某个端口。这是个很隐蔽的坑:你在安全组里按“端口 112”去加规则,配了个寂寞,两边互相看不到通告,各自都把自己提成 MASTER——直接就是下面的第 5 条。云安全组默认不会放行协议 112,所以云上这个坑几乎是必踩的。
3. 忘了 gratuitous ARP,切了也白切。
新主接管后,靠 ARP 广播把“IP 的 MAC 换成我”这件事告诉全网。正常的交换机/路由器收到就刷新缓存。但如果网络里有人做了静态 ARP 绑定、或者 SDN 平台用别的方式管二三层映射,Keepalived 广播再多也刷不动别人的缓存——流量还是往旧主那里灌。真遇到这种网络,别指望自动接管,得先解决“地址和 MAC 的映射怎么动态更新”。
4. Keepalived 不同步任何应用状态。
它只搬 VIP,不搬连接。A 上正握着的 TCP 连接,A 一挂就断;B 接管的是“新地址”,不是“断点续传”。数据库、会话、正在进行的通话,全都不会跟着 IP 走。有状态的东西必须另配复制或共享机制(数据库主从、Redis 持久化、通话的话务复制之类)。这也是为什么第一节强调:无状态前端才是它最舒服的战场。
5. 脑裂:两台都以为自己是 MASTER。
这是最狠的一个,值得单独写。VRRP 不像 etcd 的 Raft 有多数派(quorum),双机主备天生没有“少数派必须退位”的协议保证——它俩之间只有“谁活着”的广播,没有“谁说了算”的仲裁。如果两台机器互相收不到通告,但各自都活着:A 心想“B 挂了,我还是 MASTER”,继续持有 VIP;B 等不到 A 的通告,也把自己提成 MASTER,同样持有 VIP。同一个网段出现两个持有同一地址的家伙,ARP 缓存来回抖,流量忽东忽西,比挂一台还惨——挂一台至少是明确的故障,脑裂是两边都以为自己活着、流量两头乱窜。
这里正好是两种高可用哲学的对照:etcd 靠多数派从协议上堵死脑裂(上一篇文章讲过);Keepalived 的双机主备没有多数派,脑裂只能靠网络和配置去防——让 VRRP 的路径绝对可靠、防火墙别拦 112、加
track_interface盯住网卡、把权重和 nopreempt 想清楚,再在前面挂一层外部健康监控兜底。 它防不住脑裂,只能尽量不让它发生、发生了尽快被外部发现。
6. 云环境不一定买账。
AWS、Azure 这类 SDN 环境,二层的地址映射由平台控制,你 ip addr add 一个 VIP 上去,流量多半不会按你想象的方式进来——要么平台不转发,要么得走 API 去搬“次要 IP”。所以公有云上的首选是托管的负载均衡器(AWS ELB/NLB、Azure SLB 这类)或者云厂商自己的 HA 方案;Keepalived + VIP 更常用在自建的裸机、VMware、内部机房这类你自己说了算的二层网络里。上云之前先想清楚,别把机房的方案原封不动搬到云上然后折腾一宿。
七、Keepalived vs HAProxy:一个管“地址归谁”,一个管“流量给谁”
这两个经常被放在一起,很多人搞混。一句话:它俩解决的不是一回事。
| 能力 | Keepalived | HAProxy |
|---|---|---|
| 主要职责 | 高可用(保证入口地址可用) | 负载均衡(把请求分给后端) |
| 浮动 IP | 有,核心功能 | 没有,本身不搞地址 |
| 健康检查 | 有(确认服务是否正常) | 有(确认后端是否正常) |
| 分发请求 | 不分发 | 专门分发 |
| 故障处理 | 决定 VIP 归谁 | 从后端列表里去掉坏节点 |
| 工作层次 | 网络层 / IP | TCP / HTTP |
两者的关系不是二选一,而是各管一段。常见组合是一对 HAProxy 做主备,Keepalived 负责让“谁的 VIP 生效”,HAProxy 负责把流量分到后端一堆真实服务器上:
flowchart LR
  C[客户端] -->|"连 192.168.1.100"| V[浮动 IP]
  V -->|"贴着当前 MASTER"| P[HAProxy 主]
  P -->|"轮询 / 最少连接"| S1[后端 1]
  P --> S2[后端 2]
  P --> S3[后端 3]
  P -. VRRP 心跳 .-> Q[HAProxy 备]
这里 Keepalived 只回答“VIP 此刻贴在那台 HAProxy 上”,HAProxy 只回答“这个请求分给哪个后端”。地址的稳定和流量的分摊,互不越界,各司其职。
总结:高可用不是多买一台机器,是把“谁值班”讲清楚
回到开头那句:机器可以换,服务地址不能换。Keepalived 就是把这句话变成机制的答案——浮动 IP 是那张值班牌,VRRP 是门卫之间确认“谁在值班”的暗号,Keepalived 是那个半夜也会记得换班的管理员。
三句话记住全篇的分工:
- Keepalived 决定哪个服务器拥有服务 IP(通过 VRRP 通告 + 优先级 + 健康检查)。
- 浮动 IP 提供永不改变的入口地址(靠接管后广播 gratuitous ARP 让全网换指向)。
- HAProxy / Nginx 负责把流量分发到后端(跟 IP 归属是两码事)。
动起手来,先问自己的服务是无状态还是有状态:无状态的入口(反代、网关、SIP 网关入口),Keepalived + VIP 是又快又省的正解——但记得把 weight 扣到低于对端、放行 IP 协议 112、配好 nopreempt、再拔一回网线演练;有状态的服务,先解决状态同步,别指望一张会搬家的值班牌替你保存记忆。
延伸阅读
- Red Hat 博客的《Using Keepalived for managing simple failover in clusters》(Anthony Critelli, 2020),一篇把 VRRP 报文结构、优先级选举、抢占(preemption)和 gratuitous ARP 讲得很扎实的入门:https://www.redhat.com/en/blog/ha-cluster-linux
- 脑裂的根因与“用多数派从协议上堵死”的做法,可以接着读上一篇《集群状态为什么该交给 etcd:用 Raft 从根上消除脑裂》
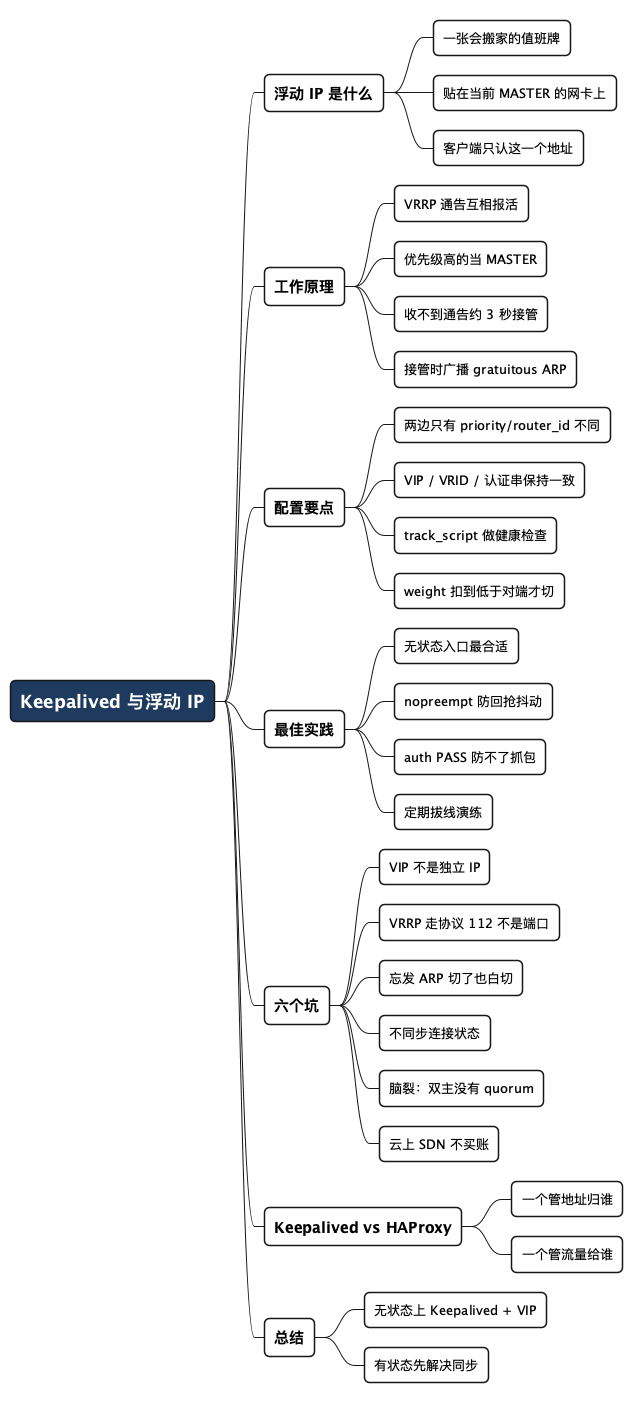
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* Keepalived 与浮动 IP
** 浮动 IP 是什么
*** 一张会搬家的值班牌
*** 贴在当前 MASTER 的网卡上
*** 客户端只认这一个地址
** 工作原理
*** VRRP 通告互相报活
*** 优先级高的当 MASTER
*** 收不到通告约 3 秒接管
*** 接管时广播 gratuitous ARP
** 配置要点
*** 两边只有 priority/router_id 不同
*** VIP / VRID / 认证串保持一致
*** track_script 做健康检查
*** weight 扣到低于对端才切
** 最佳实践
*** 无状态入口最合适
*** nopreempt 防回抢抖动
*** auth PASS 防不了抓包
*** 定期拔线演练
** 六个坑
*** VIP 不是独立 IP
*** VRRP 走协议 112 不是端口
*** 忘发 ARP 切了也白切
*** 不同步连接状态
*** 脑裂:双主没有 quorum
*** 云上 SDN 不买账
** Keepalived vs HAProxy
*** 一个管地址归谁
*** 一个管流量给谁
** 总结
*** 无状态上 Keepalived + VIP
*** 有状态先解决同步
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。