给 FreeSWITCH 集群配两个搭档:OpenSIPS 管信令,rtpengine 管媒体
Posted on 六 19 9月 2026 in Tech
| Abstract | 给 FreeSWITCH 集群配两个搭档:OpenSIPS 管信令,rtpengine 管媒体 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-09-19 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 一句话:FreeSWITCH 的精华是媒体引擎,包袱是没有集群、信令媒体业务同进程。OpenSIPS 补信令边缘,rtpengine 补媒体传输,正好各补在它最薄的地方。
- 精华在哪:小内核 + 可插拔模块、session/channel 双层抽象、强事件驱动 + ESL、信令媒体关注点分离、媒体作为一等公民。这几条今天从零设计也照抄。
- 包袱在哪:没有原生集群(活跃呼叫钉死在一个节点)、XML 配置地狱、单进程有状态、纯 C 的安全债。这些不是 bug,是二十年前的合理取舍在今天过期了。
- 为什么不硬堆 FreeSWITCH:一台 FreeSWITCH 撑死几百到一千路并发、一两百 CPS,且信令 CPS 和媒体带宽两种完全不同的负载被绑在一起扩,浪费。
- OpenSIPS 补信令:无状态 SIP 代理,单节点上万 CPS、十万级注册,
clusterer原生集群,还能通过freeswitch模块实时读 FS 的空闲 CPU 做容量感知调度。 - rtpengine 补媒体:内核态 RTP 转发(
nft_rtpengine),WebRTC/SRTP/ICE 一站终结,NAT 统一锚定,还能 media fork 一份给 AI 分析。 - 三件套分工:OpenSIPS 站信令边缘,rtpengine 站媒体代理,FreeSWITCH 退成一排纯媒体工人,业务逻辑外置成微服务。
- 怎么落地:先把 FS 精简成无状态媒体工人,再把 OpenSIPS/rtpengine 各自做 HA,最后把 ACD、AI 编排搬出去。
前面几篇把 FreeSWITCH 拆得差不多了:一次呼叫的 session 生命周期、架构为什么又快又脆、OpenSIPS 这个可编程的信令引擎是什么。这篇把它们接起来,回答一个做过 FreeSWITCH 的人迟早会撞上的问题:
一台 FreeSWITCH 跑得挺好,可我要接上万路、还要高可用,怎么办?
多数人第一反应是"再加几台 FreeSWITCH"。但 FreeSWITCH 没有原生集群,活跃呼叫钉死在建立它的那个节点上,节点一挂,上面所有在途呼叫全丢。你加机器,加的是一堆彼此不认识的孤岛。这条路能走,但它是三条路里最贵、最难运维的一条。
这篇想说清楚的是:FreeSWITCH 该守的是媒体引擎这块精华,该甩的是"什么都自己扛"的包袱。信令边缘交给 OpenSIPS,媒体传输交给 rtpengine,各补一刀,正好补在它最薄的两个地方。 这不是三个工具的堆叠,是一次关注点的重新切分。
先认清 FreeSWITCH 的精华:它凭什么值得留
要判断一个老系统还值不值得用,先看它有没有过不了时的核心能力。FreeSWITCH 有,而且不止一处。
媒体是一等公民。 这是它和纯 SIP proxy(Kamailio、OpenSIPS)最本质的区别。转码、会议混音、录音、放音、DTMF 检测——这些都是内核级能力,不是外挂。媒体处理链路是 SIP/SDP → mod_sofia → switch_core_media → codec layer → switch_rtp → network,每条呼叫腿独立协商编解码器,两端编码一致就直接转发 RTP、零 CPU,编码不同就自动落到"解码→内部 PCM→重编码"的转码通道。到了 AI 时代,ASR、TTS、实时质检都要深度访问媒体流,这个"媒体引擎"的定位比二十年前更值钱。
session/channel 双层抽象。 每条呼叫腿是一个独立的 session(运行时容器)加一个 channel(状态/数据对象),两条腿通过 bridge 关联。转接、会议、复杂路由,在这个模型上都很自然——比直接在 SIP dialog 层面拧要清楚得多。这套抽象的细节我在 session 那篇里拆过,这里不重复。
强事件驱动 + ESL 外部控制。 channel 的每一次创建、应答、挂断、DTMF 都产生类型化事件,mod_event_socket 通过 TCP 把事件流和命令接口暴露出去,这就是 ESL(Event Socket Library)。它是把业务逻辑从交换核心里解耦出去的关键——外部应用可以完整地控制一路呼叫,而不用改 FreeSWITCH 一行代码。后面三件套方案能成立,全靠这道口子。
还有小内核 + 可插拔模块、Sofia Profile 对信令的正交隔离、dialplan context 的路由隔离——这些放到今天从零设计一个软交换,照样是教科书答案。留 FreeSWITCH,留的就是这些。
再认清它的包袱:不是 bug,是过期的取舍
FreeSWITCH 2006 年从 Asterisk 社区分裂出来,很多设计在当年单核双核、SIP 硬话机为主的条件下是合理的工程取舍。放到 2026 年多核、云原生、WebRTC 为主流的环境里,它们成了拖后腿的包袱。这里挑对"扩容"影响最直接的几条。
| 包袱 | 当年为什么合理 | 今天为什么难受 |
|---|---|---|
| 没有原生集群 | 一台服务器跑一个软交换实例,够用 | 活跃呼叫钉死在单节点,节点故障即丢全部在途呼叫;注册、会议、队列状态全要手工外部化 |
| 信令+媒体+业务同进程 | 减少 IPC 延迟,单机部署简单 | 三种负载被绑死一起扩:信令按 CPS 扩、媒体按带宽扩、业务按并发扩,混在一起谁都浪费 |
| 单进程有状态 | 进程内函数调用延迟最低 | 和云原生"Pod 可抛弃"的理念根本冲突;模块升级要重启整个进程 |
| 纯 C 代码 | 实时媒体处理要极致性能 | 近二十年的大 C 代码库背着安全债,一个野指针拖垮全进程(2026 年 mod_verto 的预认证堆溢出 CVE 就是例子) |
这里面最要命的是第一条和第二条。
没有原生集群意味着你横向扩不出来——加机器只是加孤岛。信令媒体业务同进程意味着你连纵向的账都算不清:一路纯转发的呼叫(bypass media)几乎不吃 CPU,一路要转码的会议呼叫吃满一个核,它们却共享同一个进程的 admission control。你想按信令扩、按媒体扩、按业务扩,可它们焊死在一起,只能整体扩。
FreeSWITCH 又快又脆是同一个原因:没有进程边界。 媒体能零成本读到信令协商好的编解码和通道变量,这是快;一个模块的野指针能拖垮整个进程连同上面所有通话,这是脆。快和脆,一体两面。
想清楚这两条包袱,OpenSIPS 和 rtpengine 该补在哪,答案就自己浮出来了:把信令从进程里拆出去、把媒体传输从进程里拆出去,让 FreeSWITCH 退回它最擅长的那一小块——媒体处理。
OpenSIPS:补信令边缘那一刀
OpenSIPS 是高性能的模块化 SIP 代理/注册服务器,它和 FreeSWITCH 的能力曲线几乎是镜像的——FreeSWITCH 弱的信令扩展,正是它的强项。
- 信令吞吐差一个数量级。 单节点 OpenSIPS 轻松上万 CPS,十万级并发注册;而一台 FreeSWITCH 撑死一两百 CPS。原因很简单:OpenSIPS 是无状态/事务级的 SIP 处理,不碰媒体、不建 session,每个包进来查表、改头、转发就走。
- 原生集群。
clusterer模块做节点间状态交换和协调,分布式 usrloc 处理注册的 HA 和地理分布——这正是 FreeSWITCH 最缺的那块。 - 智能调度不靠拍脑袋。 这是我最想强调的一点:OpenSIPS 有个
freeswitch模块,能通过 ESL 实时读到每台 FreeSWITCH 的Idle-CPU、Max-Sessions、Session-Count。于是load_balancer可以基于实际负载调度,而不是静态的呼叫计数上限。哪台 FS 空闲就往哪台送,哪台快满了就绕开——这比"每台最多 500 路"这种死规则精细太多。
把 OpenSIPS 摆在最前面,它就成了信令边缘:对外终结 SIP/WSS、做注册鉴权、拓扑隐藏、限流防欺诈,对内把需要媒体的呼叫智能分发给后面一排 FreeSWITCH。FreeSWITCH 从此只处理"确实需要媒体"的呼叫,信令的洪峰全被 OpenSIPS 挡在门外。
OpenSIPS 的脚本模型、路由流程、模块结构,我在 OpenSIPS 入门那篇里讲过,这里只讲它在集群里的角色。
rtpengine:补媒体传输那一刀
信令拆出去了,媒体呢?这就是 rtpengine 的位置。它是 Sipwise 维护的高性能媒体代理/中继,专治 FreeSWITCH 在媒体传输层的三个痛点。
第一,内核态 RTP 转发。 rtpengine 提供 Linux 内核模块(nft_rtpengine),RTP 包在内核态直接转发,不用拷到用户态、不用上下文切换。对高 PPS(每秒包数)场景,这是单节点扛万级并发媒体流的关键。FreeSWITCH 的 switch_rtp 是用户态处理,纯做媒体中继时,这个开销是白交的。
一个实战细节:高呼叫建立/拆除速率下,别用动态 nftables 规则——规则的增删本身会成为瓶颈。用一条覆盖整个媒体 UDP 端口范围的静态规则,让内核模块自己在里面转发。
第二,WebRTC 一站终结。 ICE/Trickle ICE、DTLS-SRTP、RTP/RTCP Mux、BUNDLE,还有 RTP↔SRTP、SRTP↔SRTP 的桥接——这些浏览器侧的媒体协商全交给 rtpengine。FreeSWITCH 自己也能处理 ICE/DTLS,但那会占掉本该留给应用逻辑的 CPU。让 rtpengine 专职干这个,FreeSWITCH 的核就解放出来做转码、会议、IVR。
第三,媒体锚定与 media fork。 rtpengine 通过改写 SDP 把所有媒体流锚定到自己身上,NAT 穿越统一处理,拓扑隐藏也更彻底——外面看不到后面那排 FreeSWITCH 的真实地址。而 media fork 能把通话的 RTP 流实时复制一份,喂给 AI 分析服务(实时转写、情感分析、质检),不碰主通话路径的延迟。做智能呼叫中心,这一条是刚需。
三件套怎么分工:一张图讲清
把三个东西摆到一起,职责就清爽了:OpenSIPS 站信令边缘,rtpengine 站媒体代理,FreeSWITCH 退成一排纯媒体工人。
flowchart TB
    trunk["PSTN Trunk"]
    webrtc["WebRTC"]
    phone["SIP Phone"]

    subgraph sig["信令层"]
        opensips["OpenSIPS HA<br/>注册/鉴权/路由 · WSS 终结<br/>拓扑隐藏 · 负载均衡/故障转移<br/>基于 FS 实时负载调度"]
    end

    subgraph media["媒体代理层"]
        rtpengine["rtpengine HA<br/>NAT/SRTP/ICE · WebRTC 桥接<br/>内核态 RTP 转发 · media fork → AI"]
    end

    subgraph engine["媒体/应用引擎层(纯媒体工人 · 无状态 · ESL 受控)"]
        fs1["FreeSWITCH<br/>IVR/放音"]
        fs2["FreeSWITCH<br/>会议"]
        fs3["FreeSWITCH<br/>转码/录音"]
    end

    subgraph svc["自研微服务 (K8s)"]
        micro["FS Adapter (ESL)<br/>ACD/路由 · AI 编排<br/>坐席状态 · CDR"]
    end

    trunk --> opensips
    webrtc --> opensips
    phone --> opensips
    opensips -->|SIP| rtpengine
    rtpengine -->|RTP| fs1
    rtpengine -->|RTP| fs2
    rtpengine -->|RTP| fs3
    fs1 -->|ESL Events/Commands| micro
    fs2 -->|ESL Events/Commands| micro
    fs3 -->|ESL Events/Commands| micro
关键的设计动作是把 FreeSWITCH 精简成无状态媒体工人:拿掉内置的 mod_callcenter(它的单机 ACD 用 SQLite 存状态,根本不是分布式编排平台),把状态外置到 Redis/PostgreSQL,禁掉用不上的模块,Docker 化。它只干一件事:接受 ESL 命令,处理媒体,产出事件。ACD、智能路由、AI 编排这些业务逻辑,全搬到 Kubernetes 上的微服务里,通过一个 FS Adapter(ESL 网关,Go/Rust 写)把 ESL 事件翻译成 Kafka/NATS 领域事件。
这样一来,三种负载各扩各的:信令按 CPS 扩 OpenSIPS,媒体按 PPS/带宽扩 rtpengine 和 FreeSWITCH,业务按并发扩微服务。谁是瓶颈扩谁,不再互相绑架。
容量能提到什么量级
分工的价值最终要落到数字上。下面这组是参考量级,具体到你的 dialplan、编解码、功能配置上会有出入,务必用 SIPp 在真实配置下实测,别信理论值。
| 维度 | 纯 FreeSWITCH | 三件套组合 | 提升来自哪 |
|---|---|---|---|
| 信令处理(CPS) | ~100–300 | 10,000+ | OpenSIPS 接管信令边缘,FS 只碰需要媒体的呼叫 |
| 并发媒体流 | ~500–1000/节点 | 线性水平扩展 | OpenSIPS 按实时负载调度到多个 FS 节点 |
| WebRTC 终结 | FS 自行处理 ICE/DTLS | rtpengine 专职 + 内核态转发 | FS 的 CPU 释放给应用逻辑 |
| NAT 穿越 | 每个 FS 各自处理 | rtpengine 统一媒体锚定 | 简化 FS 配置,拓扑隐藏更彻底 |
| 高可用 | 单点故障 | 每层独立 HA | OpenSIPS 探测 FS 健康并自动故障转移 |
| 注册容量 | ~数千 | 10 万+ | OpenSIPS 分布式 usrloc |
容量规划有条原则值得记住:FreeSWITCH 节点按实测饱和容量的 60–75% 设 admission control(max-sessions、sessions-per-second),留出余量给突发和故障转移时的负载转移。OpenSIPS 的 load_balancer 配合 freeswitch 模块实时感知每台 FS 还剩多少 CPU 和 session,把这个余量用活。
落地:分三步,别一次到位
想清楚了架构,落地要分层推,别指望一步到位。
-
先立信令和媒体两道边缘。 部署 OpenSIPS HA 做 SIP 信令边缘,配
load_balancer+freeswitch模块做容量感知调度;部署 rtpengine 处理 NAT/SRTP/WebRTC 桥接。这一步做完,你已经有了一个能横向扩、能故障转移的 FreeSWITCH 集群。 -
再把 FreeSWITCH 精简成媒体工人。 移除
mod_callcenter,禁掉用不上的模块,状态外置,Docker 化,通过 ESL 接受外部控制。开发 FS Adapter(Go/Rust),把 ESL 事件翻译成领域事件发到 Kafka/NATS。这一步把业务逻辑从交换核心里彻底剥出来。 -
最后把业务和 AI 搬到外面。 外部 ACD 服务做技能路由、全渠道排队、坐席状态管理;通过 rtpengine 的 media fork 接 Streaming ASR、实时质检、情感分析;LLM/RAG 做知识驱动的 AI Agent。这一步是长期演进,但前两步的信令层和媒体层投资会一直有效。
一句话:
别重起炉灶,也别硬堆 FreeSWITCH。留它的媒体引擎,补它的信令和媒体传输,剥它的业务逻辑。 重写一个软交换,二十年的协议兼容性、边界 case、运营商适配经验没法短期复现;而硬堆 FreeSWITCH,堆的是一堆互不相认的孤岛。分层增强是这两个极端之间唯一走得通的路。
总结:扬长避短,比推倒重来靠谱
FreeSWITCH 到今天仍是最成熟的开源媒体/B2BUA 引擎,它的问题从来不是"不够好",而是"什么都想自己扛"。二十年前一台机器跑一个软交换实例,这个假设合理;今天要上万路、要高可用、要云原生,这个假设过期了。
正确的做法不是换掉它,而是给它配两个搭档:OpenSIPS 补上它最缺的信令集群和智能调度,rtpengine 补上它最费的媒体传输和 WebRTC 终结,FreeSWITCH 退回它最擅长的媒体处理。 三件套不是三个工具的简单叠加,是把"信令、媒体、业务"这三种本就该分开的关注点,重新切回它们各自的边界。
判断一个老架构还值不值得用,我的两把尺子始终是这两条:先看它的核心能力过没过时,再看它的时代假设还成不成立。 FreeSWITCH 的媒体引擎没过时,它的"单机全包"假设成不立了——留前者,补后者,就这么简单。
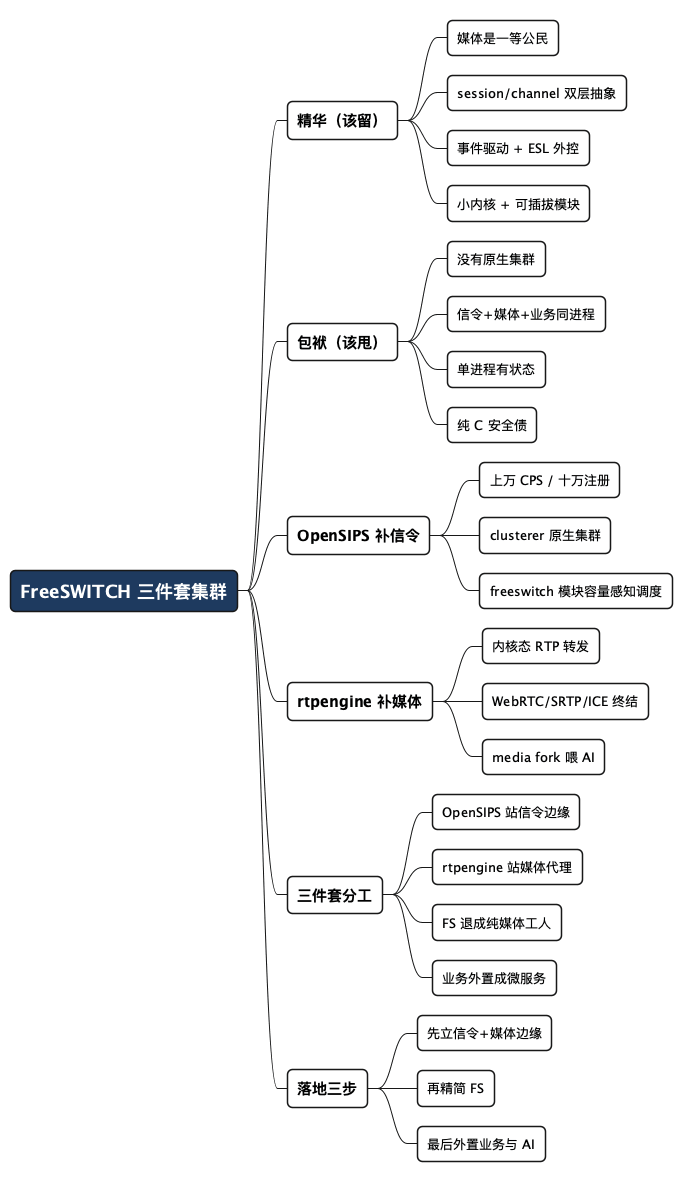
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* FreeSWITCH 三件套集群
** 精华(该留)
*** 媒体是一等公民
*** session/channel 双层抽象
*** 事件驱动 + ESL 外控
*** 小内核 + 可插拔模块
** 包袱(该甩)
*** 没有原生集群
*** 信令+媒体+业务同进程
*** 单进程有状态
*** 纯 C 安全债
** OpenSIPS 补信令
*** 上万 CPS / 十万注册
*** clusterer 原生集群
*** freeswitch 模块容量感知调度
** rtpengine 补媒体
*** 内核态 RTP 转发
*** WebRTC/SRTP/ICE 终结
*** media fork 喂 AI
** 三件套分工
*** OpenSIPS 站信令边缘
*** rtpengine 站媒体代理
*** FS 退成纯媒体工人
*** 业务外置成微服务
** 落地三步
*** 先立信令+媒体边缘
*** 再精简 FS
*** 最后外置业务与 AI
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。