我本来想给这个仓库写一份 AGENTS.md,两篇论文劝住了我
Posted on in Tech
| Abstract | AGENTS.md 该写什么、不该写什么:两篇论文给出的证据 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-11-11 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 一个没写成的 AGENTS.md:这个博客仓库里堆了一堆
.claude/skills,却没有一份 AGENTS.md,/init 按下去之前我多想了一步 - 两篇论文在测两件不同的事:一篇挖"大家写了什么",一篇测"写的东西有没有用"
- 大家实际在写什么:测试、实现细节、架构是标配,安全和性能是留白
- 写了的东西到底有没有用:自动生成的概览段落是噪音,开发者手写的才真正管用
- 为什么会这样:agent 很听话,问题是喂给它的信息没有增量
- 那我到底该写什么:一份删繁就简的清单
- 总结:写得越少,越像指令
这个博客仓库的 .claude/skills/ 目录下已经攒了十几个技能文件夹——写博客的、写工作笔记的、跑 OpenSpec 流程的。唯独少一样东西:仓库根目录没有 AGENTS.md,也没有 CLAUDE.md。按现在的惯例,这事儿挺反常的——毕竟官方统计,带这类文件的 GitHub 仓库已经超过六万个,各家 agent 的欢迎页都在推荐你"跑一下 /init,几秒钟生成一份"。
我也确实把手放到键盘上准备跑那条命令了,脑子里却卡了一下:这玩意儿生成出来,除了让我心里踏实一点,真的会让 Claude Code 干活更准、更快吗?还是说我只是在表演"我重视这件事"?
这问题值得认真查一查,而不是凭直觉。翻了两篇今年的论文,一篇挖矿、一篇测试,合起来刚好把这个疑问回答得差不多了。
两篇论文在测两件不同的事
第一篇(Chatlatanagulchai 等,Agent READMEs,arXiv:2511.12884)是挖矿式研究:从 1,925 个仓库里抓了 2,303 份 CLAUDE.md / AGENTS.md / copilot-instructions.md,统计结构、提交历史、内容分布。它回答的是"开发者实际在写什么",不碰任务成功率。
第二篇(Gloaguen 等,Evaluating AGENTS.md,arXiv:2602.11988)是基准测试:拿 SWE-bench(知名仓库 + AI 自动生成的 context file)和作者新建的 CTXbench(138 个任务,来自 12 个带开发者手写 context file 的冷门仓库)跑了 Claude Code、Codex、Qwen Code 三种 agent,对比"有没有这份文件、谁写的"对成功率和成本的影响。它回答的是"写了到底有没有用"。
两篇结论不矛盾,是互补:前者告诉你大家在囤什么,后者告诉你囤的东西里哪些是噪音。
大家实际在写什么
第一篇论文把内容归成 16 类,统计出每类在 2,303 份文件里出现的比例。排前面的和排后面的,差得相当悬殊:
| 类别 | 渗透率 | 大致内容 |
|---|---|---|
| 测试(Testing) | 75.9% | 测试命令、怎么判断过没过 |
| 实现细节(Implementation Details) | 70.8% | 代码风格、命名约定 |
| 架构(Architecture) | 68.1% | 高层设计、目录职责 |
| 开发流程(Development Process) | 65.1% | Git 工作流、PR 要求 |
| 构建运行(Build and Run) | 63.0% | 构建/启动命令 |
| 项目概览(System Overview) | 59.0% | 这是个什么项目 |
| …… | …… | …… |
| 安全(Security) | 14.8% | 安全准则——倒数第二 |
| 性能(Performance) | 14.5% | 性能准则——倒数第三 |
| UI/UX | 8.7% | 用户体验标准——最少 |
结构上三家 agent 的文件都很"浅":中位数 1 个 H1、6~7 个 H2、9~12 个 H3,H5 以下几乎绝迹(全库 2,303 份文件里 H5 只出现 9 次,H6 为 0)。维护模式也很说明问题:67% 的 Claude Code 文件被反复修改,中位间隔是以"天"为单位(Claude Code 约 23.8 小时、Copilot 约 68 小时),而且 92% 的修改是实打实的增删指令,不是格式调整——这玩意儿不是写一次扔那儿的文档,是活的配置,大家确实在持续经营它。
问题是,经营的方向全往"测试、实现、架构"这几类使劲,安全和性能这两块关乎代码质量下限的内容,十个项目里不到两个会提。这不是疏忽,更像是一种集体的注意力盲区——写"怎么跑测试"容易,写"数据库交互必须用参数化查询"这种防御性规则,大多数人想不到要写进去。
写了的东西,到底有没有用
这才是真正扎心的部分。第二篇论文把 context file 分成三种情况去跑基准测试:完全不给(None)、用 agent 官方推荐的 /init 自动生成(LLM)、用仓库里开发者自己手写的那份(Dev)。结果是:
| 对比 | 任务成功率变化 | 推理成本变化 | 统计显著性 |
|---|---|---|---|
| 自动生成 vs 不给 | SWE-bench −0.5%,CTXbench −2% | 步数 +2.45~3.92,成本 +20%~23% | 成功率不显著(p=0.87 / 0.37);成本高度显著(p<0.001) |
| 开发者手写 vs 不给 | 平均 +2.4% | 成本最多 +19% | 单看不显著(p=0.21) |
| 开发者手写 vs 自动生成 | 显著高出 7 个百分点 | — | 显著(p=0.038) |
翻译一下:自动生成的那份文件,对任务能不能做成几乎没有统计学意义的帮助,却实打实让每次任务贵了两成左右。开发者手写的那份也不便宜,但明显比自动生成的管用——差距足足有 7 个百分点。
论文继续往下查,为什么自动生成的东西不管用。一个重灾区是"项目概览"段落——几乎所有模型生成的 context file 都带一段"这是个基于 xxx 框架的 xxx 项目"(Sonnet-4.5 生成的文件 100% 带这一段)。作者用"agent 第一次碰到 PR 要改的那个文件,之前走了几步"来衡量这段概览有没有帮上忙,结果是:有没有这段概览,agent 定位到正确文件的速度几乎没区别。换句话说,这段内容纯粹是和仓库里本来就有的 README 重复,占 token,不提速。
但这里有个反转:如果把仓库里所有文档(README、docs/、示例代码)全删掉,只留 context file,自动生成的那份反而能稳定带来 +2.7% 的提升,还超过开发者手写的那份。这说明它的价值定位很清楚——顶替缺失的文档,而不是锦上添花。你仓库里如果已经有一份像样的 README,AGENTS.md 里再写一遍"项目是什么"就是纯粹的浪费。
为什么会这样:agent 很听话,问题出在喂的内容
论文没有止步于"没用",还往下查了一层:是不是 agent 压根没把 context file 的话当回事?答案是否定的。研究者翻了 agent 执行任务时的调用记录:如果 context file 里提到某个命令行工具(比如 uv),这个工具在后续任务里被调用的频率,会从每任务不到 0.01 次,跳到 1.6 次;提到仓库专属工具后,调用频率从不到 0.05 次跳到 2.5 次。
这组数字说明一件事:agent 不是不听话,是你喂给它的东西本身没有信息增量。 它会老老实实执行你写的每一条具体指令——所以当这条指令是"用 uv 装依赖",它真的会去用;但当这条"指令"其实是一段和 README 重复的项目简介,它除了多花几步去读、去反复确认,什么新行为都不会产生。这也顺带解释了论文另一个发现:文件长度和任务成功率没有相关性——写得长不等于写得对,关键是每一段有没有在说 README 里没说过的话。
那我到底该写什么
把两篇论文的证据拼起来,得到的不是"别写 AGENTS.md",而是一份反着来的写作清单:
- 先做减法。 写任何一段之前问自己:README 里有没有?有就删,最多留一行链接过去。项目是什么、用什么框架,这类话不值得在 AGENTS.md 里再说一遍。
- 优先写这三类:可验证的测试命令(含怎么判断通过)、项目特有的实现/命名约定、构建运行命令。这是真实项目里渗透率最高、也是 agent 遵照率最高的三类。
- 主动补两块最容易被漏掉的东西:
- 安全:比如"所有数据库交互必须用参数化查询""禁止把密钥提交进仓库";
- 性能:比如"什么情况需要手动优化,什么情况框架默认表现已经够用"。 别指望 agent 会像资深工程师一样自带安全直觉——它高度依赖你写没写这条规则。
- 别无脑提交
/init跑出来的东西。 跑完先看一眼,是不是在复述 README 已经写过的内容,是的话删掉,只留 agent 专属的、人类读 README 不会读到的那部分。 - 结构收着写:一个 H1,六七个 H2 打住,H3 不超过十来个,别往下堆。
- 当配置代码管。 改动进代码审查流程;架构、开发流程这类高影响段落配上 CODEOWNERS;留个 changelog,别让它变成只增不减的流水账。
至于我那个没写成的 AGENTS.md,想清楚之后反而没那么纠结了:这个仓库每个技能文件夹自己的 SKILL.md 已经把"怎么干活"写得很细,根目录真正缺的,是一份只写"这几个技能文件夹分别管什么、新技能往哪儿放"的指路牌——不是项目概览,是一份不会和已有文档打架的索引。这篇写完,这件事也该动手了。
总结:写得越少,越像指令
AGENTS.md 的价值不来自写得全,来自写得准。先删掉和 README 重复的内容,再补上安全和性能这两块真实项目里最常漏掉的 guardrail,最后才考虑要不要用 /init 打底。agent 会老实执行你写的每一条具体指令——这既是它最大的优点,也是为什么一段空洞的"项目概览"除了费 token 之外什么都换不来。
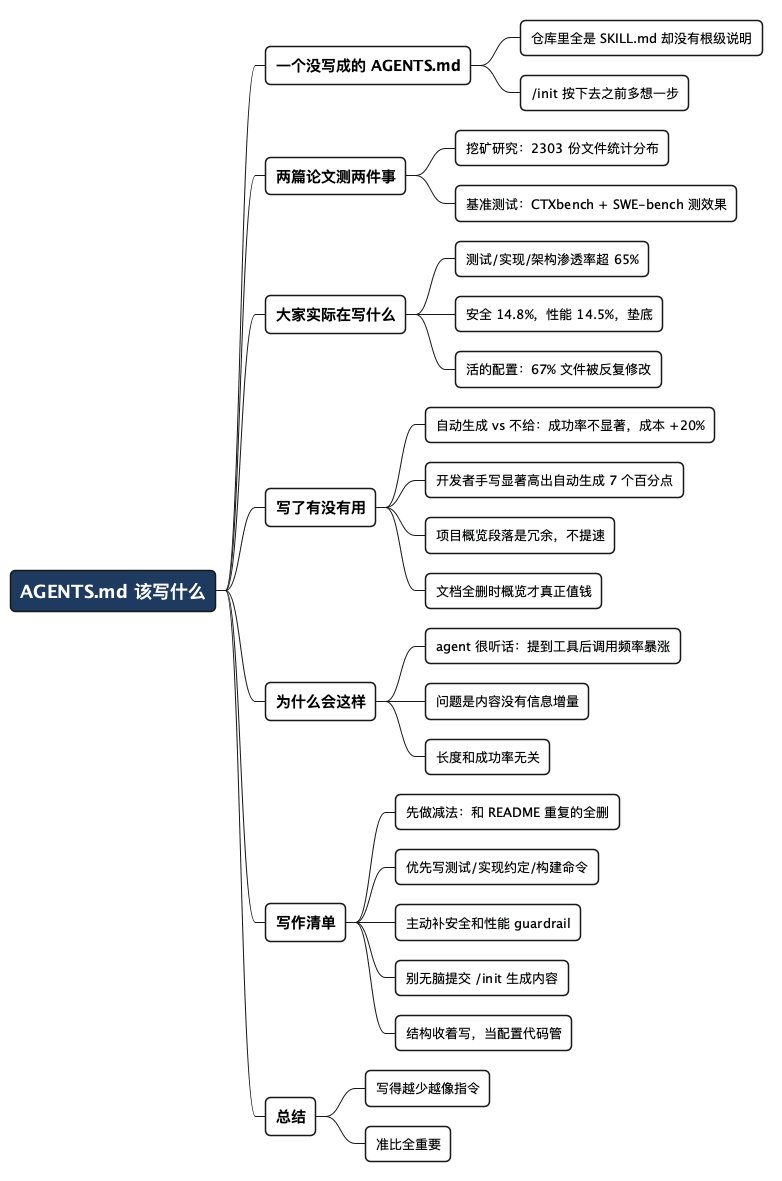
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* AGENTS.md 该写什么
** 一个没写成的 AGENTS.md
*** 仓库里全是 SKILL.md 却没有根级说明
*** /init 按下去之前多想一步
** 两篇论文测两件事
*** 挖矿研究:2303 份文件统计分布
*** 基准测试:CTXbench + SWE-bench 测效果
** 大家实际在写什么
*** 测试/实现/架构渗透率超 65%
*** 安全 14.8%,性能 14.5%,垫底
*** 活的配置:67% 文件被反复修改
** 写了有没有用
*** 自动生成 vs 不给:成功率不显著,成本 +20%
*** 开发者手写显著高出自动生成 7 个百分点
*** 项目概览段落是冗余,不提速
*** 文档全删时概览才真正值钱
** 为什么会这样
*** agent 很听话:提到工具后调用频率暴涨
*** 问题是内容没有信息增量
*** 长度和成功率无关
** 写作清单
*** 先做减法:和 README 重复的全删
*** 优先写测试/实现约定/构建命令
*** 主动补安全和性能 guardrail
*** 别无脑提交 /init 生成内容
*** 结构收着写,当配置代码管
** 总结
*** 写得越少越像指令
*** 准比全重要
@endmindmap
参考与延伸
- Chatlatanagulchai, W. et al. Agent READMEs: An Empirical Study of Context Files for Agentic Coding. arXiv:2511.12884——2,303 份真实 CLAUDE.md / AGENTS.md / copilot-instructions.md 的挖矿研究,16 类指令渗透率、结构、维护模式的数据均出自这篇。
- Gloaguen, T. et al. Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?. arXiv:2602.11988——CTXbench + SWE-bench 基准测试,本文里成功率、成本、工具调用频率的数字均出自这篇。
- agents.md——AGENTS.md 格式的官方站点,统计口径"六万多个仓库"出自这里。
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。