模型吃得越多,忘得越快:Anthropic 谈上下文工程
Posted on in AI
| Abstract | 模型吃得越多,忘得越快:Anthropic 谈上下文工程 |
|---|---|
| Authors | Walter Fan |
| Category | learning note |
| Version | v1.0 |
| Updated | 2026-11-10 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 换了个战场:从雕 Prompt 到管上下文,这不是改写法,是换心态
- 为什么当回事:注意力是一笔有限预算,喂得越多记得越差
- 好上下文长什么样:最小的高信号 Token 集合——System Prompt 的海拔、工具、示例
- 用到再取:按需检索、渐进式披露,和那条混合路线
- 长任务的三件套:压缩、结构化笔记、子代理,各吃哪一路
- 总结:模型越聪明,越要管好它的上下文
年初我写过一篇 《Prompt 工程已死,上下文工程当立》,当时更多是给自己打气式的判断,例子是我用上下文组装写了个原型。最近 Anthropic 把这事系统性地立了论,发了篇文章,题目就叫《Effective context engineering for AI agents》(2025年9月)。一句话说清它的主张:Prompt(提示词)怎么写已经没那么要紧了,要紧的是管好“喂给模型的那一袋子 Token”。
这个主张几乎反直觉。以前大家的共识是“提示词写得好,模型就听话”;Anthropic 说方向反了——模型不是靠你多叫两声才聪明的,你塞给它的东西越多,它越糊涂。
这篇文章的干货就藏在这种反直觉里。它有硬道理(模型的注意力是有限资源)、有可照抄的做法(System Prompt 该写到多具体、工具该咋设计)、也有长任务的三件套(压缩、笔记、子代理)。
换了个战场:从“怎么写”到“喂什么”
Anthropic 给出的定义很干脆:上下文(Context)就是模型生成时喂进去的那批 Token(托肯,模型眼里的“字词块”)的总和;上下文工程,就是持续挑选、维护这批 Token,让它最有机会引出我们想要的行为。
这和 Prompt 工程的区别,不是程度深浅,是层级不同:
| 维度 | Prompt 工程 | 上下文工程 |
|---|---|---|
| 操心什么 | 系统提示词本身怎么写 | 整袋信息:指令、工具、外部数据、历史对话 |
| 干的时机 | 写一次,基本定型 | 每次推理前都要重新打理一次 |
| 面对的状态 | 静态文本 | 不断生长的 Agent 运行状态 |
| 打个比方 | 写菜谱 | 管整个厨房——冰箱里有什么、火候、备料 |
关键在最后一格。Prompt 工程面对的是“一句话的任务”,写一次基本够用;而 Agent(自主调用工具的 AI)在循环里跑,越跑越产生新数据,这一秒觉得重要的信息,下一秒可能就成了噪音。上下文工程是在一个随时变化的信息池塘里,反复捞起眼下最有用的那几瓢。 我年初那篇把它叫 RAG 的上位概念,其实说小了——RAG 只是“捞”这个动作里的一种工具,上下文工程管的是“为什么捞、捞多少、捞完用什么姿态送进去”。
为什么当回事:注意力是一笔有限预算
为什么不能把信息一股脑全塞进去?Anthropic 给了三层道理,从现象到原理。
第一层是现象,有个专门的名字叫上下文腐烂(context rot):拿“大海捞针”这类评测去看,上下文窗口里 Token 越多,模型准确记起其中某条信息的能力越差。和人类一样,模型能装的多,能“聚焦”的少。
第二层是原理。大模型基于 Transformer(一种让每个词都同时“看”到所有其他词的结构),N 个 Token 之间有 N² 对两两关系。Token 一多,这 N² 份注意力被摊薄,模型顾不过来。而且它训练时见过的多是短文本,长文里的长程依赖本来就练得少。
第三层是现实:没有悬崖,只有下滑。 常用位置编码插值这类招数把模型硬撑到长上下文,代价是丢一点对位置的理解。所以模型在长上下文里不是“突然不会”,是慢慢变迟钝——这正是工程上最阴险的那种退化,界面还在,精度没了。
结论一句话:上下文得当成有限预算花,边际收益递减。我平时用 Claude Code 改代码体会很深——它不是靠上下文大才干活,是靠“该带的东西带对了”才干活。
好上下文长什么样:最小的高信号 Token
原则只有一条,做起来全是取舍:找出能引出理想结果的最小高信号 Token 集合。 “最小”不是“最短”,该给的背景一句不能少;它是说每一份塞进去的东西都要配得上它占的位子。按作用拆成三样。
System Prompt 要停在“正确的海拔”。 这是全文我最认同的说法:海拔太低和太高都会翻车。太低——把复杂逻辑硬编成 if-else 塞进提示词,逼出精确但脆弱的行为,改一处牵一发动全身;太高——给一堆含糊的大方向,既没给具体信号,还假装双方共享了上下文。正确答案在中间:具体到能引路,宽松到留出判断。 具体做法:把提示词分节(背景、指令、工具指引、输出格式),用 XML 标签或 Markdown 标题隔开;先用最强模型配一个极简版本跑起来,再看失败模式往里添指令和示例。不是一上来就堆规则。
工具要“自足、省 Token、彼此不重叠”。 工具是 Agent 和外界签的合同——设计得越清楚,Agent 越知道什么时候用哪个。常见翻车是把工具做成一大坨,功能堆叠,导致 Agent 在“该调哪个”上犯选择困难。Anthropic 有句话很扎心:一个人类工程师都说不清该用哪个工具,就别指望 Agent 比你想得更明白。 所以宁可用最小够用的一组工具,换来后续好维护、好修剪。
示例要“典范”,不是“清单”。 少样本(few-shot,给几个例子让模型照着做)依然是强推的做法,但别把边角案例一辆车装进去。经典例子像“一百句抵一张图”——一套多样且有代表性的典范示例,胜过一份逐条枚举的规则清单。
一句话记住这节:上下文要“informative yet tight”——信息得足,线得绷紧。
用到再取:Agent 时代的检索
进入正题前的思路转变:很多 AI 应用还在用“先向量化、推理前把相关内容事先捞好”的传统做法。Anthropic 观察到,越彻底走 Agent 路线的团队,越在给这套检索加一层“用到再取”的策略。
用到再取(just-in-time):不预先处理全部数据,只给 Agent 留轻量指路牌——文件路径、存好的查询、网页链接——跑起来后让 Agent 用工具把需要的数据现拉进上下文。Claude Code 在超大数据库上做分析就是这么干的:写针对性查询、存中间结果、用 Bash 的 head/tail 只看数据片段,全程不把整块数据搬进上下文。这几乎是照着人的习惯来的:没人把整个图书馆背下来,靠的是文件系统、收件箱、书签这些外部索引,要用才查。
妙处有二。一是省空间;二是元数据本身就是信号:tests 目录下的 test_utils.py 和 src/core_logic/ 下的同名文件,含义天差地别;目录层次、命名习惯、时间戳,都在告诉 Agent“这盘菜什么时候、该怎么吃”。上文推理的每个结果又成了下文的输入——这构成所谓渐进式披露(progressive disclosure):文件大小暗示复杂度,命名透露用途,时间戳代理新鲜度,Agent 一层层自己搭起理解,只留最要紧的在工作记忆里,其余交给笔记。
当然有代价:运行时现找比预计算慢,还特别考验工程功力——工具和试探套路没配好,Agent 会把上下文浪费在瞎调工具、追死胡同、漏看关键信息上。所以更常见的赢法是混合:CLAUDE.md 这类规则和背景无脑预载,glob/grep 这类原语让 Agent 按需翻文件,既躲开“索引过期”,也不用非把文件系统塞成语法树。Anthropic 说这种混合策略在内容变动少的场景(比如法律、金融)尤其合适。建议落回大实话:“做最简单、现在就能用的东西”,等模型更聪明了再说。 这个博客仓库里就躺着这样的结构——.claude/、.agents/、.cursor/ 里各自收着的 SKILL.md,它的 name/description 被预载,正文留到相关才整篇读入;剩下靠 Agent 自己按需翻。这也是我在用的混合路线。
长任务的三件套:压缩、笔记、子代理
上下文窗口再大,也罩不住持续几小时的大活——大型代码库迁移、大范围调研,Token 数必然会冲破窗口。等着更大的窗口不是办法,Anthropic 说大窗口一样会被“污染”、一样会丢重点。对付长任务,他们给了三件套。
一、压缩(Compaction)。 对话快到上限时,把它总结成摘要、开一个干净的新窗口接着跑。别小看这一步——Claude Code 正是把历史丢给模型去压缩,保留下架构决策、未解决 bug、实现细节,扔掉冗余的工具输出,再带上最近访问的 5 个文件续上。压缩的功夫全在“留什么、丢什么”的判断上:压过头,会把当时不起眼、后来才显灵命的上下文一起丢了。调法有讲究:先在复杂的 Agent 轨迹上把召回率调到最高(什么都要摘全),再迭代提精度(把废话滤掉)。最轻量的一种压缩是“清工具结果”——工具调完,原始大段结果就没必要一直留在历史里了,这已经成了开发者平台的一个独立功能。
二、结构化笔记(Agentic Memory)。 让 Agent 把状态写到上下文窗口之外的笔记里,需要时再读回来。这就是 Agent 版的“记本子”:Claude Code 的待办清单、你给 Agent 配的 NOTES.md,都是这个套路,开销极小、跨很多步还能记得前因后果。Anthropic 用 Claude 玩《宝可梦》(Claude Plays Pokemon)当例子:它一本正经地记着“过去 1234 步我都在一号路练级,皮卡丘朝 10 级的目标已经升了 8 级”,还自己画出已探索区域地图、解锁成就清单、记下对不同对手的有效打法——上下文一重置,它就翻读自己的笔记继续几个小时的特训。这个博客项目里 .claude/、.cursor/ 下那些 SKILL.md,本质就是我这边的“结构化笔记”,把常驻知识沉淀在窗口外面。
三、子代理(Sub-agent)。 与其一个 Agent 从头撑到尾,不如让专职子代理各干一段、各自带着干净的上下文跑:主 Agent 拿顶层计划协调,子代理深入干活或查资料,自己烧掉几万个 Token 的探索,只回来一份一两千 Token 的浓缩摘要。搜索的细节被隔离在子代理里,主 Agent 专心综合和判断——职责分离,谁也拖不垮谁。Anthropic 自家的多智能体研究系统用的就是这套,复杂研究任务上比单 Agent 明显强。
三件套怎么选,看任务脾气:来回拉扯多、要保对话流,用 压缩;迭代开发、里程碑分明,用 笔记;复杂研究分析、值得并行探索,用子代理。三者不互斥,长项目里常常混着用。
总结:模型越聪明,越要管好它的上下文
把 Anthropic 这篇收拢成一段:模型的“注意力”是一笔越喂越稀缺的预算,上下文工程就是反复挑出那批高信号 Token,别让垃圾挤掉重点。 压缩、结构化笔记、子代理、按需检索……招式列表会不断换,但内核那句不变——找到能引出理想结果的最小 Token 集合。
还有一层趋势值得记住:模型越聪明,越不需要我们手把手教。 Anthropic 反复强调,“做最简单、现在能用的东西”(do the simplest thing that works),让模型自主,把人力留给“搭对上下文”而不是“写死行为”。以后调 Prompt 的日子会越来越短,管上下文的日子会越来越长——年初那篇我下判断略早,这篇算把账补上了。
对你现在写代码用 AI 的直接启示:下次模型答非所问,先别急着改咒语,抬头看看这一袋子喂进去的到底是什么——是不是该装的东西没装,不该装的东西装了一大堆。
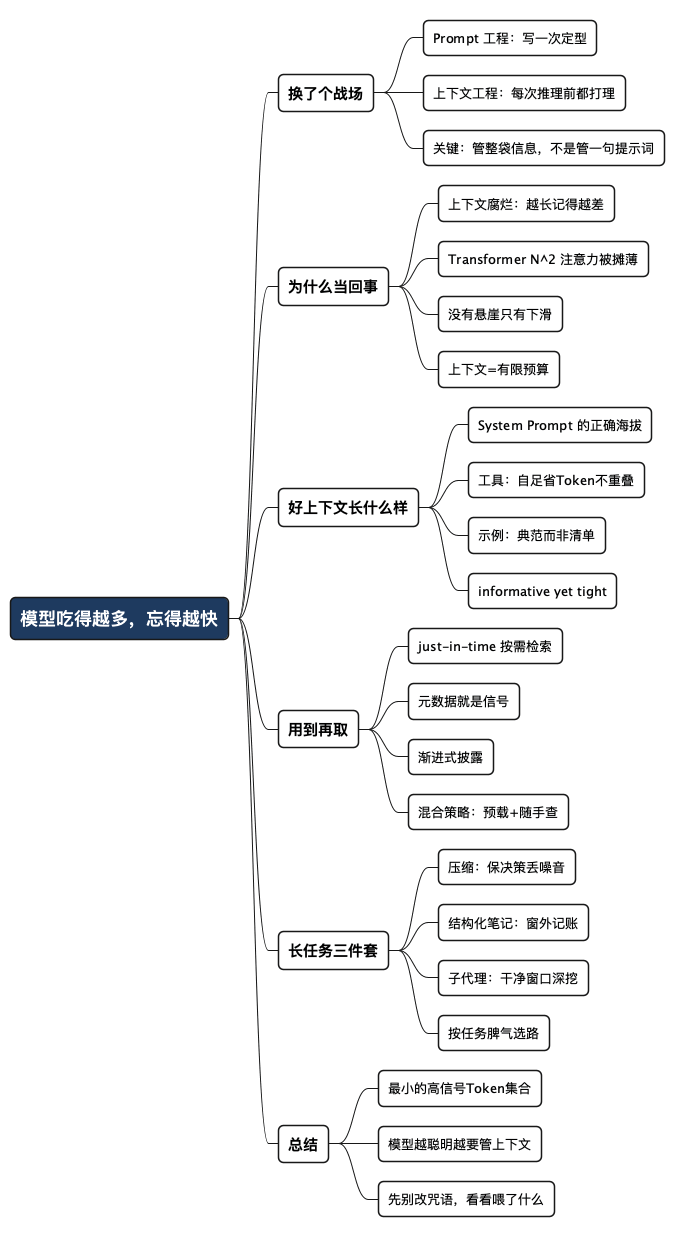
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* 模型吃得越多,忘得越快
** 换了个战场
*** Prompt 工程:写一次定型
*** 上下文工程:每次推理前都打理
*** 关键:管整袋信息,不是管一句提示词
** 为什么当回事
*** 上下文腐烂:越长记得越差
*** Transformer N^2 注意力被摊薄
*** 没有悬崖只有下滑
*** 上下文=有限预算
** 好上下文长什么样
*** System Prompt 的正确海拔
*** 工具:自足省Token不重叠
*** 示例:典范而非清单
*** informative yet tight
** 用到再取
*** just-in-time 按需检索
*** 元数据就是信号
*** 渐进式披露
*** 混合策略:预载+随手查
** 长任务三件套
*** 压缩:保决策丢噪音
*** 结构化笔记:窗外记账
*** 子代理:干净窗口深挖
*** 按任务脾气选路
** 总结
*** 最小的高信号Token集合
*** 模型越聪明越要管上下文
*** 先别改咒语,看看喂了什么
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。