从容灾到异地双活:数据层怎么选,以 Redis 为例细讲
Posted on 日 11 10月 2026 in Tech
| Abstract | 从容灾到异地双活:数据层怎么选,以 Redis 为例细讲 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v2.0 |
| Updated | 2026-10-12 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 一句话:别一上来就问"用什么库"。顺序是:先定容灾目标(RTO/RPO)→ 再定要不要双活、怎么分层 → 最后才选存储。换库不改变一致性约束,只改变你在哪一层交光速的税。
- 容灾怎么做:RPO(能丢多少数据)、RTO(能停多久服务)是两把独立的尺子;常用做法按成本从低到高是冷备份→主备异步→主备半同步→双活→多活/强一致,按业务容忍度选够用那一档,不是越强越好。
- 异地双活怎么做:双活只是容灾梯度里偏贵的一档,不是银弹。难点不在"选个库",在于把数据按一致性诉求分成四类(信令/扣减/追加/协调),每类单独定档——因为没有库能让强一致写不等 RTT。
- 数据层选型,以 Redis 为例:信令/会话 Redis 是主场;但 Redis Cluster 原生不为跨机房设计,要靠双集群复制。三种拓扑(单集群跨机房=脑裂坑、双集群单向=主备、双集群双向+key 前缀=务实双活)。
- 拓扑二主集群挂了怎么切:单向异步 RPO 恒大于 0。切换五步 + "A 修好先当从别直接回切"的防回流闸门。想缩小窗口加
WAIT,想真零丢换 NewSQL。 - 双向复制怎么做:两条单向流拼的,靠
redis-shake搬、靠 key 前缀切开写入域让冲突不发生;单 key 多地写自动合并要 CRDT(企业版/托管版)。 - Valkey 差异:异地双活这层是开源 Redis 的平替,逻辑照搬(同源 7.2.4)。真正差异在许可证(BSD vs AGPL/SSPL),CRDT 两边开源都没有。
- 其他三类数据:扣减用 NewSQL(Raft 强一致)、追加用 Cassandra(多机房对等写)、协调用 etcd(裁判不是球员)。
- 组合拳:真实的异地双活不是"选一个库",是每类数据配最懂它那种一致性的存储。
上一篇讲音视频服务异地双活用 FreeSWITCH + MySQL,发出去之后被问得最多的一句是:
不用 MySQL 行不行?换 Redis,或者别的库,是不是能更简单/更快地做双活?
这个问题本身就把顺序搞反了。"用什么库"是最后一步,不是第一步。 正确的顺序是:先想清楚容灾要做到什么程度(能丢多少、能停多久),再决定要不要上双活、双活怎么分层,最后才轮到选存储。顺序一反,就会陷入"换个更先进的库就能绕过一致性难题"的幻觉——而这个幻觉不存在。
换存储不改变一致性约束,只改变两件事——你在哪一层交光速那笔税,以及你把冲突处理甩给谁。 这篇就按"容灾 → 双活 → 选型"的顺序走一遍,最后以 Redis 为例把数据层选型讲透。
- 这篇默认你做过音视频/通信后端,SIP、RTP、主从复制这些术语直接用。
- 下面的配置和参数都是示意,用来说明思路,不是生产模板。
第一步:容灾怎么做——先定两把尺子
还没谈双活、没谈选库之前,先把容灾的目标量化。容灾设计有两把尺子,所有后续决策都挂在它们上面。
RTO 和 RPO:一个管"停多久",一个管"丢多少"
- RPO(Recovery Point Objective,恢复点目标):灾难后你能接受丢多少数据。 单位是时间,比如"最多丢 5 秒的数据"。它衡量的是数据丢失量。
- RTO(Recovery Time Objective,恢复时间目标):灾难后你能接受多久恢复服务。 单位也是时间,比如"10 秒内切换完成"。它衡量的是停机时长。
两个都是目标值(Objective)——你和业务约定的容忍上限,不是实际发生的量。一个往故障点的左边看,一个往右边看:
- RPO 往"左"看:从"最后一个没丢的数据点"到"故障时刻"之间的数据就是丢掉的,这段越短 RPO 越好。
- RTO 往"右"看:从"故障发生"到"服务重新可用"之间服务是停的,这段越短 RTO 越好。
一个记忆锚点:RPO 的 P 是 Point(数据点)→ 丢数据;RTO 的 T 是 Time(时间)→ 停服务。
两个最常见的误区要避开:
- "RTO 做好了数据就不会丢"——错。 RTO 再短只是"切得快",切过去的那个备库本来就缺了复制延迟窗口里的数据。RTO 和 RPO 是两个独立目标,得分别达成。
- "RPO=0 和 RTO=0 能一起免费拿到"——不行。 RPO=0 要同步复制(每写付一个跨机房 RTT),RTO=0 要无缝切换(付冗余和复杂度),两个都趋零成本指数上升,而且 RPO=0 在跨机房下会和可用性冲突(CAP 的 CP 一侧)。现实都是定一个"能接受的上限",不是追零。
几种常用容灾做法,按成本从低到高
容灾不是只有"双活"一条路。从最省钱到最贵,是一条清晰的梯度,RPO/RTO 越小,成本越高(上图下半部分):
| 做法 | 机制 | 典型 RPO | 典型 RTO | 适用 |
|---|---|---|---|---|
| ① 冷备份 | 定期快照/导出存异地 | 小时~天 | 小时级 | 成本敏感、数据可容忍大窗口丢失(如离线分析) |
| ② 主备异步 | 热备实时异步复制 | 秒级(>0) | 秒~分钟 | 大多数业务的性价比之选 |
| ③ 主备半同步 | 写后 WAIT/半同步等对端 ACK |
近零 | 秒级 | 关键数据要尽量不丢,能接受写变慢 |
| ④ 双活 | 两地同时接客、按域分写 | 近零~零 | 秒级 | 要两地都利用、扛机房级故障 |
| ⑤ 多活/强一致 | 共识协议多副本(Raft/CRDT) | 0 | 亚秒~秒 | 金融级零丢、预算充足 |
读这张表的正确方式:不是越往下越好,而是按业务对"能丢多少、能停多久"的容忍度,选够用的那一档。 一个内部管理后台用①就行;一个计费系统可能要③或⑤;而大多数业务,②主备异步的性价比最高。
还有三条不分做法、谁都得做的容灾基本功,比选哪一档更重要:
- 定期演练切换,别等真出事才第一次切。 没演练过的切换脚本,真用的时候八成会卡在某个没想到的地方(DNS 缓存、权限、防火墙规则)。上一篇讲"伪双活"也是这个道理——没被真实流量压过的路径不可信。
- 防脑裂的仲裁要独立于两个机房。 判断"主是不是真挂了"的那个裁判(仲裁节点),必须部署在第三个位置,否则机房间网络一断,两边各自判对方死、都提升自己为主,就是双主灾难。
- 别把任何单一存储当唯一真相源。 故障后的对账补偿能成立,前提是丢失的数据在别处还找得回来。多一份权威副本,RPO 的实际影响就小一分。
到这里,第一步完成:你已经有了两把尺子和五档选项。双活只是其中偏贵的一档,不是起点。
第二步:异地双活怎么做——难在分层,不在选库
容灾目标定了,假设业务确实需要"两地同时接客、扛机房级故障",落到了梯度的第④档——双活。那双活具体怎么做?
先破一个最大的误区:双活不是"把数据库配成双主"这么一件事,它的难点根本不在"选哪个库",而在"把数据按一致性诉求分层"。 原因是一条绕不过的物理定律:
跨机房强一致写的延迟下限,是两机房间的 RTT,由光速决定,和你用什么数据库无关。 上海到深圳单程约 1500 公里,光纤里光速打个折,物理极限 RTT 就是十几毫秒起步,加上交换设备实际常在几十毫秒。任何"强一致"的写,都要至少等对端确认一次——这一个 RTT,谁也省不掉。
正因为强一致写必然要付这个 RTT,你不可能让所有数据都强一致(那样每次写都卡几十毫秒)。于是双活的核心工作变成:把数据按"要不要强一致"分类,只给真正需要的那部分付 RTT 的代价。 沿用上一篇音视频服务的四类数据:
| 数据类型 | 典型内容 | 一致性诉求 | 容灾档位 |
|---|---|---|---|
| 信令 / 会话 | 注册、在线状态、路由缓存 | AP,可短暂不一致 | ②主备异步足够(靠重注册自愈) |
| 扣减型 | 余额、并发额度、席位 | CP,防超卖,RPO 趋零 | ⑤多活/强一致 |
| 追加型 | CDR、通话日志、事件流 | AP,最终一致 | ④双活(多机房对等写) |
| 协调 / 元数据 | 选主、分布式锁、配置 | CP,量小但绝对一致 | ⑤强一致(但只存元信息) |
这张表才是双活真正的设计图。 同一个服务,四类数据用四个不同的容灾档位——这不是偷懒,恰恰是把 RTT 那笔税只花在扣减和协调这两类真正需要的地方,其余的用便宜方案。谁要是用"搭一套双主数据库"一招通吃这四类,要么在信令上为不需要的强一致白付延迟,要么在扣减上把超卖风险藏进了异步复制。
所以选型就从"哪个库最好"变成了一个清爽的问题:我这层数据要不要强一致? 要,就选一个把强一致做扎实的库,并接受它的延迟; 不要,就选一个把本地写做快的库,并自己处理最终合并。
接下来第三步,就按这四类逐个落到具体存储,并以最常被问到的 Redis 为例,把它涉及的拓扑、切换、复制细节讲透。
第三步:数据层选型,以 Redis 为例细讲
Redis 是被问得最多的——"信令用 Redis 没问题吧?扣减能不能也用 Redis?"——所以拿它当主线,把一个库在异地双活里的方方面面讲清楚,其他三类数据再快速归位。
Redis 的主场:信令 / 会话层
注册状态(AoR → Contact)、在线状态、路由缓存、呼叫上下文——这些数据的共同特征是:读多写多、单条小、可过期、短暂不一致无所谓。 这简直是照着 Redis 的能力画的。
- 天然带 TTL:SIP 注册本来就有租期(
Expires),Redis 的 key 过期机制和它一一对应。注册续期就是SET key value EX <expires>,到期自动清,不用你写清理逻辑。 - AP 正合适:信令层可以 AP,靠 SIP 重注册自愈。Redis 跨机房异步复制的"短暂不一致"在这层完全可以接受——B 机房晚几百毫秒才知道某终端在 A 掉线,无伤大雅,下个注册周期就对齐了。
- 够快:信令层的 QPS 可能很高(大量注册刷新、路由查询),内存级的 Redis 吃得下,MySQL 在这个量级反而吃力。
# 示意:注册状态存 Redis,和 SIP 租期对齐
SET reg:alice@example.com "sip:alice@10.1.2.3:5060" EX 3600
# B 机房异步复制过来,晚一点无所谓——AP 可接受
一句话:信令和会话层,Redis 比 MySQL 更合适,这是少有的"换库确实更好"的地方。 对应容灾梯度,它用②主备异步就够。
Redis Cluster 跨机房,拓扑怎么摆
既然信令层要用 Redis,就得把它的异地双活拓扑摆清楚。这里有个先入为主的误区得先破:Redis Cluster 的原生设计目标是"单机房内把数据分片到多台机器",不是"跨机房双活"。 它的分片用 gossip 协议维护集群视图、主从之间是异步复制——这两条在单机房内低延迟时都没问题,一旦拉到跨机房,异步复制的延迟和 gossip 的脑裂判定就开始互相打架。
所以跨机房不是"把一个 Redis Cluster 拉长到两地",而是两个独立集群之间按业务方向复制。开源方案有三种拓扑,从保守到激进:
-
拓扑一:单集群跨机房(不推荐)。 把一个 Redis Cluster 的主从节点分散到两个机房。听起来省事,实则是坑:主从跨机房异步复制,延迟高;更致命的是 gossip 的故障判定——机房间网络一抖,集群可能误判半边节点挂了,触发大规模 failover,甚至脑裂成两个都认为自己是主的半区。它把单机房的内部协议硬塞进了跨机房环境,除非两地有极稳的专线,否则别碰。
-
拓扑二:双独立集群 + 单向复制(本质是主备)。 A 机房一个完整集群负责读写,B 机房一个完整集群只读,靠复制工具(如
redis-shake)把 A 的数据单向同步到 B。A 挂了,把 B 提成可写、流量切过去。对应容灾梯度的②。这是最稳的做法,但它是主备不是双活——B 平时不接写,那条写路径没被真实流量压过,切换时风险和上一篇讲 MySQL 半同步主从时一样。胜在简单、不用处理冲突。 -
拓扑三:双独立集群 + 双向复制 + key 前缀分区(开源能做到的务实双活)。 两地各一个集群,双向复制,但两地各写各的 key 空间——A 机房只写
a:*前缀的 key,B 机房只写b:*。双向复制把对方的数据搬过来,于是两地都能读到全量,但永远不会两地同时写同一个 key。对应容灾梯度的④。这就把"跨机房写冲突"从设计上消灭了,和上一篇 MySQL 分片方案是同一个哲学:不解决冲突,而是让冲突不发生。
拓扑二主集群挂了,怎么切 B、怎么尽量不丢数据
这是用拓扑二的人迟早要面对的实操题:A 主集群所在机房整个出问题了,怎么把 B 从只读备份提升为可写主、流量切过去,并且尽量不丢数据。(这里的 RTO、RPO 就是第一步讲的那两把尺子。)
先把最硬的真相摆在前面,别让期望落空:
单向异步复制,RPO 恒大于 0,理论上做不到零丢。 复制是异步的——A 写完本地就给客户端返回 ACK,再慢慢推给 B。所以任意时刻,总有一段"A 已提交、但还没复制到 B"的数据悬在半空(就是那个复制延迟窗口)。A 机房一旦整体失效,这段数据就随 A 一起没了。谁跟你说"Redis 单向复制也能数据不丢",要么没搞懂异步复制,要么把"丢得很少"说成了"不丢"。
认清这条后,切换流程是一套有纪律的动作,顺序不能乱(尤其防脑裂和防回流两道闸门):
- 确认 A 真的不可达,并切断 A 的写入。 这是最容易出事的一步。跨机房"连不上"可能是 A 真挂了,也可能只是机房间网络断了而 A 还活着在接写(网络分区)。如果不确认就提升 B,两地会变成双主——A 这边老客户端还在写 A,B 这边新流量在写 B,数据各写各的,事后无法合并。所以切换前要先通过第三方视角(独立于两机房的仲裁点/监控)确认 A 确实失效,并在接入层把指向 A 的写路由硬关掉(fencing),宁可多等几秒也别双主。
- 确认 B 已追平"能追的"复制流。 让 B 把复制 backlog 里还没应用的数据尽量消化完——注意这只能追到"A 挂之前已经推过来的"部分,那段没推过来的窗口追不回来,但至少别在还没消化完就提升,白白多丢。
- 提升 B 为可写主。 对 B 执行
REPLICAOF NO ONE(Cluster 下是对应的脱离复制、转为独立可写),同时把它原来挂的"从 A 复制"的同步工具停掉,防止 A 万一短暂恢复又把旧数据倒灌回来。 - 把写路由和流量切到 B。 改接入层的写入指向(DNS/配置中心/服务发现),让应用的写从此落 B。SIP 这类有重注册语义的信令层,终端会在下个注册周期自然落到 B。
- 对账补偿丢失窗口。 这是"数据不丢"退而求其次的现实手段:用其他数据源把那段丢失窗口补回来。音视频场景里,很多 Redis 里的状态在别处有权威副本或可重建——注册状态靠终端重注册自愈、计费流水在 CDR(Cassandra/MySQL)里有账、会话上下文可以让客户端重建。能补偿的前提是你平时就没把 Redis 当唯一真相源(这正是第一步那条基本功)。
还有一道常被忽略的闸门——A 修好之后不能直接当主回来:
- A 恢复后,它内存里是"故障那一刻"的旧数据,而 B 已经接了一段时间新写入。如果直接让 A 当主,会用旧数据覆盖 B 的新数据,等于二次事故。
- 正确做法:A 回来后先作为 B 的从(反向复制,
REPLICAOF B),把 B 期间的新数据追过来,确认数据一致、业务稳定后,再在一个计划内的低峰窗口考虑是否回切。很多团队干脆不回切,让 B 一直当主,A 当新的备——避免再切一次的风险。
那"想把丢失窗口压到接近零"怎么办?在纯异步基础上加 WAIT 命令做半同步(就是容灾梯度的③):关键写入后调 WAIT numreplicas timeout,等到对端副本确认收到了再给客户端返回。RPO 能大幅缩小到接近零,但代价诚实——每一次这样的写都多付一个跨机房 RTT,而且对端机房一抖,WAIT 要么超时要么拖慢写入。这又回到了那条铁律:强一致那笔税,你早晚要在某个地方交。
一句话收口这个切换问题:
拓扑二的 failover 能做到"RTO 秒级、RPO 很小",但做不到"RPO 为零"。 真要某类数据零丢失,别指望 Redis 单向复制——把那类数据(通常就是扣减型)下沉到 NewSQL 的 Raft 多数派,或用带同步事务日志的托管存储(如 AWS MemoryDB 的多 AZ 日志)。Redis 的单向复制是"快速恢复"的工具,不是"零丢失"的工具。
双向复制具体怎么做的
开源 Redis 自身没有"双向复制"这个开关,REPLICAOF 只能做单向的主从。所谓双向,是拿两条单向复制拼出来的,靠外部工具搬运数据:
机制拆开看就三步:
- 两个完全独立的集群。 A、B 各自是一个正常的 Redis Cluster(各自有主从、各自 failover),彼此不知道对方存在、不走 gossip。这是和"拓扑一单集群跨机房"的根本区别——没有跨机房的集群协议,也就没有脑裂。
- 两个方向各挂一个复制工具。 常用
redis-shake(阿里开源)这类工具:工具 A→B 持续读 A 集群的写入流(通过psync伪装成从库拿到复制流,或解析 AOF/keyspace notification),把变化写进 B;工具 B→A 反过来。两条流独立运行,合起来就是"双向"。 - 用 key 前缀切开写入域。 应用层约定:连到 A 的写请求只落
a:*,连到 B 的只落b:*。于是工具 A→B 搬的全是a:*、工具 B→A 搬的全是b:*,两条流搬运的 key 集合不相交。任何一个 key 永远只有一个机房在写,复制只是把它的副本送到对面供读。
这套的代价要认清:
- 它不是强一致。 复制是异步的,A 写完
a:user123到 B 能被读到,中间有个跨机房 RTT 的延迟窗口。信令/会话层能接受(AP),但别指望它做强一致的事。 - 前缀纪律必须在应用层守死。 一旦有代码图省事,在 A 机房写了个
b:*的 key,双向复制立刻把"让冲突不发生"的前提打破——两地可能同时改同一个 key,就回到了会丢更新的老问题。这条约束是软的(靠代码自觉),不是存储帮你强制的,review 时要盯紧。 - 工具本身要做 HA。
redis-shake这类同步进程自己也是单点,挂了复制就断,两地数据开始漂移。生产里它也得有监控和自动拉起。
那"真正的单 key 多地写"——同一个 key 两个机房都能改、系统自动合并——开源 Redis Cluster 做不到。开源的双向复制在遇到两地改同一 key 时是 last-write-wins(按到达顺序覆盖),并发更新会丢。要自动合并,得上 CRDT(Conflict-free Replicated Data Type,无冲突复制数据类型):底层数据类型自带合并语义(计数器两地各加、集合两地各插,复制时用向量时钟自动收敛),目前是 Redis Enterprise / Redis Cloud / Azure Managed Redis 的能力,托管侧 AWS MemoryDB 也专门定位多区 active-active CRDT。但注意:CRDT 的"自动合并"只对计数、集合这类可交换操作成立,它解决的是"不丢更新",不是"防超卖"——扣减型数据的强一致,CRDT 也救不了。
换 Valkey 有什么不同
既然聊到开源,绕不开 Valkey——2024 年 3 月 Redis 改成源可见许可(SSPL)后,社区(AWS、Google、Oracle、阿里、Ericsson、华为、腾讯等)从 Redis 7.2.4 fork 出来、放进 Linux Foundation、保持 BSD 许可的那个分支。它现在是多数云厂商的默认开源 Redis 引擎。
就异地双活这件事而言,结论很干脆:Valkey 在跨机房拓扑上和开源 Redis 没有本质区别,上面三种拓扑、双向复制的拼法、key 前缀分区的约束,原封不动适用。 原因是它从 7.2.4 分叉,核心复制机制(REPLICAOF、psync、16384 槽的 Cluster 模式、异步主从)是同一套,redis-shake 这类工具也兼容。
但有几点差异值得知道:
- 许可是最大的实际差异。 Valkey 是 BSD 3-Clause(宽松、可商用、无 copyleft),Redis 8 改成了 AGPLv3/RSALv2/SSPL 三选一的 tri-license——其中 AGPLv3 带网络 copyleft 义务(改了源码并对外提供网络服务,通常要求公开改动)。做音视频这种对外服务,这条可能直接影响选型,而且它和技术无关,是法务问题。
- active-active CRDT 两边开源都没有。 想要前面说的"单 key 多地写自动合并",开源 Redis 和开源 Valkey 都不提供,都得走商业版/托管版。Valkey 把 CRDT-based active-active 放进了 roadmap(社区资料提到 9.x 方向),但截至写稿它还不是开源可用的生产能力,别按"Valkey 免费版就能 CRDT 双活"来规划。
- 跨区部署方式一致。 Valkey 跨区同样是
REPLICAOF起只读副本(active-passive)+ 应用层写路由,想双活就自己拼双向复制。托管场景另说(比如 AWS 把 CRDT active-active 放在 MemoryDB,不是普通 Valkey)。
一句话:在异地双活这层,Valkey 对开源 Redis 是"平替",技术选型逻辑完全照搬;真正会让你改决定的是许可证,不是复制能力。
其余三类数据,快速归位
Redis 讲透了,其他三类用同一套逻辑一句话定位,不再展开。
扣减层:Redis 的雷区,NewSQL 的主场。 余额、并发额度这类"减下去不能超"的数据,直接用 Redis 跨机房多写会超卖(两地各扣各的)。想在 Redis 上做强一致扣减要上 Redlock 或 WAIT,那笔 RTT 的税照样回来,还多了自己维护锁正确性的风险。真正的好归宿是 NewSQL(TiDB、CockroachDB):底层 Raft/Paxos 多副本,写事务多数派确认才提交,跨机房强一致是内建的,省掉你在 MySQL 上纠结半同步/MGR/分片。代价是写延迟被共识放大、运维更重。小规模业务,上一篇的 MySQL 半同步主从反而更省心——别为了一天几千次扣减扛一套 NewSQL。
追加层:Cassandra 的主场。 CDR、通话日志、事件流这类"只往后加、不改旧行"的数据,量通常最大。Cassandra 多机房对等写、天生无主(A 写 A 的话单、B 写 B 的,靠带时间的分区键天然不冲突),写用 LOCAL_QUORUM(本机房多数派就返回、不跨机房等),LSM 引擎吃海量写入、加机器线性扩。边界:它不是关系库,别拿它做复杂 JOIN、事务、强一致读——用对了是神器,当主业务库是灾难。
协调层:etcd 不是业务库,是裁判。 "谁是全局唯一写入点?分布式锁谁发?配置怎么一致下发?"这些元数据协调问题,Redis 和 MySQL 都不擅长。etcd 底层 Raft、天生线性一致,专门存"谁是主""锁在谁手上""配置版本几"这类必须绝对一致但量很小的元信息——前面 failover 里"独立仲裁确认 A 真挂了"的那个裁判,就是它的活。边界:不扛高吞吐、不存大 value,别把业务数据往里塞。
别选"一个库",选"一套组合"
三步走完,真实的异地双活从来不是"用 Redis 还是用 MySQL"的单选题,而是一套分工:
| 数据类型 | 一致性诉求 | 容灾档位 | 首选存储 | 次选 / 备注 |
|---|---|---|---|---|
| 信令 / 会话 | AP,可短暂不一致 | ②主备异步 | Redis | 内存快 + TTL 对齐 SIP 租期,少有的换库更优 |
| 扣减型(余额/额度) | CP,防超卖 | ⑤强一致 | NewSQL(TiDB/CockroachDB) | 小规模用 MySQL 半同步主从更省心;别用 Redis 裸多写 |
| 追加型(CDR/日志) | AP,最终一致 | ④双活 | Cassandra | 多机房对等写 + LOCAL_QUORUM,吃下最大数据量 |
| 协调 / 元数据(选主/锁/配置) | CP,量小但必须绝对一致 | ⑤强一致 | etcd | 裁判不是球员,别塞业务数据 |
这张表才是全文的落地产出。读它的正确方式不是"哪个库赢了",而是:
每一类数据,先定它的容灾档位,再选一个把那种一致性做到极致的库;别指望一个库通吃四类。 想用一个库(无论 MySQL 还是 Redis)伺候全部四类,结果一定是:在它不擅长的那几类上,你要么牺牲正确性,要么手搓一堆它本来就没有的能力。
回到最初那个问题——"不用 MySQL,换 Redis 行不行":
- 信令/会话层,换 Redis 确实更好,这一层 MySQL 本来就不该上。
- 扣减层,换 Redis 是埋雷,要换就换成 NewSQL(真·升级),或者老老实实 MySQL + etcd 选主。
- 追加层,MySQL 和 Redis 都不是最优,Cassandra 这类才是。
- 协调层,谁都替代不了 etcd。
所以"换不换 MySQL"是个伪问题。对的问法是:我这四类数据,每一类的容灾要做到什么程度,该放进哪个最懂它的库。
总结:顺序是"容灾 → 双活 → 选库",不是反过来
全文就想把一个被问反了的顺序掰正:先定容灾目标(RTO/RPO),再决定要不要双活、怎么分层,最后才选存储。 一上来就纠结"用什么库",是把最后一步当成了第一步。
三步连起来:
- 容灾:两把尺子(RPO 丢多少、RTO 停多久)+ 五档做法(冷备份→主备异步→半同步→双活→多活),按业务容忍度选够用那一档。
- 双活:它只是梯度里偏贵的一档,难点不在选库,在把数据按一致性分成四类、各定各的档——因为强一致写绕不过 RTT,不能让所有数据都强一致。
- 选库:每类数据配最懂它的存储。以 Redis 为例,它是信令层的主场,但跨机房要靠双集群复制(单向=主备、双向+前缀=务实双活),且无论怎么配都扛不了扣减型的强一致——那是 NewSQL 的活。
一句话:换存储永远绕不过一致性约束,光速收的税换哪个库都得交;你能选的只有"在哪一层交、交给谁"。 下次有人跟你安利"我们用 XX 库做异地双活,又快又一致",你可以反问一句:你的扣减型数据,是真强一致,还是把超卖风险藏在了异步复制里?
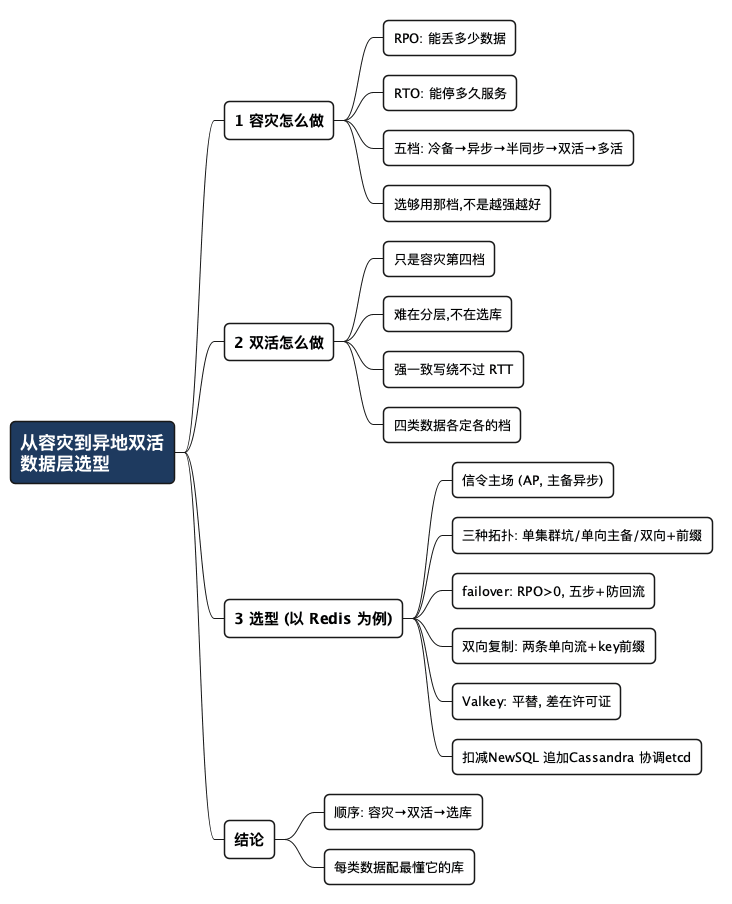
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* 从容灾到异地双活\n数据层选型
** 1 容灾怎么做
*** RPO: 能丢多少数据
*** RTO: 能停多久服务
*** 五档: 冷备→异步→半同步→双活→多活
*** 选够用那档,不是越强越好
** 2 双活怎么做
*** 只是容灾第④档
*** 难在分层,不在选库
*** 强一致写绕不过 RTT
*** 四类数据各定各的档
** 3 选型 (以 Redis 为例)
*** 信令主场 (AP, 主备异步)
*** 三种拓扑: 单集群坑/单向主备/双向+前缀
*** failover: RPO>0, 五步+防回流
*** 双向复制: 两条单向流+key前缀
*** Valkey: 平替, 差在许可证
*** 扣减→NewSQL 追加→Cassandra 协调→etcd
** 结论
*** 顺序: 容灾→双活→选库
*** 每类数据配最懂它的库
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。
tech redis valkey newsql tidb etcd cassandra mysql architecture high-availability disaster-recovery cap