DNS,有多少问题因你而起
Posted on 六 03 10月 2026 in Tech
| Abstract | DNS,有多少问题因你而起 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-10-03 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 三次断网:AWS、Facebook、Dyn,DNS 分别是坏记录、失联服务和攻击目标
- 为什么总是它:DNS 是共享依赖,结果被层层缓存,错误容易被误读
- 缓存与 TTL:命中率的甜头和更新滞后的苦头,是同一件事的两面
- 负缓存:RFC 2308 把“不存在”也缓存起来,SOA 的 TTL 与 MINIMUM 一起决定上限
- 失败缓存:RFC 9520 给 SERVFAIL 之类的失败定了缓存上下限,堵住重试风暴
- serve-stale:RFC 8767 允许在拉不到权威时用过期数据兜底
- libcurl 排障:量出解析耗时,用
--resolve验证问题在哪一层 - 应用层兜底:先复用 handle;确有短暂 DNS 故障时,限时试一次上次连通的 IP,附可运行 C 示例
- 常见陷阱:TTL 拍脑袋、单一 provider、健康检查联动、本地 resolver 玄学
- 排障清单:一份可以贴在墙上的 dig 顺序和最佳实践
凡是做过几年后端或运维的人,多半有过这样一个深夜:监控红成一片,日志里全是 connection timeout,你顺着调用链一路往下扒,最后卡在一个再普通不过的地方——某个域名解析不出来了。你盯着 dig 的输出,SERVFAIL,或者干脆超时,脑子里只有一句话:不是刚刚还好好的吗?
DNS 就是这么个东西。RFC 1034/1035 在 1987 年发表,比今天绝大多数程序员的工龄都长。它平时安静地工作,出事时却会让一排业务同时报警。越像空气的依赖,越容易在演练清单里被漏掉。
三次公开事故里,DNS 有时是症状,有时是直接受害者。它们共同提醒我们:别把“解析失败”当成诊断结论。 先查坏在权威、递归缓存还是应用,再谈 TTL 和容灾。后面给后端和运维工程师一套能照着执行的检查顺序。
三次断网:DNS 在不同位置出事
三份公开复盘,分别对应坏记录、权威服务失联和权威服务遭攻击。
AWS DynamoDB,2025 年 10 月 19 日,US-EAST-1。 故障起于自动管理 DNS 记录的系统里的竞态。DNS Planner 生成更新计划,DNS Enactor 把计划应用到 Route 53。一个 Enactor 执行得太慢,另一个已经应用更新的计划并清理旧计划;迟到者却又把旧计划写回去。它启动时检查过版本,真正写入时却没有重新检查。结果:区域端点的 DNS 记录变成空记录。 DynamoDB 连接失败,又波及依赖它的服务。
在这次事故里,DNS 记录是故障落点,根因是更新逻辑里的竞态。
Facebook,2021 年 10 月 4 日。 一条例行维护命令本想评估骨干网容量,却切断了数据中心之间的连接;本该拦截它的审计工具因为 bug 没拦住。
接下来是 DNS 最容易被忽略的联动:权威 DNS 节点检测到自己连不上数据中心,便撤回 BGP 路由通告。服务器还在,外界却到不了。排障工具也依赖这套 DNS,工程师只好到现场恢复骨干网。
Dyn,2016 年 10 月 21 日。 这次 DNS 本身就是攻击目标。Mirai 僵尸网络对托管 DNS 服务商 Dyn 发起 DDoS,部分客户的域名解析受到影响。Dyn 的事后分析还提到,递归 DNS 的重试流量叠加在攻击流量上,进一步加重了冲击。
三次事故,三种形态:记录被写坏、服务器够不着、服务商遭攻击。 所以看到 SERVFAIL,先别急着宣布“DNS 挂了”:它只告诉你解析没成功,还没告诉你坏在哪一层。
为什么总是它
同样是基础设施,为什么 DNS 出的名比数据库、比消息队列都响?三个结构性原因。
它是共享依赖,而且藏得很深。 微服务、第三方 API、数据库连接都可能先用域名找地址。解析器、权威服务或某个关键域名一旦出问题,多个业务会同时报警,看上去像一排服务各自坏了。
它的结果被层层缓存。 应用、操作系统或本地代理、递归解析器都可能留着答案,具体取决于客户端和部署环境;权威服务器则提供原始记录。缓存让查询快,也意味着改一条记录不会立刻生效,坏一条记录也不会立刻消失。你改好了权威记录,业务进程可能还握着旧地址。
它的失败信号容易被误读。 NXDOMAIN 表示域名不存在,SERVFAIL 表示这次解析没有完成;两者都可能在递归解析器里缓存,但规则不同。一个“很快返回”的错误,未必来自刚刚发起的上游查询。
排障要抓住三个机制:缓存怎么算、失败怎么缓存、拉不到新答案时怎么兜底。
缓存与 TTL:甜头和苦头是同一件事
TTL(Time To Live)是每条 DNS 记录自带的一个数字,单位是秒,意思是"这条记录你最多缓存这么久,到点必须重新去问"。它是 DNS 里最简单、也最容易被拍脑袋定错的一个值。
RFC 8767 顺手把 TTL 的语义收紧了一下,值得记住两条:TTL 是个 32 位无符号整数,建议上限 604800 秒(7 天);TTL 为 0 表示"只用于当前这一次事务,不许缓存"。
真正的取舍在这里:
| TTL 设置 | 好处 | 代价 |
|---|---|---|
| 长(比如 24 小时) | 缓存命中率高,权威服务器压力小,扛 DDoS 更从容 | 改记录、切故障要等很久才全网生效 |
| 短(比如 30 秒) | 切换灵敏,故障转移快 | 缓存命中率低,权威服务器压力大,一旦权威挂了受影响更快 |
Dyn 事故说明一个容易忽视的取舍:权威不可用时,短 TTL 的旧答案会更早过期;长 TTL 的缓存还能撑一阵,但也会拖慢正常的地址切换。这是机制上的权衡,不能只凭 TTL 长短断言某家公司在那次事故里受损多少。
所以别问“TTL 设多少最好”。先看记录变更频率、故障切换目标和权威承载能力;真要靠改记录切流量,就提前降低 TTL,并等旧缓存自然过期后再切。TTL 只约束遵守它的缓存,不能保证所有客户端准点换地址。
还有一层经常被漏掉:libcurl 的 DNS 缓存不读取记录本身的 TTL。 它默认把解析结果缓存 60 秒,CURLOPT_DNS_CACHE_TIMEOUT 控制的是这层缓存的时长;即使权威记录只给了 10 秒,也不意味着 libcurl 会在第 11 秒重查。更别忘了复用中的 TCP 连接:只要连接还可用,请求可能根本不需要重新解析。排障时先确认程序的解析器后端、DNS 缓存和连接复用行为,别拿 dig 的 TTL 直接推断应用何时切换 IP。见 libcurl DNS 缓存文档和连接复用说明。
负缓存:连"不存在"都要缓存起来
这是最容易被忽略、又最容易出诡异 bug 的一块。
假设一个域名查出来是 NXDOMAIN——不存在。resolver 会不会记住这个"不存在"?会。这就是负缓存(negative caching),由 RFC 2308 规定。它的动机很实在:如果不缓存否定答案,一个被大量请求的、恰好不存在的域名,会让每次查询都一路打到权威服务器,白白挨一遍全链路。
问题是“不存在”这条信息里没有普通记录,TTL 挂在哪?RFC 2308 的办法是:权威服务器把 SOA 放进否定回答,TTL 取 SOA 的 MINIMUM 字段与 SOA 自身 TTL 的较小值。 递归解析器还可能设置自己的缓存上限,所以 MINIMUM 不是唯一开关。
RFC 2308 还顺手废掉了 SOA MINIMUM 早年三种混乱含义中的两种,明确它现在只有一个意思:负缓存的 TTL。同时给了实操建议——负缓存时长应不超过正常答案的缓存时长,1 到 3 小时是个好默认值,超过一天容易惹事(协议本身允许缓存长达 68 年,这显然不能当真)。
这块的经典陷阱是这样的:你新上线一个子域,比如 api-v2.example.com,DNS 记录还没配好就有人(或者你自己的健康检查)去访问了一下,拿回一个 NXDOMAIN。这个否定答案被缓存了。等你几分钟后把记录配好,一部分用户在负缓存过期前,依然被告知这个域名不存在。权威已经正确,递归解析器却还握着之前的负回答。
一句话记住:先配好记录,再让任何东西去碰它。 顺序反了,负缓存会替你把"不存在"这个谎言维持一段时间。
失败缓存:给 SERVFAIL 上下限,堵住重试风暴
RFC 2308 管的是"域名确定不存在"这种否定答案。但还有一类更麻烦的东西:解析失败——比如 SERVFAIL,意思不是"不存在",而是"我这次没能解析出来"。可能是权威服务器超时,可能是网络抽风,可能是 DNSSEC 校验没过。
这类失败缓存太短,持续失败会引发重复查询;缓存太长,权威已经恢复,客户端还在看到旧错误。
RFC 9520(2023 年)给解析失败缓存定了明确的上下限:
- 必须(MUST)缓存解析失败至少 1 秒——目的是消灭那种同一个失败被瞬间重试成千上万次的风暴。
- 缓存时长不得(MUST NOT)超过 5 分钟——和 RFC 2308 保持一致,避免一次抖动被记太久。
- 命中失败缓存期间,resolver 不得再对同一目标发起对应的上游查询。
- 建议对持续失败采用指数或线性退避,逐步拉长缓存时长。
业务侧要记住:权威恢复后,递归解析器可能暂时继续返回失败。但“最多缓存 5 分钟”不等于业务必在 5 分钟内恢复;持续失败、其他缓存、连接或应用层重试都可能继续影响结果。先看权威与递归解析器的回答是否一致,再决定要不要动业务配置。
三个 RFC 放一起,一张表看清各自管什么:
| RFC | 管什么 | 关键数字 | 你会在哪撞上它 |
|---|---|---|---|
| RFC 2308 | 否定答案(NXDOMAIN/NODATA)的负缓存 | 由 SOA TTL 与 MINIMUM 中较小者决定;解析器可再设上限 | 新记录配好前被访问过,“不存在”被缓存 |
| RFC 9520 | 解析失败(SERVFAIL 等)的失败缓存 | 至少 1 秒,最多 5 分钟 | 域名恢复了但服务还卡一阵才认 |
| RFC 8767 | 权威够不着时用过期数据兜底 | stale 记录回给客户端时 TTL 建议 30 秒;stale 保留建议 1–3 天 | 权威挂了但你的服务没跟着一起挂 |
serve-stale:拉不到权威时,用过期数据兜底
TTL 到点需要重新确认,但遇到权威不可达,还能不能用旧答案?RFC 8767 给出一个有条件的办法:serve-stale(提供过期数据)。
它的立论特别朴素,用了个比喻:"过期的面包也比没面包强"(stale bread is better than no bread)。 观察到的现象是:权威服务器够不着(被 DDoS、网络断、机房挂)时,往往数据本身根本没变——变的只是"你暂时问不到"。这种时候还死守 TTL、给客户端回 SERVFAIL,等于因为"没法确认这条还对不对"就把一条大概率还对的记录扔了。
RFC 8767 允许递归解析器在无法及时刷新时,用已经过期的缓存数据应答。几个关键约束值得记:
- 先尝试刷新;如果新答案没能及时取得,才考虑用旧数据应答,并继续后台刷新。不能一见过期就直接返回旧值。
- 回给客户端的过期记录,TTL 必须大于 0,建议设成 30 秒——既避免客户端反复穿透,又对遵守 TTL 的下游 resolver 起到限流作用。
- 有一套定时器兜底:客户端响应定时器(建议 1.8 秒,卡在常见 2 秒超时之下)、查询解析定时器、失败重查定时器(对挂掉的权威建议不超过每 30 秒重试一次)、最大 stale 保留时长(建议 1–3 天)。
- 权威返回带 AA 标志的
NOERROR或NXDOMAIN时,视为成功刷新;其他响应码通常不应覆盖原有状态。
落到实现上,BIND 可用 stale-cache-enable、stale-answer-enable 等选项,Unbound 有 serve-expired 系列配置。具体默认值和行为要查正在运行的版本;开启前先确认旧地址失效时的风险,并演练权威不可达及恢复两个阶段。BIND 配置参考
放到 Dyn 那种场景,已有缓存、记录未变、递归解析器支持并启用了 serve-stale 时,旧答案有机会继续服务。首次查询、记录确实已变或客户端绕过该递归解析器时,它帮不上忙。
回到业务进程:用 curl 把问题分层
dig 能问递归或权威解析器,却不能证明业务进程拿到什么。参考 libcurl 的排障办法,先在与业务相同的容器或主机上测一次请求,把各阶段累计耗时打印出来:
curl --noproxy '*' --connect-timeout 3 --max-time 8 -sS -o /dev/null \
  -w 'resolve=%{time_namelookup}s connect=%{time_connect}s tls=%{time_appconnect}s total=%{time_total}s ip=%{remote_ip}\n' \
  https://example.com/
time_namelookup 是从请求开始到名字解析完成的时间,time_connect 和 time_appconnect 也是累计时间,不能直接把三列相加。解析失败时别把这些数字当作一次成功 DNS 查询的耗时;先看 curl 错误,再对照 dig。这里用 --noproxy '*' 排除代理影响;如果业务本来经代理访问,还要按实际代理路径再测一遍。连接复用或缓存命中时,解析耗时可能很小,不能据此断定权威服务器很快。curl --write-out 字段说明
若 dig 有正确地址,curl 仍然失败,用一个已核实属于目标服务的 IP 做对照:
# 192.0.2.10 是文档示例地址;执行前换成目标服务确认过的 IP
curl --noproxy '*' --connect-timeout 3 --max-time 8 -v \
  --resolve example.com:443:192.0.2.10 https://example.com/
--resolve 只为这次 curl 请求指定地址,URL 中的主机名仍用于 HTTPS 证书校验和 HTTP 请求。若指定 IP 后请求成功,说明排查应集中在解析路径或缓存;若仍失败,就继续查目标 IP、网络、TLS 和服务端。这个命令是诊断工具,不要把临时 IP 长期写死,更不要用 -k 跳过证书校验来制造“成功”。curl --resolve 文档
若怀疑双栈,分别试 curl -4 和 curl -6,并分别查 A、AAAA 记录。若写 libcurl 程序,再检查所用版本与 resolver 后端:系统同步解析、线程解析和 c-ares 的超时行为不同;CURLOPT_CONNECTTIMEOUT 限制的是整个连接阶段,不是单独的 DNS 计时器。libcurl 解析器说明、连接超时说明
libcurl 调 API:先复用,再谈旧 IP 兜底
有人问:既然 DNS 会故障,要不要在应用里保存“上次成功解析的 IP”?先别加第二套缓存。 串行请求复用同一个 easy handle,并发请求把 easy handle 放进同一个 multi handle。这样 libcurl 才有机会复用连接和 DNS 缓存;每次请求都 curl_easy_init()、完成就 curl_easy_cleanup(),相当于每次都把这些状态扔掉。一个 easy handle 不能同时给多个线程用。确实需要跨线程共享 DNS 缓存时,可用 share interface,但必须提供锁回调。libcurl 缓存说明、线程规则
如果已有故障记录证明“递归解析暂时失败,但上次连接的 IP 仍能服务”,才考虑应用层兜底。它更像一张有过期时间的备用地址卡,不是新的常规解析器。下面的流程只适合固定域名、直连、HTTPS、无跨域重定向的 API:
- 正常请求成功,且 HTTP 状态符合业务预期后,用
CURLINFO_PRIMARY_IP记录实际连接的 IP、目标域名与端口、成功时间。它不是完整的 DNS 结果;经代理访问时,拿到的还可能是代理 IP,所以代理请求不能照搬这套办法。API 说明 - 正常请求解析失败时,先判断是否是暂时的解析故障,例如同一环境的递归解析器返回
SERVFAIL或超时。CURLE_COULDNT_RESOLVE_HOST只说“没有解析出主机”,不足以区分临时故障和域名确实不存在;NXDOMAIN不应触发旧 IP 兜底,也别把普通请求超时一概算作 DNS 故障。如果没有可靠办法区分,宁可不用这层兜底。libcurl 错误码 - 若备用地址仍在短期限内,创建临时 easy handle,保留原 URL、HTTP 方法与请求体、认证、请求超时和 HTTPS 证书校验,用
CURLOPT_RESOLVE把这个域名和端口指向已记录的 IP,只重试一次。临时 handle 不加入原 multi,也不使用共享 DNS 缓存的 share handle;完成后销毁它,下一次请求仍走正常解析。CURLOPT_RESOLVE会写入 handle 的 DNS 缓存,直接在常用 handle 上设置,容易把旧地址留在正常路径里。CURLOPT_RESOLVE文档 - 备用地址的期限从最后一次正常请求成功开始算。兜底成功也不续期;旧 IP 失效就快速失败,不能一直循环。改数据的 HTTP API 还要沿用业务自己的幂等键,避免重试造成重复操作。
期限没有通用值。可以先用 120 秒作演练参数,再按服务商的地址变更频率和故障记录调整;如果地址经常变、使用 CDN 或代理,这条路多半不划算,优先评估递归解析器的 serve-stale。上线前至少演练四种情况:SERVFAIL 且旧 IP 可达、旧 IP 已失效、NXDOMAIN、DNS 恢复。期望分别是兜底一次、快速失败、不兜底、回到正常解析。日志只记故障类型、是否兜底和地址年龄,不记 URL 中的令牌或响应内容。
下面是一份适用于 macOS/Linux 的可运行 C 示例。它只请求固定的 https://example.com/,不使用代理、不跟随重定向,避免拿到代理或别的域名的 IP。--transient-confirmed 代表运维或监控已确认同一解析路径暂时返回 SERVFAIL / 超时;代码不会从 libcurl 错误码猜测 DNS 响应码。没有这个确认,即使 libcurl 返回错误码 6,也不会启用旧 IP。curl_easy_duphandle 的状态隔离说明
#define _POSIX_C_SOURCE 200809L
#include <arpa/inet.h>
#include <assert.h>
#include <stdint.h>
#include <stdio.h>
#include <string.h>
#include <time.h>
#include <curl/curl.h>

#define HOST "example.com"
#define URL "https://example.com/"
#define STALE_MAX_SECONDS 120

typedef struct {
    char ip[INET6_ADDRSTRLEN];
    time_t seen;
    int valid;
} last_good_t;

static size_t discard_body(char *data, size_t size, size_t count, void *unused) {
    (void)data;
    (void)unused;
    if (size && count > SIZE_MAX / size) return 0;
    return size * count;
}

static int monotonic_seconds(time_t *out) {
    struct timespec ts;
    if (clock_gettime(CLOCK_MONOTONIC, &ts) != 0) return 0;
    *out = ts.tv_sec;
    return 1;
}

static int numeric_ip(const char *ip) {
    struct in_addr v4;
    struct in6_addr v6;
    return inet_pton(AF_INET, ip, &v4) == 1 ||
           inet_pton(AF_INET6, ip, &v6) == 1;
}

static CURLcode configure(CURL *curl) {
    CURLcode rc;
    if ((rc = curl_easy_setopt(curl, CURLOPT_URL, URL)) != CURLE_OK) return rc;
    if ((rc = curl_easy_setopt(curl, CURLOPT_NOPROXY, "*")) != CURLE_OK) return rc;
    if ((rc = curl_easy_setopt(curl, CURLOPT_FOLLOWLOCATION, 0L)) != CURLE_OK) return rc;
    if ((rc = curl_easy_setopt(curl, CURLOPT_CONNECTTIMEOUT_MS, 2000L)) != CURLE_OK) return rc;
    if ((rc = curl_easy_setopt(curl, CURLOPT_TIMEOUT_MS, 5000L)) != CURLE_OK) return rc;
    if ((rc = curl_easy_setopt(curl, CURLOPT_SSL_VERIFYPEER, 1L)) != CURLE_OK) return rc;
    if ((rc = curl_easy_setopt(curl, CURLOPT_SSL_VERIFYHOST, 2L)) != CURLE_OK) return rc;
    return curl_easy_setopt(curl, CURLOPT_WRITEFUNCTION, discard_body);
}

static int http_ok(CURL *curl) {
    long status = 0;
    return curl_easy_getinfo(curl, CURLINFO_RESPONSE_CODE, &status) == CURLE_OK &&
           status >= 200 && status < 300;
}

static void remember_ip(CURL *curl, last_good_t *last) {
    char *ip = NULL;
    time_t now;
    if (curl_easy_getinfo(curl, CURLINFO_PRIMARY_IP, &ip) != CURLE_OK ||
        !ip || !numeric_ip(ip) || strlen(ip) >= sizeof(last->ip) ||
        !monotonic_seconds(&now)) return;
    memcpy(last->ip, ip, strlen(ip) + 1); /* libcurl 的指针在下次请求后可能失效 */
    last->seen = now;
    last->valid = 1;
}

static int may_fallback(CURLcode rc, int transient_confirmed,
                        const last_good_t *last, time_t now) {
    return rc == CURLE_COULDNT_RESOLVE_HOST && transient_confirmed &&
           last->valid && now >= last->seen &&
           now - last->seen < STALE_MAX_SECONDS;
}

static int try_last_ip(CURL *normal, const char *ip) {
    char mapping[128];
    int n = snprintf(mapping, sizeof(mapping),
                     strchr(ip, ':') ? HOST ":443:[%s]" : HOST ":443:%s", ip);
    if (n < 0 || (size_t)n >= sizeof(mapping)) return 0;

    CURL *temporary = curl_easy_duphandle(normal);
    if (!temporary) return 0; /* duplicate 不继承连接、DNS 缓存和 share */
    struct curl_slist *addresses = curl_slist_append(NULL, mapping);
    int ok = 0;
    if (addresses &&
        curl_easy_setopt(temporary, CURLOPT_RESOLVE, addresses) == CURLE_OK &&
        curl_easy_perform(temporary) == CURLE_OK && http_ok(temporary)) {
        ok = 1;
    }
    curl_easy_cleanup(temporary); /* 旧 IP 不进入常用 handle 的缓存 */
    curl_slist_free_all(addresses);
    return ok;
}

static void self_test(void) {
    last_good_t last = {.seen = 100, .valid = 1};
    assert(may_fallback(CURLE_COULDNT_RESOLVE_HOST, 1, &last, 219));
    assert(!may_fallback(CURLE_COULDNT_RESOLVE_HOST, 1, &last, 220));
    assert(!may_fallback(CURLE_COULDNT_RESOLVE_HOST, 0, &last, 101));
    assert(!may_fallback(CURLE_OPERATION_TIMEDOUT, 1, &last, 101));
}

int main(int argc, char **argv) {
    const char *mode = argc == 2 ? argv[1] : "";
    if (argc > 2 || (argc == 2 && strcmp(mode, "--self-test") != 0 &&
        strcmp(mode, "--exercise-fallback") != 0 &&
        strcmp(mode, "--transient-confirmed") != 0)) {
        fputs("usage: dns_demo [--self-test|--exercise-fallback|--transient-confirmed]\n", stderr);
        return 2;
    }
    if (strcmp(mode, "--self-test") == 0) {
        self_test();
        puts("self-test OK");
        return 0;
    }

    CURLcode rc = curl_global_init(CURL_GLOBAL_DEFAULT);
    if (rc != CURLE_OK) return 1;
    CURL *normal = curl_easy_init();
    if (!normal) { curl_global_cleanup(); return 1; }
    rc = configure(normal);
    int exit_code = 0;
    last_good_t last = {0};
    if (rc != CURLE_OK) { exit_code = 1; goto done; }

    for (int i = 0; i < 2; ++i) { /* 同一 handle 连续调用两次 */
        rc = curl_easy_perform(normal);
        if (rc == CURLE_OK && http_ok(normal)) {
            remember_ip(normal, &last);
            puts("normal request OK");
            if (i == 0 && strcmp(mode, "--exercise-fallback") == 0) {
                if (!last.valid || !try_last_ip(normal, last.ip)) {
                    fputs("fallback exercise failed\n", stderr);
                    exit_code = 1;
                    break;
                }
                puts("fallback exercise OK");
            }
        } else {
            time_t now;
            if (monotonic_seconds(&now) &&
                may_fallback(rc, strcmp(mode, "--transient-confirmed") == 0,
                             &last, now) && try_last_ip(normal, last.ip)) {
                puts("temporary fallback OK");
            } else {
                if (rc == CURLE_OK) fputs("request failed: HTTP status is not 2xx\n", stderr);
                else fprintf(stderr, "request failed: %s\n", curl_easy_strerror(rc));
                exit_code = 1;
                break;
            }
        }
    }
done:
    curl_easy_cleanup(normal);
    curl_global_cleanup();
    return exit_code;
}
把代码保存为 dns_fallback_demo.c,用系统的 libcurl 开发包编译:
cc -std=c11 -Wall -Wextra -Werror -O2 dns_fallback_demo.c \
  -o dns_demo $(pkg-config --cflags --libs libcurl)
./dns_demo --self-test
./dns_demo
./dns_demo --exercise-fallback
--self-test 只检查触发条件,不访问网络;--exercise-fallback 先正常拿到 IP,再主动演练临时 handle 的 HTTPS 请求,并不模拟真正的 DNS 故障。--transient-confirmed 只在同一环境已确认临时 DNS 故障时使用。生产接入时把这个手动信号换成可信的故障判断,并给正常请求与兜底请求设一个共同的总时间预算。示例只用 GET;改成 POST 时需连同请求体、认证一起复制,并确保重试有幂等保护。
上线前复核:目标域名固定且直连,候选 IP 来自正常成功连接并经过格式检查;证书校验不关闭,凭证不写进代码或日志;限制旧 IP 年龄和重试次数,改数据的请求有幂等保护;演练 DNS 故障、旧 IP 失效与解析恢复。
常见陷阱:那些年我们踩过的 DNS 坑
把前面的原理翻译成一线最常撞的几个坑,对号入座:
- TTL 拍脑袋。 要么全站 30 秒图个"随时能切",把权威服务器和 resolver 压得喘不过气,遇到攻击第一个崩;要么全站一天,结果真出故障要切换时干等一天。正确姿势是按记录的稳定性分级设 TTL,别一刀切。
- 单一 DNS provider。 如果域名只依赖一家服务商,它就是集中风险。多服务商有成本,记录同步、DNSSEC、委派与故障切换都要一起设计;至少先确认现有服务商的故障域、恢复手段和演练记录。
- 健康检查和路由联动,没想清楚级联。 Facebook 那次的深层教训:一个"发现自己不健康就撤 BGP 路由"的自我保护逻辑,本意是好的,却在骨干网整体故障时把所有 DNS 节点一起从地图上抹掉,还顺带锁死了排障通道。任何"检测到异常就自动下线自己"的机制,都要问一句:如果所有节点同时判定自己异常,会发生什么?
- 改记录不留意生效顺序。 前面讲过的负缓存陷阱:先配好记录,再让健康检查、监控、用户去碰它。反过来就会把"不存在"缓存一段时间。
- 本地 resolver 玄学。 容器里的
/etc/resolv.conf、ndots和 search domain 会改变查询顺序。Kubernetes 常见的ndots:5可能让不带末尾点的外部域名先尝试搜索域,增加无用查询。先看实际配置和抓到的查询,别凭印象改全局参数。 - 把
NXDOMAIN和SERVFAIL当成一回事。 前者是"确定不存在"、会被负缓存;后者是"这次没解析出来"、走失败缓存。排障时先看清是哪个,方向完全不同。
排障清单:一份可以贴在墙上的顺序
DNS 出问题时,最忌讳的是没头绪地乱试。按这个顺序走,基本能快速定位到是哪一层的问题。
-
记录业务侧的错误。 在出问题的容器里执行上一节的 curl 命令,记下错误码、连接 IP 和分段耗时。
dig成功而业务失败,仍可能是应用 DNS 缓存、连接复用、代理或不同 resolver 后端,不能直接排除 DNS。 -
比较递归与权威的答案。
dig api.example.com A保留状态码与 TTL;找出权威 NS 后,把命令中的权威服务器IP换成实际地址,用dig @权威服务器IP api.example.com A +norecurse对比,AAAA 也查一次。答案不一致可能是缓存,也可能是不同权威节点数据不一致、委派或 DNSSEC 问题,继续查每台权威,不要直接清缓存。 -
分清
NXDOMAIN、NODATA 和SERVFAIL。NXDOMAIN是名字不存在;NODATA 是名字存在、所查类型没有记录;SERVFAIL是解析未完成。前两者查记录与负缓存,后者查权威可达性、DNSSEC 和失败缓存。别把 RFC 9520 的 5 分钟缓存上限误当恢复承诺。 -
查 SOA 和负回答。
dig example.com SOA看 SOA 的 TTL 与最后一个 MINIMUM 字段;若已有失败样本,再看它的负回答中 authority section 的 SOA 剩余 TTL。不要为了测试而批量制造不存在的生产域名查询。 -
多个 resolver 交叉验证。
dig @8.8.8.8 api.example.com A、dig @1.1.1.1 api.example.com A分别问一遍。若只有公司内网的解析器返回错误,优先查内网解析路径;若公共解析器也错,再与权威答案对比。 -
回到应用那层。 看
/etc/resolv.conf、容器 DNS 配置、ndots、代理、libcurl 的 DNS 缓存和连接复用。最后用--resolve做一次受控对照,并保留原始错误与时间线。
一句话总结这份清单:
从业务报错出发,逐层对比答案。 应用、递归、权威三层哪一层开始不一致,排查范围就缩到哪里。
总结:把“解析失败”拆成可以验证的问题
AWS、Facebook、Dyn 提醒我们:同样一条“解析失败”,可能来自写坏的记录、撤掉的路由,也可能来自正在被攻击的权威服务。值班时最有用的动作,是把它拆成能比较的三份答案:应用看到什么、递归解析器返回什么、权威记录是什么。
- TTL 按记录稳定性分级设,别一刀切,想清楚你是要命中率还是要故障转移的灵敏。
- 评估 DNS provider 的故障域,需要多家时先解决记录同步与切换演练。
- 按业务能否容忍旧地址决定是否开 serve-stale,测试权威故障与恢复两种状态。
- 区分负缓存和失败缓存,发布新域名前先配记录,恢复时核对每层的剩余 TTL。
- 在业务环境跑 curl 对照,必要时用
--resolve验证解析路径,不把dig的结果当应用的结果。 - 调用 API 先复用 libcurl handle;只有确认短暂 DNS 故障且旧 IP 仍可用,才考虑限时、单次的应用层兜底。
下次值班再看到 SERVFAIL,先把这三份答案记下来。比盯着同一条错误日志多看十分钟管用。
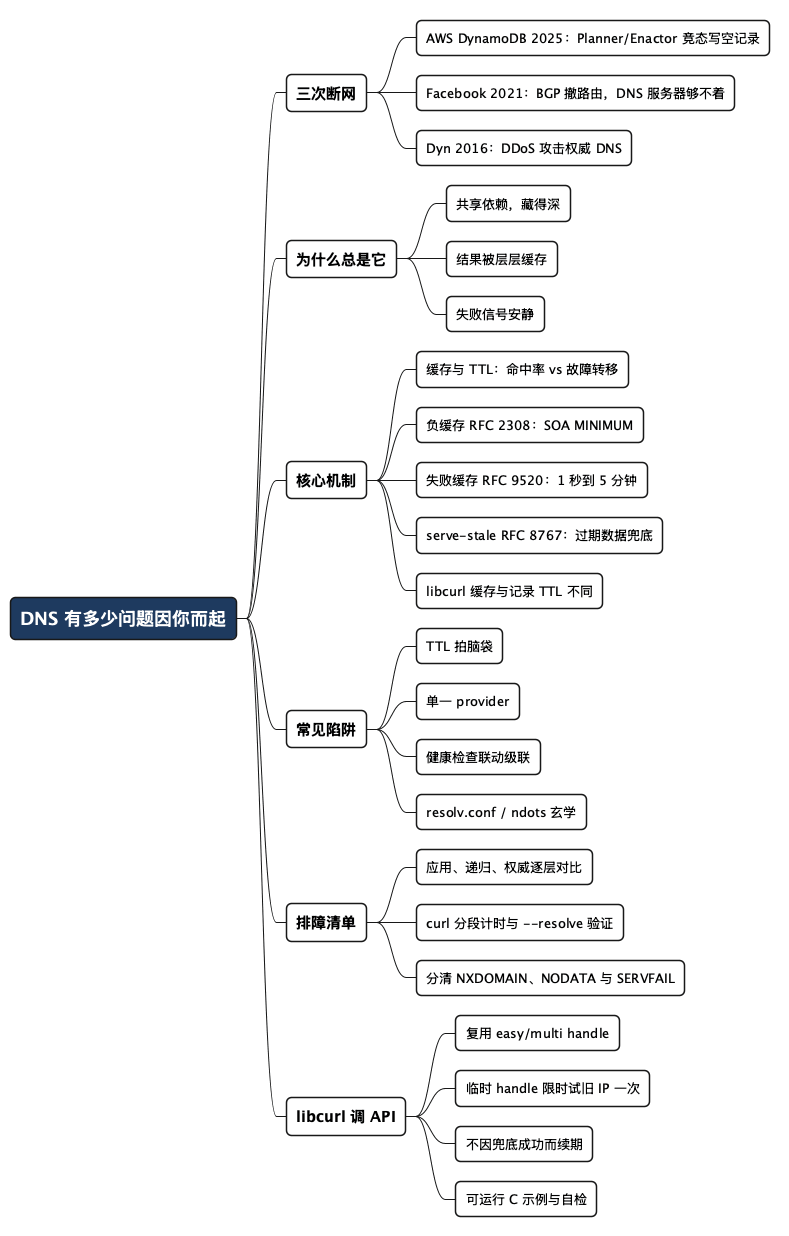
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* DNS 有多少问题因你而起
** 三次断网
*** AWS DynamoDB 2025:Planner/Enactor 竞态写空记录
*** Facebook 2021:BGP 撤路由,DNS 服务器够不着
*** Dyn 2016:DDoS 攻击权威 DNS
** 为什么总是它
*** 共享依赖,藏得深
*** 结果被层层缓存
*** 失败信号安静
** 核心机制
*** 缓存与 TTL:命中率 vs 故障转移
*** 负缓存 RFC 2308:SOA MINIMUM
*** 失败缓存 RFC 9520:1 秒到 5 分钟
*** serve-stale RFC 8767:过期数据兜底
*** libcurl 缓存与记录 TTL 不同
** 常见陷阱
*** TTL 拍脑袋
*** 单一 provider
*** 健康检查联动级联
*** resolv.conf / ndots 玄学
** 排障清单
*** 应用、递归、权威逐层对比
*** curl 分段计时与 --resolve 验证
*** 分清 NXDOMAIN、NODATA 与 SERVFAIL
** libcurl 调 API
*** 复用 easy/multi handle
*** 临时 handle 限时试旧 IP 一次
*** 不因兜底成功而续期
*** 可运行 C 示例与自检
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。