如何避免代码里的霰弹式修改
Posted on in Tech
| Abstract | 如何避免代码里的霰弹式修改 |
|---|---|
| Authors | Walter Fan |
| Category | Tech |
| Version | v1.0 |
| Updated | 2026-10-27 |
| License | CC-BY-NC-ND 4.0 |
大纲
展开看看
- 一句话:霰弹式修改的根因不是代码多,而是"一个概念的知识被复制到了很多地方"。治理目标不是让代码只出现一次,而是让一个变化原因只有一个主要修改点
- 什么是霰弹式修改:改一条权限规则,要同时动十几个文件,还经常 A 改了、C 忘了、D 改错了,同一条规则在不同地方表现不一致
- 把"变化"集中起来:把到处出现的
if role == ...收进一个CanManageCall(user),从 N 个修改点变成 1 个 - 别看到重复就抽象:判断标准不是"代码是不是重复",而是"它们是不是因为同一个业务原因而变化"。这比 DRY 更重要
- 用"变化原因"划分代码:规则散落在 handler / service / DAO / job / CLI,改一次全得动,这才是霰弹;把规则收进领域服务,外围只负责调用
- 霰弹式修改通常是知识泄漏:问题不是重复,是系统里有好几个地方"知道"同一条业务规则。重构要问的是"这个知识该归谁拥有"
- 先做 Change Map 再动手:接手大项目别一上来就重构,先搜出一条需求要改哪些地方,判断这些修改是合理分层还是霰弹
- 重构目标量化成 N→1:改一个业务规则从要动 12 个文件,变成改 1 个核心实现、测试覆盖其余调用者
- 改很多层不一定是坏事:真正的分层需求穿透各层是正常的,霰弹指的是"同一层的很多无关地方重复出现同一个判断"
- 建立变化边界:频繁变化的业务规则应该待在稳定的领域边界之内,而不是散落在 Interface 和 Infrastructure
- 用测试保护重构:遗留系统先固定行为(characterization test),再改结构,别一次性重写二十处然后指望测试告诉你哪儿坏了
- Code Review 五问:改一个规则要动几处?它们为什么一起变?这知识归谁?有没有复制业务判断?新需求是不是都在加新的 if?
- 当霰弹跨越服务边界:跨服务没有原子提交、没有编译器帮你找调用点,硬套单体办法会出事。思路从"收成一个修改点"转为"建权威来源 + 兼容滚动":共享契约库治数据结构散落,策略服务/配置中心治业务规则散落,改契约只能向后兼容分阶段切,而且要承认——有时候各服务各管各的才是对的,硬抽共享库会制造分布式单体
一条权限规则,admin 和 operator 能管理通话。某天产品说:supervisor 也要能管。
听起来是五分钟的活。结果你打开项目一搜,这个判断散落在十几个文件里:service_a.go、handler_x.go、middleware.go……改到第八个的时候你已经分不清哪些改过、哪些没改。上线之后用户报障:有的入口 supervisor 能管通话,有的不能——因为你漏了一处。
这就是霰弹式修改(Shotgun Surgery):改动一个概念,子弹却打得满屏都是。它是一种非常典型的代码异味(Code Smell,指结构上有问题、但当下还没报错的代码)。
它的根因不是"代码写得多"这么简单,而是:
一个概念的知识,被分散地复制到了很多个地方。
这篇讲清楚三件事:它长什么样、为什么会这样、怎么治。核心结论先放这儿——治理的目标不是"让代码只出现一次",而是"让一个变化原因只有一个主要修改点"。 这两句听起来像,其实差得很远,后面会讲为什么。
现象:改一处规则,动十几个文件
回到开头那个例子。项目里到处是这样的判断:
if user.Role == "admin" || user.Role == "operator" {
    ...
}
现在要加上 supervisor,你必须打开:
service_a.go
service_b.go
service_c.go
handler_x.go
handler_y.go
middleware.go
...
更糟的是人改东西会累、会分神,于是很容易出现:
A 改了
B 改了
C 忘了
D 改错了
结果系统里同一条业务规则,在不同地方表现不一致。这种 bug 最难查——因为它不是"错了",是"有的地方对、有的地方错",复现要靠运气。
记住这个判断信号:一个需求下来,你得靠 grep 找出所有要改的地方,再逐个改、最后祈祷没漏——只要进入"祈祷"这一步,基本就是霰弹式修改了。
第一步:把"变化"集中起来
Martin Fowler 对这类问题的核心思想其实非常朴素:
把经常一起变化的东西放在一起。
不要让这个判断到处出现:
if user.Role == "admin" || user.Role == "operator" {
    ...
}
而是收进一个有名字的函数:
func CanManageCall(user User) bool {
    return user.Role == "admin" ||
        user.Role == "operator"
}
业务代码只负责问它一句话:
if CanManageCall(user) {
    ...
}
以后要加 supervisor,只改一个地方:
func CanManageCall(user User) bool {
    return user.Role == "admin" ||
        user.Role == "operator" ||
        user.Role == "supervisor"
}
修改点从 N 个变成 1 个。这就是最基本的变化局部性(Change Locality):让一个变化尽量被关在一小块地方。
到这儿你可能觉得问题解决了。但接下来才是真正容易踩坑的地方。
别看到重复就抽象
这一点我见过太多人栽跟头,包括我自己。
有两段代码,长得一模一样:
// A
if user.Role == "admin" || user.Role == "operator" {
    ...
}

// B
if user.Role == "admin" || user.Role == "operator" {
    ...
}
手一痒就想抽成一个函数。但假如:
A 是"管理会议"
B 是"查看会议"
那它们恰恰不应该抽象成一个函数。因为它们现在碰巧一样,但未来会往不同方向变——哪天"查看会议"要放开给更多角色,而"管理会议"不变,你就得把它们再拆回来,而且拆的时候八成会改出 bug。
所以判断标准不是:
"代码是不是重复?"
而应该问:
"这些代码是不是因为同一个业务原因而变化?"
这其实比 DRY(Don't Repeat Yourself,不要重复自己)更重要。DRY 盯的是"文本上的重复",而真正该盯的是"变化原因上的重复"。两段代码长得一样但会因为不同原因而变,它们是偶然重复,强行合并反而制造了耦合;两段代码因为同一条规则而存在,哪怕长得不太一样,也该收到一起。
用"变化原因"划分代码
一条业务规则,经常会从入口一路穿到存储,在每一层都留下一个判断:
REST handler
    ↓
service
    ↓
DAO
    ↓
background job
    ↓
CLI
规则一变,这几处全得动:改 handler、改 service、改 DAO、改 job、改 CLI。这就是典型的霰弹式修改——同一条规则被每一层各自"知道"了一遍。
更好的结构是让规则只有一个拥有者,各层去调用它:
                    Business Rule
                         │
                    Domain Service
                   /       |       \
               API       Job       CLI
规则集中在领域服务里:
type CallPolicy struct {
}

func (p CallPolicy) CanTransfer(call Call, user User) bool {
    ...
}
外围的 API、Job、CLI 都只负责把请求翻译过来、调用 CanTransfer,自己不碰规则本身。
本质:霰弹式修改是"知识泄漏"
这是我认为最值得停下来想的一点。
一个判断:
if status == "ACTIVE" && retryCount < 3 {
    ...
}
它可能出现在 A.go、B.go、C.go、D.go 四个文件里。
表面问题是"重复"。但真正的问题是:
系统里有 4 个地方"知道"这条重试规则。
        retry policy
             │
      ┌──────┼──────┐
      ↓      ↓      ↓
      A      B      C
这几个地方各自握着一部分业务知识。理想情况应该是只有一个地方拥有它,其余的去问它:
             retry policy
                  │
             RetryPolicy
          ┌───────┴───────┐
          ↓               ↓
          A               B
所以重构的时候,别只想着"怎么减少代码",而要想:
"这个知识应该由谁拥有?"
这个视角一换,重构质量会高很多。减代码是结果,明确归属才是目的。
动手之前,先画一张 Change Map
接手一个大型项目,我不建议一上来就重构——你还没摸清哪些修改是合理的、哪些是病。先做一张 Change Map(变化地图):挑一条典型需求,把它要改的地方全找出来,再判断。
比如需求是:
"改一下 SIP REFER 的处理逻辑。"(REFER 是 SIP 协议里发起呼叫转接的一种请求)
先搜相关关键词:
REFER
Refer
Transfer
transfer
blindTransfer
attendedTransfer
然后把命中的文件按职责归拢:
SIP Handler
    ├── refer_handler.go
    ├── transfer.go
    └── dialog.go

Business
    ├── call_service.go
    ├── transfer_service.go
    └── permission.go

State
    ├── call_state.go
    └── dialog_state.go

Tests
    ├── refer_test.go
    ├── transfer_test.go
    └── call_test.go
然后问一句:为什么一个 REFER 需求要改这么多地方?
如果命中的是这样——
refer_handler.go       ← SIP 协议层
transfer_service.go    ← 业务层
call_state.go          ← 状态
permission.go          ← 权限策略
那这些修改很可能是合理的,因为它们分属不同职责,一个转接需求本来就要动协议、业务、状态、权限。
但如果命中的是这样——
refer_handler.go
foo.go
bar.go
baz.go
util.go
helper.go
another_helper.go
而它们都在判断同一个 if x == ...,那大概率就是霰弹式修改了。Change Map 的作用,就是帮你把"合理的分层穿透"和"病态的散弹"区分开。
把重构目标量化成 N → 1
重构这事最怕"凭感觉"。你可以把目标量化:
现在改一个业务规则要动 12 个文件;目标是改 1 个核心实现,测试覆盖其余调用者的行为。
改之前
Feature X
 ├── handler.go
 ├── service.go
 ├── worker.go
 ├── scheduler.go
 ├── api.go
 ├── util.go
 └── config.go

要改 7 个地方
改之后
Feature X
 ├── handler.go ─────┐
 ├── worker.go ──────┤
 ├── scheduler.go ───┤
 │                   ↓
 └────────────── FeaturePolicy
                       │
                       ↓
                   Rule Engine
改业务规则,只碰 FeaturePolicy 一处。从 7 到 1,这就是可以写进 commit message、可以在评审里讲清楚的收益。
改很多层,不一定是坏事
这一点尤其容易误判,矫枉过正反而坏事。
一个真实的需求:
"增加 SIP REFER 支持,要求有权限控制、事务管理、状态机和审计。"
那么修改穿透各层:
SIP Layer
     ↓
Application Layer
     ↓
Domain Layer
     ↓
Persistence
     ↓
Audit
这完全正常。一个功能本来就涉及协议、应用、领域、存储、审计五个关注点,每层各改一处,是合理的分层协作,不是霰弹。
真正的问题是另一种形态:
一个业务概念
      ↓
在同一层的很多无关地方重复出现
比如:
10 个 handler
20 个 service
5 个 worker
都自己在判断:
if role == ...
if status == ...
if featureFlag == ...
判据很简单:穿透不同职责的层是健康的,在同一职责里被复制 N 份才是病。 别把前者当后者去"治",否则你会为了消灭重复而把清晰的分层搅成一团。
给业务规则划一条"变化边界"
对大型项目,我习惯把代码分成四层,并给变化划一条边界:
┌─────────────────────────────┐
│         Interface           │
│ HTTP / SIP / CLI / MQ       │
└──────────────┬──────────────┘
               ↓
┌─────────────────────────────┐
│       Application           │
│ use case / orchestration    │
└──────────────┬──────────────┘
               ↓
┌─────────────────────────────┐
│          Domain             │
│ policy / state / rule       │
└──────────────┬──────────────┘
               ↓
┌─────────────────────────────┐
│       Infrastructure        │
│ DB / Redis / HTTP / Kafka   │
└─────────────────────────────┘
核心原则:
变化频繁的业务规则,应该尽量待在稳定的领域边界之内,而不是散落在 Interface 或 Infrastructure 里。
反例是让 SIP handler 自己决定业务规则——协议层一边解析报文,一边判断权限、状态和开关:
func HandleRefer(req SIPRequest) {
    if role != "admin" &&
        call.State != "CONNECTED" &&
        featureFlag != true {
        ...
    }
}
应该让协议层只做翻译,把判断交给领域服务:
func HandleRefer(req SIPRequest) {
    cmd := ParseRefer(req)

    result := transferService.Execute(cmd)

    return ToSIPResponse(result)
}
规则待在它该待的地方:
func (s *TransferService) Execute(cmd TransferCommand) Result {
    if !s.policy.CanTransfer(...) {
        ...
    }

    ...
}
这样 SIP 层就不会"拥有"转接策略。协议会换(SIP 换成别的信令),但转接规则不会跟着协议变——把规则放在稳定的那一层,它就不会被每个新入口再抄一遍。
用测试给重构兜底
霰弹式代码最怕的,就是直接上手大规模重构。相对安全的步骤是:
发现重复规则
      ↓
先补 characterization test(固化现有行为的测试)
      ↓
锁住"当前到底是什么行为"
      ↓
提取核心规则
      ↓
让旧代码改成调用核心规则
      ↓
删掉重复逻辑
      ↓
跑完整测试
对遗留系统,一句话:
先固定行为,再改变结构。
characterization test(表征测试)不关心"行为对不对",只关心"行为是什么"——哪怕现在的逻辑是错的,也先把它原样固化下来,这样你重构时才知道有没有把行为改变了。
千万别反过来:
发现 20 个地方重复
        ↓
全部重写
        ↓
指望测试告诉你哪里坏了
遗留系统往往测试本就不全,这么干等于蒙眼拆弹。
一份能照着念的 Code Review 五问
做设计评审或代码评审时,这五个问题很好用,照着念就行。
① 改一个业务规则,要改几个地方?
1       👍
2~3     可以接受
10+     ⚠️
不是绝对标准,但非常好用——一超过阈值,就该停下来问为什么。
② 这些地方为什么一起变?
如果答案是"因为它们都实现了 XXX 规则",考虑抽象;如果答案是"碰巧一样但原因不同",那就别合并(见前面"别看到重复就抽象")。
③ 这个业务知识归谁拥有?
如果答不上来"这条规则到底属于谁",通常就是设计问题——没有拥有者的规则,迟早会被复制。
④ 有没有在复制业务判断?
同一个 if status == ... 在好几个文件里出现,尤其要警惕。
⑤ 新需求是不是在不断增加新的 if?
这是最强的信号。如果每个新需求都是:
+ if xxx {
+ }
而且分布在 A、B、C、D 几个地方,那系统很可能已经在往霰弹式修改上滑了。
当霰弹跨越了服务边界
前面那套办法——抽函数、收进领域服务、画 Change Map、把目标量化成 N→1——有一个默默成立的前提:这些修改点在同一个代码库里,你能一次提交、一次编译、一次上线把它们全改完。
可现实里更难受的情况是:同一条规则散落在多个服务、多个仓库之间。订单服务、风控服务、通知服务,各自硬编码了一份"VIP 用户的判定标准";或者同一个消息体的字段约定,被五个服务各自解析、各自假设。这时候你再想"收成一个修改点",会发现根本收不动。
因为跨服务意味着你丢掉了三样东西:
| 单组件内 | 跨多个服务 / 仓库 | |
|---|---|---|
| 原子提交 | 有,一次改完 | 没有,各服务各自发布 |
| 编译器找调用点 | 有,改错了编译不过 | 没有,靠 grep + 文档 + 运气 |
| 同时生效 | 能保证 | 不能,必然有一段过渡期 A 新 B 旧 |
硬把单体内的办法套过来,最典型的翻车是:你改了共享规则,先上线了服务 A,服务 B 还没发——这段时间里 A 按新规则、B 按旧规则,线上就是不一致。单体里编译器会逼你一次改全,分布式里没人逼你,全靠纪律。
所以跨服务的治理换了个目标。单体内追求"收成一个修改点",跨服务做不到也不该强求——你没法把三个团队的三个仓库合并成一个函数。跨服务追求的是两条:
第一,让这份共享知识有一个权威来源(single source of truth),其他服务去消费它,而不是各自抄一份。 第二,改它的时候必须能兼容地、分步地滚动,而不是指望所有服务同时切换。
落到具体手段,大致是这几类。
1. 共享契约库:治"数据结构 / 枚举"的散落
如果散落的是数据结构或协议约定——消息体字段、状态枚举、错误码——别让每个服务各自定义一份。把它抽成一个版本化的共享契约:
- 用 Protobuf / OpenAPI 之类的 schema 定义一次,各服务从同一份 schema 生成代码。schema 改了,各服务重新生成,字段对不上的地方编译期就暴露——这等于把跨服务丢掉的"编译器找调用点"部分地找回来了。
- 或者抽成一个版本化的内部库(
common-types、xxx-contract),各服务用包管理器依赖它。
要点是版本化:共享库必须能多版本共存,因为服务 A 升到 v2 的时候,服务 B 可能还在 v1。没有版本管理的共享库,会从"治散落"退化成"所有服务被同一个库绑死,一改全崩"——那是另一种灾难。
2. 策略服务 / 配置中心:治"业务规则"的散落
如果散落的是业务规则本身——鉴权策略、风控阈值、功能开关(feature flag)——共享库还不够,因为规则会频繁变,你不想每改一次阈值就让五个服务重新发版。这时候把规则从代码里挪到运行时:
- 策略服务(Policy Service):把"谁能转接通话""VIP 怎么判定"做成一个服务,其他服务调用它来问,而不是自己判断。好处是规则真正只有一个拥有者;代价是多一跳网络调用、多一个要高可用的依赖。
- 配置中心:阈值、开关这类放进配置中心,各服务订阅同一份配置。改一次,所有服务生效,不用发版。
这其实就是前面"把规则收进领域服务"在分布式下的延伸——只不过领域服务从一个进程内的对象,变成了一个独立的服务或一份集中配置。
3. 扩展优于修改:跨服务改契约的唯一安全姿势
单体里我们用 characterization test 兜底,跨服务的兜底则是另一条铁律:向后兼容,分阶段滚动,永远不要指望原子切换。
具体说,改一个跨服务契约时:
- 加字段,别改字段。 加一个新字段是兼容的(老服务忽略它),改一个旧字段的含义是要命的(老服务会误解)。
- 双写双读过渡。 要替换一个字段,先让生产方同时写新旧两份,等所有消费方都切到读新字段,再撤掉旧字段。中间可能要过好几周,别嫌慢。
- 消费方先行。 发布顺序上,通常让"能同时接受新旧两种格式"的消费方先上线,生产方再切——这样任何时刻都不会出现"生产方发了新格式、消费方还不认"的窗口。
一句话:跨服务没有"改完"这个瞬间,只有"滚动完"这个过程。 把每一次契约变更都当成一次灰度发布来设计。
4. 承认:有时候"散落"恰恰是对的
这一条最反直觉,但对微服务尤其重要。
微服务的本意,就是让每个服务拥有自己的业务逻辑。如果你看到两个服务里有相似的判断,就手痒抽一个共享库强制它们统一——你可能正在亲手制造一个分布式单体(distributed monolith):表面上是一堆独立服务,实际上被共享库死死绑在一起,改一行共享代码要协调五个团队同时发版,拿到了微服务的所有运维成本,却丢掉了独立演进的唯一好处。
所以跨服务抽象之前,判断标准比单体内还要严一档:
- 是不是真正的同一个概念? "订单服务的 VIP 判定"和"营销服务的 VIP 判定",名字一样,但可能是两个 bounded context(领域边界)里的两个概念,未来会各自演化。这种情况下,各自拥有一份反而是对的。
- 它属于哪个服务的核心域? 如果这条规则明显是某个服务的职责,那就让它拥有这条规则,其他服务通过 API 问它,而不是抽到一个谁都不拥有的共享库里。共享库最怕的就是"三不管地带"——没有明确 owner 的共享代码,最后会烂得比散落更快。
一句话收这一节: 单体内,治霰弹是"把知识收拢到一个拥有者";跨服务,治霰弹是"给知识指定一个拥有的服务,其余的去问它,并且用兼容滚动代替原子修改"。而在动手之前,先确认这真是"一个概念被抄了多份",而不是"多个服务各自拥有一个长得像的概念"——后者不该被统一。
总结:不求代码只出现一次,只求一个变化只有一个修改点
把全文浓缩成一句工程原则:
不要追求"代码只出现一次",而要追求"一个变化原因只有一个主要修改点"。
这三层是递进的:
- DRY:减少重复代码——这是最表层,也最容易用错(偶然重复不该合并)。
- Change Locality:减少一个需求的修改范围——盯的是"变化",不是"文本"。
- Single Source of Business Knowledge:让每条业务规则只有一个真正的拥有者——盯的是"知识归属"。
最终想达到的是这样的改动体验:
需求变化 → 找到一个明确的业务概念 → 改一个核心位置 → 自动化测试验证所有调用者
而不是这样:
需求变化 → grep → grep → grep → 猜 → 改 → 改 → 改 → 祈祷没漏
单组件内也好,跨服务也好,治理霰弹最后都收敛到同一个词——归属。单体内是"把知识收拢给一个拥有者",跨服务是"给知识指定一个拥有的服务,其余的去问它"。差别只在于:进程内你能靠编译器和原子提交一次改完,跨进程你得靠共享契约、权威来源和兼容滚动,一步步把子弹收回枪膛。
最后留一句给做大型后端和通信系统(SIP、FreeSWITCH、Redis、K8s 这类)的同行:很多被叫作"霰弹式修改"的东西,往回刨一层,其实是领域逻辑泄漏到了 Handler / Adapter / Utility 层。所以治理它,往往不是去消灭重复,而是回答三个归属问题——业务规则归谁拥有?状态机归谁拥有?协议层和业务层怎么隔离? 把这三个问题答清楚,无论规则是散在一个服务里,还是散在十个服务之间,你都知道该往哪儿收。
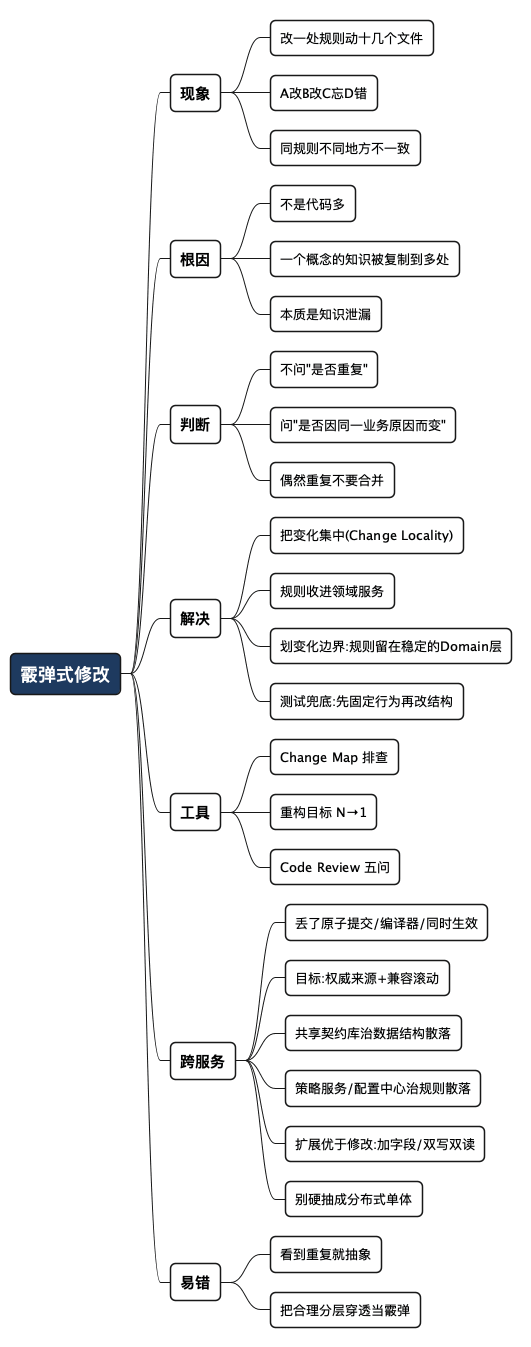
全文思维导图
@startmindmap
<style>
mindmapDiagram {
  node {
    BackgroundColor #F8F9FA
    RoundCorner 10
    Padding 10
    FontSize 13
  }
  :depth(0) {
    BackgroundColor #1E3A5F
    FontColor white
    FontSize 18
    FontStyle bold
  }
  :depth(1) {
    FontSize 15
    FontStyle bold
  }
  :depth(2) {
    FontSize 13
  }
}
</style>

* 霰弹式修改
** 现象
*** 改一处规则动十几个文件
*** A改B改C忘D错
*** 同规则不同地方不一致
** 根因
*** 不是代码多
*** 一个概念的知识被复制到多处
*** 本质是知识泄漏
** 判断
*** 不问"是否重复"
*** 问"是否因同一业务原因而变"
*** 偶然重复不要合并
** 解决
*** 把变化集中(Change Locality)
*** 规则收进领域服务
*** 划变化边界:规则留在稳定的Domain层
*** 测试兜底:先固定行为再改结构
** 工具
*** Change Map 排查
*** 重构目标 N→1
*** Code Review 五问
** 跨服务
*** 丢了原子提交/编译器/同时生效
*** 目标:权威来源+兼容滚动
*** 共享契约库治数据结构散落
*** 策略服务/配置中心治规则散落
*** 扩展优于修改:加字段/双写双读
*** 别硬抽成分布式单体
** 易错
*** 看到重复就抽象
*** 把合理分层穿透当霰弹
@endmindmap
本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可。 欢迎在我的个人网站 https://www.fanyamin.com 访问原文并评论。